當我第一次聽到語義 ID 時,我感到非常著迷。這個概念很簡單:與其為影片、歌曲或產品使用隨機的雜湊 ID,我們可以使用大型語言模型(LLM)能原生理解的語義符記。我好奇,我們能否在豐富的行為資料上訓練一個 LLM-推薦系統混合模型,這些資料正是當今推薦系統如此有效的原因?
令我驚訝的是,我們確實可以!其成果是一個語言模型,它能同時以英文和商品 ID 進行對話,不是透過檢索或其他工具,而是一個單一的「雙語」模型,其中商品(即語義 ID)是其詞彙表的一部分。就像推薦模型一樣,它能根據歷史互動推薦商品。但最大的驚喜,也是能力上的突破,是我發現我可以簡單地與模型聊天來引導其推薦,它也能推理其選擇、提供解釋,並創造性地命名產品組合。
這是一個示範影片。這裡有準備資料、訓練模型和與其聊天的程式碼。(請注意:這是一個小型模型,僅進行了非常基本的微調,因此提示詞的設計非常重要。此外,由於微調的限制,它不像大多數大型語言模型那樣通用和穩健。)
等等,這有什麼用?
這結合了推薦系統和語言建模的最佳優勢。一方面,語言模型擁有世界知識,可以流暢地談論產品,但卻不了解我們的商品目錄。此外,它們的推薦是通用的,並受熱門度偏差的影響。反之,搜尋和推薦模型是根據我們的商品目錄和數十億使用者互動進行訓練的。它們擅長預測使用者下一步會點擊或購買什麼,但無法透過自然語言引導或推理其選擇。(不過,它們的共同點是都從序列中學習。)
為此,我們首先使用 <|sid_0|>、<|sid_1|>、<|sid_2|> 等語義 ID 符記來擴展語言模型的詞彙表。這些符記用於表示商品目錄。然後,我們應用持續預訓練來教導模型語義 ID 和商品目錄之間的關係,再進一步根據使用者行為序列進行微調。這些步驟共同教導模型根據使用者偏好從我們的商品目錄中進行推薦。
儘管這種 LLM-推薦系統混合模型可能無法與專門的多階段推薦系統的原始精準度相匹配,但它提供了一項新功能:推薦的可控性和推理能力。其結果是搜尋、推薦和聊天之間統一的體驗,讓使用者只需透過提問即可在我們的商品目錄中找到他們需要的東西。
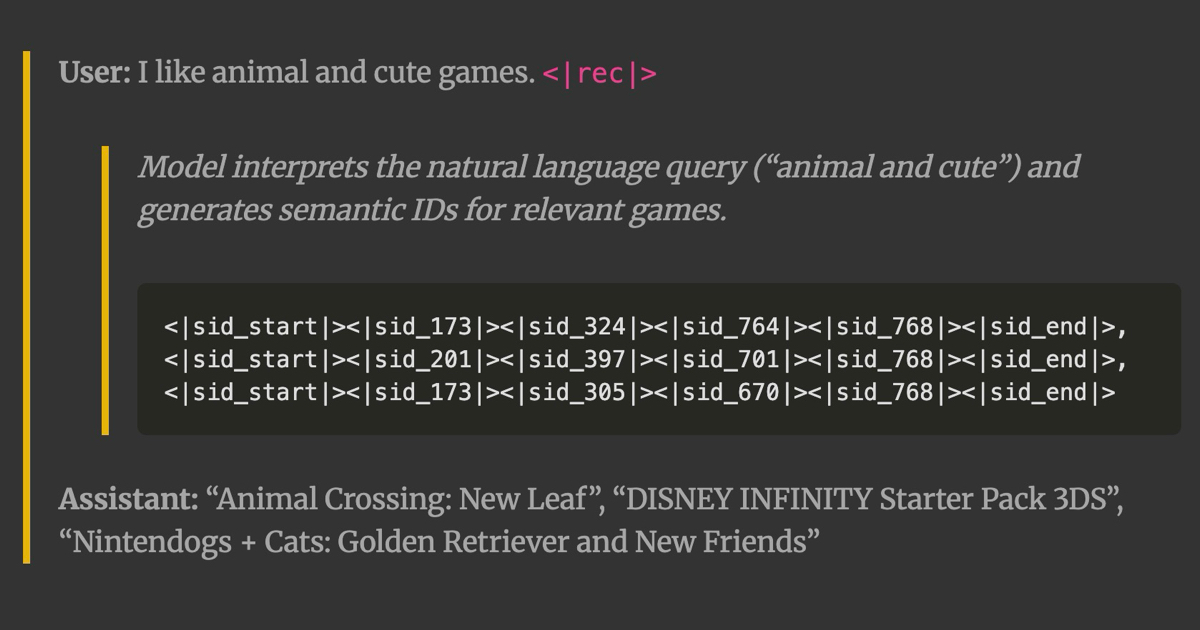
> 使用者: 我喜歡動物和可愛的遊戲。<|rec|>
>
>
>> _模型解釋自然語言查詢(「動物和可愛」)並生成相關遊戲的語義 ID。_
>>
>>
>>
> ```
> <|sid_start|><|sid_173|><|sid_324|><|sid_764|><|sid_768|><|sid_end|>,
> <|sid_start|><|sid_201|><|sid_397|><|sid_701|><|sid_768|><|sid_end|>,
> <|sid_start|><|sid_173|><|sid_305|><|sid_670|><|sid_768|><|sid_end|>
> ```
>
>
> 助理: 「集合啦!動物森友會」、「迪士尼無限世界 3.0:星際大戰入門包 3DS」、「任天狗狗 + 貓貓:黃金獵犬與新夥伴」
資料與模型
尋找同時包含商品元資料和使用者序列的訓練資料
我們將使用來自 Amazon Reviews 2023 (Hou et al., 2024) 視訊遊戲類別的資料。該資料包含豐富的產品元資料,我們可以從中建立使用者互動序列。
該資料集包含 13.7 萬個產品,每個產品都有標題、描述、功能、類別、商店資訊、評分、價格等欄位。在僅保留標題長度超過 20 個字元且描述長度超過 100 個字元的產品後,我們剩下 6.6 萬個產品。行為資料包含 73.7 萬條記錄。從中,我建立了 7.9 萬個使用者購買序列,每個序列至少包含三個有效商品。這些序列的平均長度為 6.5 個商品。
我也考慮了 Amazon KDD Cup 2023 資料 (Amazon, 2023)。
它有 50 萬個商品,並著重於序列行為資料。然而,其多語言性質增加了複雜性,且缺乏產品類別欄位使其難以處理。最終,我選擇了 Amazon Reviews 資料集,以求簡化並節省我的運算預算。
來自 RQ-VAEs 的語義 ID
語義 ID (Rajput et al., 2023;Singh et al., 2023) 是階層式表示,它將商品編碼成符記序列,取代嵌入或基於雜湊的 ID。
與沒有固有意義的傳統商品 ID (B0040JHNQG) 不同,語義 ID (<|sid_0|><|sid_256|><|sid_512|><|sid_768|>) 編碼了商品資訊。由於訓練過程,相似的商品自然會共享共同前綴,形成樹狀結構,其中 ID 的每個層級代表越來越細緻的商品資訊。
!Image 1: Image
食物影片語義 ID 的階層式結構 (來源)
殘差量化變分自編碼器 (RQ-VAEs;Zeghidour et al., 2021, Lee et al., 2022) 是我們用於將連續嵌入轉換為離散語義 ID 的方法。
我們首先將商品的元資料(例如標題、描述)編碼成嵌入。RQ-VAE 隨後使用階層式量化將此嵌入轉換為離散符記序列。
!Image 2: Image
RQVAE 如何將嵌入轉換為語義 ID (來源)
這是一個迭代過程。對於第一個層級,模型在第一個碼本中找到最接近輸入嵌入的向量;此向量成為語義 ID 的第一個符記。然後,模型透過從輸入嵌入中減去選定的碼本向量來計算量化誤差,即_殘差_。對於第二個層級,它在第二個碼本中找到最接近此殘差的向量,這給了我們第二個符記。這個過程對每個層級重複進行,每個步驟都捕捉到前一層級遺漏的漸進更精細的細節。
RQ-VAE 的損失函數值得討論,因為理解它對於生成高品質語義 ID 至關重要。總體損失有兩個主要組成部分:
第一個組成部分,重建損失,確保解碼器可以從最終量化表示 () 準確重建原始商品嵌入 ()。這是一個標準的平方誤差損失:
第二個組成部分,量化損失,衡量碼本向量與編碼器生成的殘差匹配的程度。它包含兩個項:
第一項 (,碼本損失,負責訓練碼本嵌入。它衡量編碼器的殘差 () 與選定碼本向量 () 之間的距離。梯度停止應用於編碼器的輸出 (),將殘差視為固定目標。因此,梯度僅流向碼本向量,使其更接近編碼器的輸出。
第二項 (),承諾損失,負責訓練編碼器。它衡量相同的距離,但梯度停止應用於碼本向量 ()。這會停止對碼本的更新,並強制編碼器產生輸出,或_承諾_,已經在碼本中的向量。超參數 控制此承諾懲罰的強度。
```
Pytorch code for loss function (without recursive loop)
reconstruction_loss = F.mse_loss(x, x_reconstructed)
codebook_loss = F.mse_loss(residual.detach(), codebook_vector)
commitment_loss = F.mse_loss(residual, codebook_vector.detach())
quantization_loss = codebook_loss + commitment_weight * commitment_loss
total_loss = recon_loss + quantization_loss
```
透過這個過程,RQ-VAE 生成一個語義 ID 作為符記序列,每個量化層級一個。由於相似的商品共享共同前綴,語言模型可以更好地理解產品關係,這對於基於樹的檢索也很有用。
```
How to hierarchically encode embeddings to semantic IDs
def encode_to_semantic_ids(self, x: Tensor) -> Tensor:
with torch.no_grad():
residual = self.encode(x)
indices_list = []
for vq_layer in self.vq_layers:
vq_output = vq_layer(residual)
indices_list.append(vq_output.indices)
residual = residual - vq_output.quantized
return torch.stack(indices_list, dim=-1)
```
儘管如此,一個實際的挑戰是這不能保證每個商品都有唯一的 ID。在我的三層碼本實驗中,每個層級有 256 個碼,我們在約 10% 的 6.6 萬個產品上看到了衝突。為了解決這個問題,我添加了第四個層級,其中我為每個 ID 附加了一個依序遞增的符記,以確保每個產品都是唯一可識別的。
SASRec、Qwen3-Embedding-0.6B 和 Qwen3-8B
除了 RQ-VAE,我們還使用了另外三個模型。首先,我們將在語義 ID 上訓練一個 SASRec,以驗證其品質並將其與商品 ID SASRec 基準進行比較。然後,我們使用 Qwen3-Embedding-0.6B 模型將產品元資料編碼為嵌入。最後,我們微調 Qwen3-8B 模型,使其能夠透過語義 ID 理解和推薦商品。
SASRec (Kang & McAuley, 2018) 是一種受 Transformer 架構啟發的序列推薦器。
它編碼使用者的互動歷史,並使用自注意力機制權衡最相關的過去商品,以預測下一個商品。這使得模型能夠學習使用者行為中的長期依賴關係,從而超越 RNN 和 GRU 等較舊的循環模型,同時由於其可並行化性質而更高效。
Qwen3-Embedding-0.6B (Zhang et al., 2025) 是一系列嵌入模型的一部分,提供 0.6B、4B 和 8B 尺寸。它們透過多階段流程進行訓練,包括在合成資料上進行預訓練,然後進行監督式微調和模型合併以提高穩健性。8B 模型在 MTEB 多語言基準測試上實現了最先進效能 (SOTA)。
Qwen3-8B (Yang et al., 2025) 是 Qwen3 系列中的一個密集語言模型。儘管是較小的模型之一,但其後訓練透過對 Qwen3-235B-A22B 和 Qwen3-32B 進行強到弱蒸餾而得到優化。
這使得 Qwen3-8B 相對於其尺寸而言相對強大,在超過一半的評估基準上超越了 Qwen2.5-14B 等更大的前一代模型,尤其是在科學、科技、工程、數學 (STEM) 和編碼方面。與 Qwen3 系列中的其他模型一樣,Qwen3-8B 具有雙重思考和非思考模式。
清理資料並建立使用者序列
首先,我們準備商品元資料,以確保語義 ID 模型的高品質輸入。我們首先排除標題少於 20 個字元或描述少於 100 個字元的商品。這將商品數量減少了一半,


