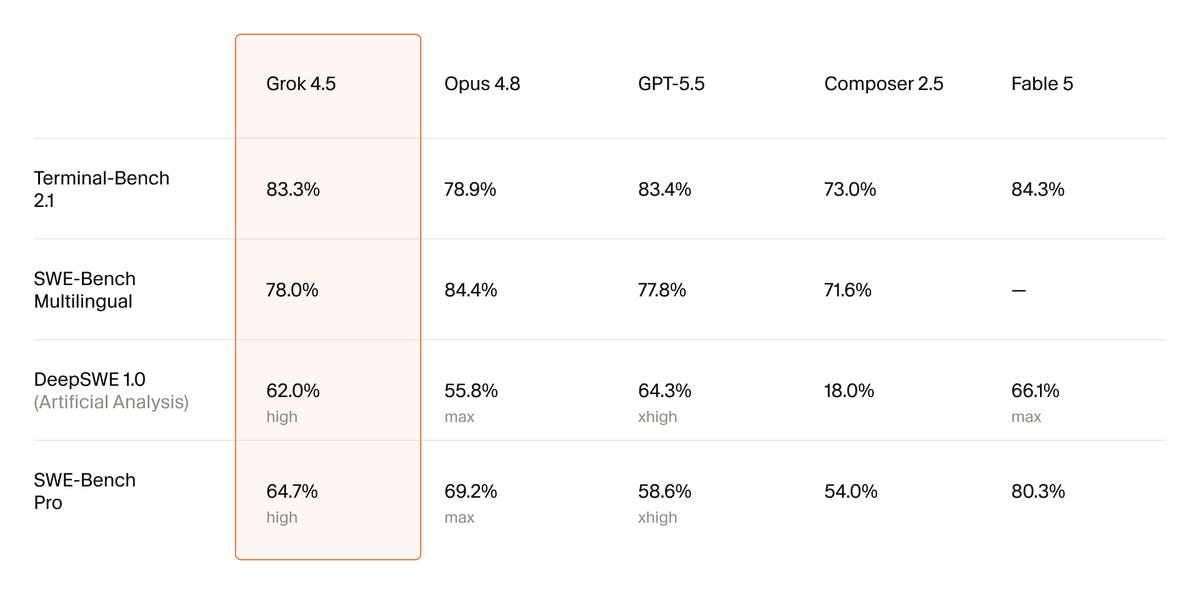
隨著 GPT 5.6 預計於明日發布,今日可說是 GPT 5.5 等級模型發布的最後一個引人注目的日子,而這正是 SpaceXAI 所做的事。Cursor 宣布與 SpaceXAI 合作訓練 Grok 4.5,稱其為迄今最強大的模型,也是他們首次為軟體工程以外的領域打造的模型。
全新的 Grok 4.5 與 Composer 系列(1.5 兆參數)屬於不同量級。儘管評估結果表現穩健,其效能仍與目前的主力模型 Opus 和 GPTs 相當。OpenAI 的評估團隊指出,即使是強大的 SWE-Bench Pro 也已達到飽和或存在根本缺陷,這使得繼任者名單可能只剩下少數幾個,包括 FrontierCode。關於訓練和數據披露,目前僅有這些資訊。
xAI(SpaceXAI)公開推出了 Grok 4.5,這是一款專注於程式碼和代理的新一代模型。其定位是提供「每美元能力」而非追求絕對的基準測試霸主地位。Elon Musk 最初根據強大的測試反饋表示 Grok 4.5 將於「明日」公開,並稱其為「Opus 級」,但速度更快、代幣效率更高且成本更低。
Musk 後來在內部將 Grok 4.5 定義為「大致與 Opus 4.7 相當,但速度快得多」,強調其對 Tesla 和 SpaceX 工程師的實用性,而非盲目追逐基準測試。xAI 的官方帳號發布了正式消息,稱 Grok 4.5 是「我們首款專為程式碼和代理訓練的模型」,與 Cursor 合作訓練,並提供「領先的速度和成本效益下的尖端智慧」。
Cursor 表示與 xAI 合作訓練 Grok 4.5,稱其為「迄今最強大的模型」,並強調這是「我們首次為軟體工程以外的領域打造的模型」。Cursor 也宣布 Grok 4.5 已在產品中可用,並提供「首週雙倍使用量」。Cursor 進一步澄清,Grok 4.5 和 Composer 屬於兩種不同的模型量級,Composer 2.5 將繼續提供,未來也會有更多屬於該較小量級的模型。
生態系支援立即出現:Grok 4.5 已在 Grok Build/API/Cursor 中可用,Hermes Agent 也宣布了首日支援,隨後確認在 Hermes Agent/Portal/OpenRouter/Grok 訂閱中提供即時可用性。Musk 表示,上下文視窗(context window)可能會在「下週」從 50 萬個代幣恢復到 100 萬個代幣。
官方層面,xAI 的訊息並非「最佳整體模型」,而是提供接近 Opus 的品質,同時具備顯著更優的經濟效益和速度。Elon Musk 稱其為「Opus 級模型,但更快、代幣效率更高且成本更低」。xAI 則表示這是「首款專為程式碼和代理訓練的模型」,提供「領先的速度和成本效益下的尖端智慧」。
Cursor 稱其為「迄今最強大的模型」,也是「首次為軟體工程以外的領域打造的模型」。這種定位至關重要:xAI 明確鎖定程式碼代理工作流程市場,而非僅僅是通用聊天,該市場近期一直由 Anthropic、OpenAI 和 Cursor 等工具型系統主導。
具體的數據也浮出水面:官方定價為每百萬輸入代幣 2 美元,每百萬輸出代幣 6 美元。Artificial Analysis 重申了相同的價格點,並補充說明:快取命中(cache hits)可享 75% 折扣,降至每百萬代幣 0.5 美元;超過 20 萬代幣的長輸入成本翻倍;上下文視窗為 50 萬代幣,低於 Grok 4.3 的 100 萬代幣;視覺輸入和可配置推理功能均保留。Musk 後來表示,上下文視窗可能很快就會升級回 100 萬代幣。
用戶引用的相對價格比較如下:Grok 4.5 為輸入 2 美元/輸出 6 美元;GPT-5.6 為輸入 5 美元/輸出 30 美元;Opus 4.8 為輸入 5 美元/輸出 25 美元。
透過第三方報導 Musk 的披露,一項重要規格浮出水面:Grok 4.5 的參數為 1.5 兆,比 Grok 4.3 大三倍。這是一個顯著的飛躍,很可能是許多觀察家將 4.5 解釋為 xAI 首次進入真正的旗艦級程式碼代理領域,而非僅僅是迭代更新的核心原因。
Artificial Analysis 在推文中提供了最實質的外部評估。主要結果顯示:在 Artificial Analysis 智慧指數中,Grok 4.5 以 54 分排名第四,僅次於 Fable 5、GPT-5.5 和 Opus 4.8。
與 Grok 4.3 相比,在相同指數上增加了 16 分。在 GDPval-AA v2 Elo 評分中,Grok 4.5 獲得 1543 分,同樣排名第四,僅次於 Anthropic 最新的 Claude 版本。在 τ³-Banking 測試中,Grok 4.5 獲得最高分 33%,高於 GPT-5.5 的 31%。
在 Grok Build 的 Artificial Analysis 程式碼代理指數中,Grok 4.5 獲得 76 分,「與 Codex 中的 GPT-5.5 相當」,但低於 Claude Code 中的 Fable 5。每項智慧指數任務的成本為 0.31 美元;每項 GDPval 任務的成本為 0.49 美元;每項程式碼代理指數任務的成本為 2.59 美元。
每項智慧指數任務的平均輸出代幣約 1.4 萬個,比 Opus 4.8 低 60% 以上。每項程式碼代理指數任務的平均總代幣為 190 萬個,而 Claude Code 中的 Fable 5 為 720 萬個,Codex 中的 GPT-5.5 為 620 萬個。
Artificial Analysis 的解讀很明確:Grok 4.5 在能力上接近尖端,但在效率方面異常強大,使其在成本/效能的帕累托前沿(Pareto frontier)上佔據一席之地。Musk 明確地放大了 Artificial Analysis 的這項評估。


