昨日 Kimi K3 的發布持續引發熱議。Databricks 成功完成 1880 億美元的 M 輪融資,而 OpenRouter 也可能被收購。
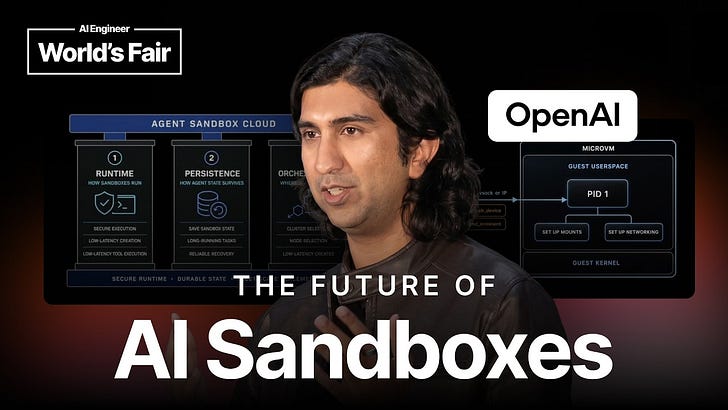
在新聞較少的一天,本週最受歡迎的演講是 Abhishek Bhardwaj 在 Sandbox 軌道的專題演講。他回顧了自其 Arrakis 專案讓他被 Greg Brockman 聘用以來一年的成長,目前正負責建構 ChatGPT Work 背後的雲端基礎設施。
如果認為執行代理沙盒只是「在 Kubernetes 上執行容器」,那可能過於關注運算問題,並低估了儲存和檔案系統的重要性。此外,AIE NYC 2026 的演講者申請已開放,特別歡迎在紐約從事 AI 領先工作,尤其是 AI 結合金融領域的人士。
這是 2026 年 7 月 16 日至 17 日的 AI 新聞,我們審查了 12 個 Reddit 子版塊、544 個 Twitter 帳號,但沒有進一步的 Discord 資訊。AINews 網站提供所有過往報導的搜尋功能,提醒您 AINews 現已成為 Latent Space 的一個專區,您可以選擇訂閱或取消電子郵件頻率。
Moonshot 的 Kimi K3 發布成為今日焦點,其推出引發了業界對中國開源模型與前沿技術差距的廣泛重新評估。許多評論認為 K3 是首個在此級別上真正實用的中國模型,在程式碼、代理能力和長程知識工作方面表現出色。
社群反應熱烈,從 Salakhutdinov 祝賀 Moonshot 創辦人楊植麟,到實務工作者直接表示「Kimi K3 真的非常棒」。一個重複出現的主題是,K3 縮小了足夠的差距,足以促使美國實驗室加快發布速度。
戰略論點從「算力護城河」轉向「效率堆疊」。一個值得注意的討論指出,K3 削弱了前沿能力主要受原始 FLOPs 限制的論點,反而強調 MoE 路由、量化、資料策展以及如 Moonshot「月餅」堆疊等稀缺資源驅動的基礎設施設計。
相關評論強調,中國實驗室可能正在壓縮「每 FLOP 能力」曲線,而非直接匹配西方的資本支出。更好的後訓練和轉換率可以非線性地縮小產品差距。
對於 K3 實際落後多少,業界仍存在分歧:有些人認為它已接近前沿,甚至在某些重要領域超越了特定的西方模型。而另一些人則認為,它在更廣泛的通用性、效率或隱藏評估方面仍落後數月。
儘管存在這些爭議,但實際共識是 K3 已不容忽視。
Artificial Analysis 和程式碼代理基準測試將 K3 穩固地置於頂級群組。Artificial Analysis 指出,在約六週內,其「智慧指數」超過 51 分的前沿實驗室從兩個擴展到六個,其中 Kimi K3 獲得 57 分,僅次於 Claude Fable 5 的 60 分,並領先 Opus 4.8 的 56 分。
在程式碼代理方面,AA 後來報告 K3 在其「程式碼代理指數」中獲得 57 分,與 GPT-5.6 Terra 和 GPT-5.5 持平,並領先 Opus 4.8。它在 Terminal-Bench v2 達到 84%,DeepSWE 達到 64%,SWE-Atlas-QnA 達到 23%。
關於成本的說法則褒貶不一:AA 稱其為前沿且相對高效;但 @theo 反駁說,代幣效率和吞吐量往往會抵消其相對於 GPT-5.6 Sol 的表面價格優勢。
K3 在前端和程式碼評估方面表現尤為強勁。Arena 報告稱,K3 首次讓中國在 Frontend Code Arena 上超越美國,使用者測試也證實 K3 在視覺化前端任務上可以超越或媲美 Fable。
在軟體工程方面,DataCurve 表示 K3 在 DeepSWE 上首次亮相即排名第三,稱其為首個在此領域達到前沿水準的開源模型。
ARC 和網路安全測試仍然是實用的現實檢驗。ARC Prize 證實 Thinking Machines 的 Inkling 現在是 ARC-AGI-1 (79.5%) 和 ARC-AGI-2 (36.5%) 上得分最高的開源模型,而關於 K3 的 ARC-AGI-2 分數仍在透過 BenchPress 估計進行猜測。
在網路安全方面,英國 AISI 相關討論指出 GLM-5.2 在「The Last Ones」上與 Opus 4.5 持平,而 OpenAI 聲稱 GPT-5.6 Sol 在該範圍內達到 SOTA。這強調了儘管差距正在縮小,但開源模型在長程網路安全方面似乎仍實質落後於最佳的閉源模型。
Kimi Delta Attention (KDA) 引起了嚴重的技術關注。@sdrzn 的一篇技術解釋強調 K3 使用 KDA 作為一種快速權重風格的記憶機制,有效地維持固定大小的學習式每請求狀態,而非在長上下文上支付完整的注意力成本。
據稱,這項技術在 1M 上下文長度下可實現高達 6 倍的更快/更便宜的吞吐量,並且在長上下文長度下定價保持更平穩。如果這些特性在更廣泛的部署中得以實現,這將是此次發布中更具影響力的架構級別創新之一。
服務和硬體討論隨之而來。人們已經在異構基礎設施上準備 K3 部署,例如透過 RoCE 連接的 4xH100 節點。華為的「950 SuperPoD」發布也為「中國 AI 堆疊在限制下擴展」的論述增添了動力。
在軟體方面,vLLM 對 AMD 的支援、Red Hat AI 在搭載 vLLM 的 DGX B200 節點上運行 Inkling,以及 vLLM 關於每月約 2,000 次提交下維持生產品質的說明,都是相關的基礎設施更新。
核心/效能工程仍然是一個差異化因素。K3 因其核心編寫和效能工程能力而屢獲讚譽,Moonshot 員工提供了與 kernelbench 相關的範例,社群評論也指出 K3 協助設計了 kernelbench.com 本身。
此外,Simran Arora 指出,AMD aiter 中的混合線性注意力、全模型巨型核心以及快速 MLA/DSV4 解碼核心,現在正直接推動前沿模型的開發。
價值正從基礎模型存取轉向工具鏈和工作流程。多篇文章指出,隨著前沿智慧變得更便宜、更開放,持久的護城河將轉移到編排、記憶體、工具和特定領域的鷹架(scaffolding)。
@jmorgan 和 @Yuchenj_UW 提供了很好的總結,後者將關鍵區別框架為「價值最大化」與「代幣最大化」。
記憶體架構正趨向於「維基記憶」。Paulius Ztin 的長篇文章是此處更具體的設計說明之一。該提案建議:代理應停止重複從原始文件中推導相同的理解,而是應在統一記憶體之上建立一個任務特定的 Markdown 維基層,並透過 FastMCP 進行同步。
Qdrant 分享了多租戶檢索的生產指南,後來強調 mem0 認為持續學習更多是記憶體問題,而非權重更新問題。
MCP 和技能抽象持續成熟。值得注意的產品更新包括 Perplexity Agent API 增加了自訂技能,Nous 推出了 Hermes Agent 桌面和 Unreal Engine 伴侶技能,以及 Tadas 與 Anthropic 的 Dom 提出的進階 MCP 使用模式。
在研究方面,MemoHarness 脫穎而出:它將代理工具鏈分解為六個可編輯的控制介面,並在 Shell-Agent 上報告 0.806 分,而最強的固定工具鏈基準為 0.722 分,同時降低了每個任務的成本。
模型的穩健性和偵測器限制:「穩健性幻覺」論文指出,總體準確性掩蓋了在不相關上下文下的預測翻轉。Epoch AI 報告稱,AI 偵測器通常對普通人類文本和簡單 AI 文本可靠,但被指示模仿特定作者的 LLM 可以規避偵測,科學寫作的誤報率約為 13% 和 26%。
具身和生物啟發式學習:NVIDIA 的 RoboTTT 將機器人策略上下文長度擴展了三個數量級,將操作性能比單步基準提高了 87%,並完成了一個五分鐘、十階段的組裝任務,這是任何基準模型都未能完成的。
同時,Sakana 的「Diffusing Blame」和 Hardmaru 的總結展示了在嚴格的 Dale's 原則下,無需標準反向傳播權重傳輸的競爭性學習。
可解釋性/表徵幾何:Elie Bakouch 在 Thinking Machines 的 Inkling 上複製了 Anthropic 風格的 j 空間分析,發現其在早期和後期層之間保持相似的幾何結構(早期-後期 CKA 約 0.8,而其他模型約 0.5),這很不尋常。
同一討論串報告稱,Poolside 的 Laguna XS 2.1 在 NVFP4 量化下,j 空間變化極小。
開源模型與閉源模型的經濟學:@AravSrinivas 將當前時刻比作 Sun Microsystems 被開源和商品硬體顛覆,認為本地/開源模型可能對現有企業產生類似的通縮效應。
美國政策影響:@DavidSacks 表示 K3 在 Frontend Code Arena 上排名第一,是對過度監管和資料中心限制的警告。
價格崩潰論述:@chamath 強調,極其便宜和極其昂貴的前沿代幣之間的價差正在擴大。
開源模型普及的影響:@shadcn 指出,曾經被視為政府敏感的能力,現在很快就能以商品價格提供給訂閱者。
前沿程式碼的現實:@datacurve 關於 K3 的 DeepSWE 結果和 @arena 的 Frontend Code Arena 領先變化,是此次發布超越社群炒作、真正具有重要意義的最明確基準信號。