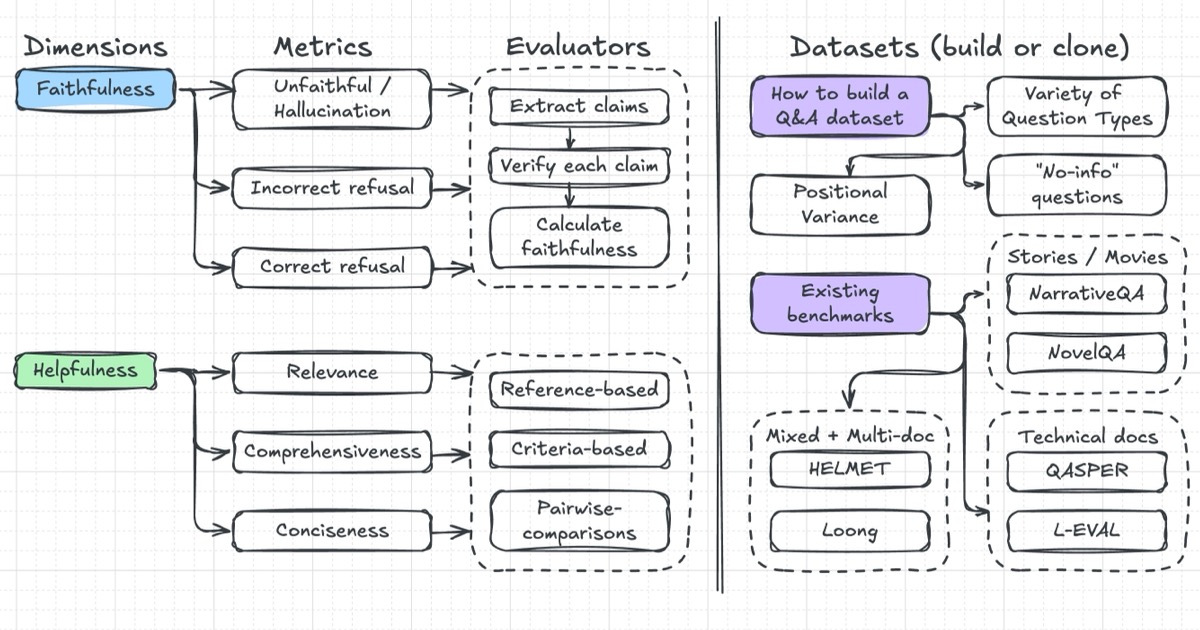
<h1>評估長上下文問答系統</h1><p>評估問答系統在短篇段落中相對簡單,但文件越長,複雜度也隨之增加。例如,技術文件、小說、電影,以及多文件情境。儘管其中一些評估挑戰也出現在較短的上下文情境中,但長上下文評估會放大以下問題:</p><ul><li><b>資訊過載:</b>大型文件中不相關的細節會掩蓋相關事實,使檢索器和模型更難找到正確的證據來回答問題。
</li><li><b>位置變異:</b>證據可能出現在文件的開頭、中間或結尾,這對有效上下文有限或容易出現「迷失在中間」問題的模型構成挑戰。</li><li><b>多跳推理:</b>正確答案取決於綜合文本中分散的幾個不同證據,挑戰了模型保留和整合相距遙遠資訊的能力。
</li><li><b>大規模幻覺:</b>更大的上下文增加了模型因檢索不佳或有效上下文有限而返回看似合理卻不正確回應的風險。</li><li><b>開放式問題:</b>針對廣泛主題或解釋性議題的查詢,很少有單一明確的答案,尤其對於大型文件或語料庫而言。
</li></ul><p>在本文中,我們將探討<a href="https://eugeneyan.com/writing/qa-evals/#key-evaluation-metrics">關鍵評估指標</a>、如何<a href="https://eugeneyan.com/writing/qa-evals/#building-an-evaluation-dataset">建構評估資料集</a>,以及透過人工標註和大型語言模型評估器<a href="https://eugeneyan.com/writing/qa-evals/#methods-to-assess-qa-performance">評估問答效能的方法</a>。
我們還將<a href="https://eugeneyan.com/writing/qa-evals/#what-we-can-learn-from-existing-benchmarks">回顧幾個基準測試</a>,涵蓋敘事故事、技術和學術文本,以及超長上下文、多文件情境。
最後,我們將總結如何針對特定使用案例評估長上下文問答的建議。</p><h2>關鍵評估指標</h2><p>評估問答系統不僅僅是檢查事實準確性。具體來說,我們可能希望答案僅基於提供的文本,而非模型的知識。但即使技術上正確的答案也不一定實用。因此,為了有效評估問答系統,我們應考慮兩個正交維度:</p><ul><li><b>忠實性:</b>答案嚴格依賴原始文件的程度。
</li><li><b>實用性:</b>回應對使用者而言的相關性、全面性和實用性。</li></ul><p><b>忠實性衡量答案是否嚴格「僅」依賴原始文件。</b>這意味著模型不應添加外部資訊或憑空捏造(即幻覺)。忠實性對於法律協議、金融合約或醫療保險表格尤為重要,因為答案必須完全基於給定的文本。
忠實性與「基礎性」(groundedness)同義,即答案必須錨定在原始文件上。</p><p>忠實性也包括問答系統知道何時說「我不知道」。如果原始文件不包含答案,理想的回應應該是「我沒有在提供的文本中找到該資訊」。與此挑戰相關的是問答系統的兩種錯誤:</p><ul><li><b>偽陽性:</b>系統編造原始文件中不存在的答案(幻覺)。
</li><li><b>偽陰性:</b>系統錯誤地聲稱原始文件中不包含實際存在的資訊,這可能是由於檢索不佳或大型上下文中的注意力限制。</li></ul><p>我們還需要區分忠實性與正確性。答案可能基於一般知識是正確的,但如果與文件內容矛盾,則仍不忠實。
範例包括病患專屬的醫療指示(可能與一般指南不同)、金融或法律協議中的定義(可能偏離標準),以及具有替代時間線的歷史小說。使用者依賴問答系統返回忠實於其特定文件而非普遍真理的回應。</p><p>對於提供引用的系統,我們還可以評估引用準確性。這評估引用的文本是否支援答案。
像 <a href="https://arxiv.org/abs/2105.03011">QASPER</a> 這樣的基準測試明確評估模型是否引用了正確的支援證據來回答問題。這種綜合評估,同時檢查忠實性和引用準確性,提供了關於整體忠實性和證據檢索的更細粒度指標。
</p><p>然而,忠實的答案不一定總是實用的答案。這就是我們也需要評估回應實用性的原因。</p><p><b>實用性衡量答案是否相關、足夠詳細且簡潔。</b>相關性意味著答案直接回應使用者的問題,而不偏離主題。全面性確保答案包含必要的細節。
簡潔性透過確保答案簡明扼要、沒有不必要的細節或冗詞贅字來平衡全面性。</p><p>對於複雜問題的簡短單句回答可能忠實,但如果答案需要更多細節,則實用性不足。反之,充滿不相關細節的過長回應可能會讓使用者不知所措,使他們難以找到所需的核心答案。
理想的回應應包含原始文件中大部分(如果不是全部)的相關資訊,並以簡潔的方式滿足使用者的需求。</p><p><a href="https://arxiv.org/abs/2305.18201">Xu 等人 (2023)</a> 的一項研究發現,生物學或經濟學等領域的領域專家更喜歡既全面又忠實的答案,特別是對於長篇問題。
相比之下,群眾工作者通常強調表面方面,例如簡潔性或細節。因此,如果我們為高階使用者和專家建構問答系統,系統應專注於返回忠實且全面的答案。</p><p>忠實性與實用性之間存在張力。一個答案可能完全忠實,但卻完全不實用。例如,如果我們詢問一份法律合約:「如果租戶逾期付款會發生什麼?」
一個忠實但不實用的答案可能是:「租賃協議第 4.2 條涉及逾期付款。」儘管技術上準確,但它沒有告訴我們逾期付款實際會發生什麼,因此不實用。問答系統只是從文件中複製貼上大段內容也是如此。一個有用的系統應該綜合資訊並返回直接且有意義地解決使用者問題的答案。
</p><p>總而言之,最佳答案透過以下方式實現忠實性和實用性:</p><ul><li>紮根於原始文本(忠實)</li><li>直接回應使用者的問題(相關)</li><li>提供足夠的細節和上下文(全面)</li><li>清晰簡潔地呈現資訊(簡潔)</li></ul><h2>建構評估資料集</h2><p>評估長上下文問答始於建立一個穩健的評估資料集。
這涉及測試問答系統瀏覽書本長度的文件來回答問題的能力。</p><p>首先,我們將從創建各種真實、特定情境的問題開始。雖然人工標註者擅長撰寫優質問題,但這既耗時又難以大規模實施,特別是對於冗長的文件。一種更有效的方法是使用語言模型草擬問題,然後由標註者接受或編輯,這將人類判斷與機器速度和規模結合。
</p><p>然而,僅僅透過語言模型擴展是不夠的。我們還需要引導模型生成自然、有用的問題。因此,與其使用模糊的提示詞,例如「針對本章生成問題」,我們可以更具體,例如:「總結本章的主要角色。然後,根據我們目前所讀的內容,為每個角色的背景故事生成一個問題。」
更精確的提示詞有助於引導模型生成對我們的評估資料集有用的問題。</p><p>這種方法建立在現有基準測試的方法論基礎上。<a href="https://arxiv.org/abs/1712.07040">NarrativeQA</a> 有意基於摘要而非全文生成問題。
這鼓勵測試敘事理解而非淺層事實回憶的問題。基於同樣的原因,<a href="https://arxiv.org/abs/2105.03011">QASPER</a> 根據學術論文的摘要創建問題,然後模型根據完整論文回答。透過學習這些基準測試,我們可以建構有效衡量對長上下文文件有意義理解的評估資料集。
</p><p><b>我們在創建問題時會希望確保問題多樣性。</b>擁有各種問題類型有助於我們評估問答系統的能力,而不會過度擬合任何單一類型的問題。根據我們的使用案例,評估資料集可能包含以下組合:</p><ul><li><b>事實回憶:</b>這些評估基本的資訊檢索,例如「主角是誰?」
、「條約何時簽署?」或「第 2.1 節中提到的法律條款是什麼?」雖然簡單,但它們確認我們的問答系統是否能可靠地提取資訊。</li><li><b>定義:</b>這些評估模型根據文件解釋特定領域內容的能力。範例包括「這篇論文中這個縮寫是什麼意思?」
、「解釋第 7 章介紹的魔法系統」或「定義第 203 頁討論的經濟理論。」這對於技術文件很重要,以確保系統能處理上下文中的專業術語。</li><li><b>摘要:</b>這些衡量系統是否能識別核心思想並連貫地總結它們。例如,「總結這篇論文的主要發現」、「回顧這本書到目前為止發生了什麼」或「第二部分討論了哪些關鍵主題?」
</li><li><b>推理與論證:</b>這些評估超越明確陳述事實的能力,透過整合文件中不同部分的資訊來形成連貫的答案。例如,「角色為何做出這個選擇?」或「我們能從這些法律中推斷出這個社會的什麼?」</li><li><b>「無資訊」:</b>與前幾類不同,這些問題無法從文件中回答。
例如,「甘道夫在霍格華茲的最終戰役中做了什麼?」或「這份住宅租賃協議中商標侵權的罰則是什麼?」一個忠實的問答系統應該認識到所需資訊不存在,並據此回應,而不是編造答案。</li></ul><p><b>我們的問答評估也應該對文件中證據的位置具有穩健性。
</b>我們透過設計證據出現在開頭、中間或結尾的問題,以及創建需要多跳推理的問題來確保這一點。</p>


