更新(2026 年 2 月):完整的開源 AI 儲存庫清單託管於 Good AI List,每日更新。目前已膨脹至 15,000 個儲存庫,您也可以提交遺漏的儲存庫。您還可以在我的 GitHub cool-llm-repos 清單上找到其中一些。
四年前,我曾對開源機器學習生態系進行分析。此後,格局已發生變化,因此我重新審視了這個主題。這次,我專注於基礎模型周圍的技術堆疊。資料方面,我使用關鍵字 gpt、llm 和 generative ai 在 GitHub 上進行搜尋。如果現在的 AI 領域讓您感到應接不暇,那是因為它確實如此。
僅 gpt 一詞就有 118,000 個搜尋結果。為了簡化工作,我將搜尋範圍限制在至少有 500 顆星的儲存庫。其中 LLM 有 590 個結果,GPT 有 531 個,而 generative ai 則有 38 個。我也偶爾會查看 GitHub 趨勢和社群媒體,以尋找新的儲存庫。
經過數小時的努力,我找到了 896 個儲存庫。其中 51 個是教學(例如 dair-ai/Prompt-Engineering-Guide)和彙整清單(例如 f/awesome-chatgpt-prompts)。雖然這些教學和清單很有幫助,但我對軟體更感興趣。
我仍然將它們納入最終清單,但分析是針對 845 個軟體儲存庫進行的。這是一個痛苦但有益的過程。它讓我對人們正在做什麼、開源社群的協作程度有多高,以及中國開源生態系與西方生態系的分歧程度有了更深入的理解。
新的 AI 技術堆疊
我將 AI 技術堆疊視為由三個層次組成:基礎設施、模型開發和應用程式開發。
基礎設施
最底層是基礎設施,其中包括用於服務部署(vllm、NVIDIA 的 Triton)、運算資源管理(skypilot)、向量搜尋與資料庫(faiss、milvus、qdrant、lancedb)等工具。
模型開發
此層提供模型開發工具,包括模型建構與訓練框架(transformers、pytorch、DeepSpeed)、推論最佳化(ggml、openai/triton)、資料集工程、評估等。任何涉及改變模型權重的操作都發生在此層,包括微調。
應用程式開發
有了現成模型,任何人都可以基於它們開發應用程式。這是過去兩年來活動最頻繁且仍在快速發展的層次。此層也稱為 AI 工程。應用程式開發涉及提示詞工程、RAG、AI 介面等。
除了這三個層次之外,我還有另外兩個類別:
- 模型儲存庫:由公司和研究人員創建,用於分享與其模型相關的程式碼。此類別的儲存庫範例包括 CompVis/stable-diffusion、openai/whisper 和 facebookresearch/llama。
- 基於現有模型建構的應用程式:最受歡迎的應用程式類型是程式碼生成、工作流程自動化、資訊彙整等。
註:在此文章的舊版本中,「應用程式」被列為堆疊中的另一個層次。
AI 技術堆疊的演變
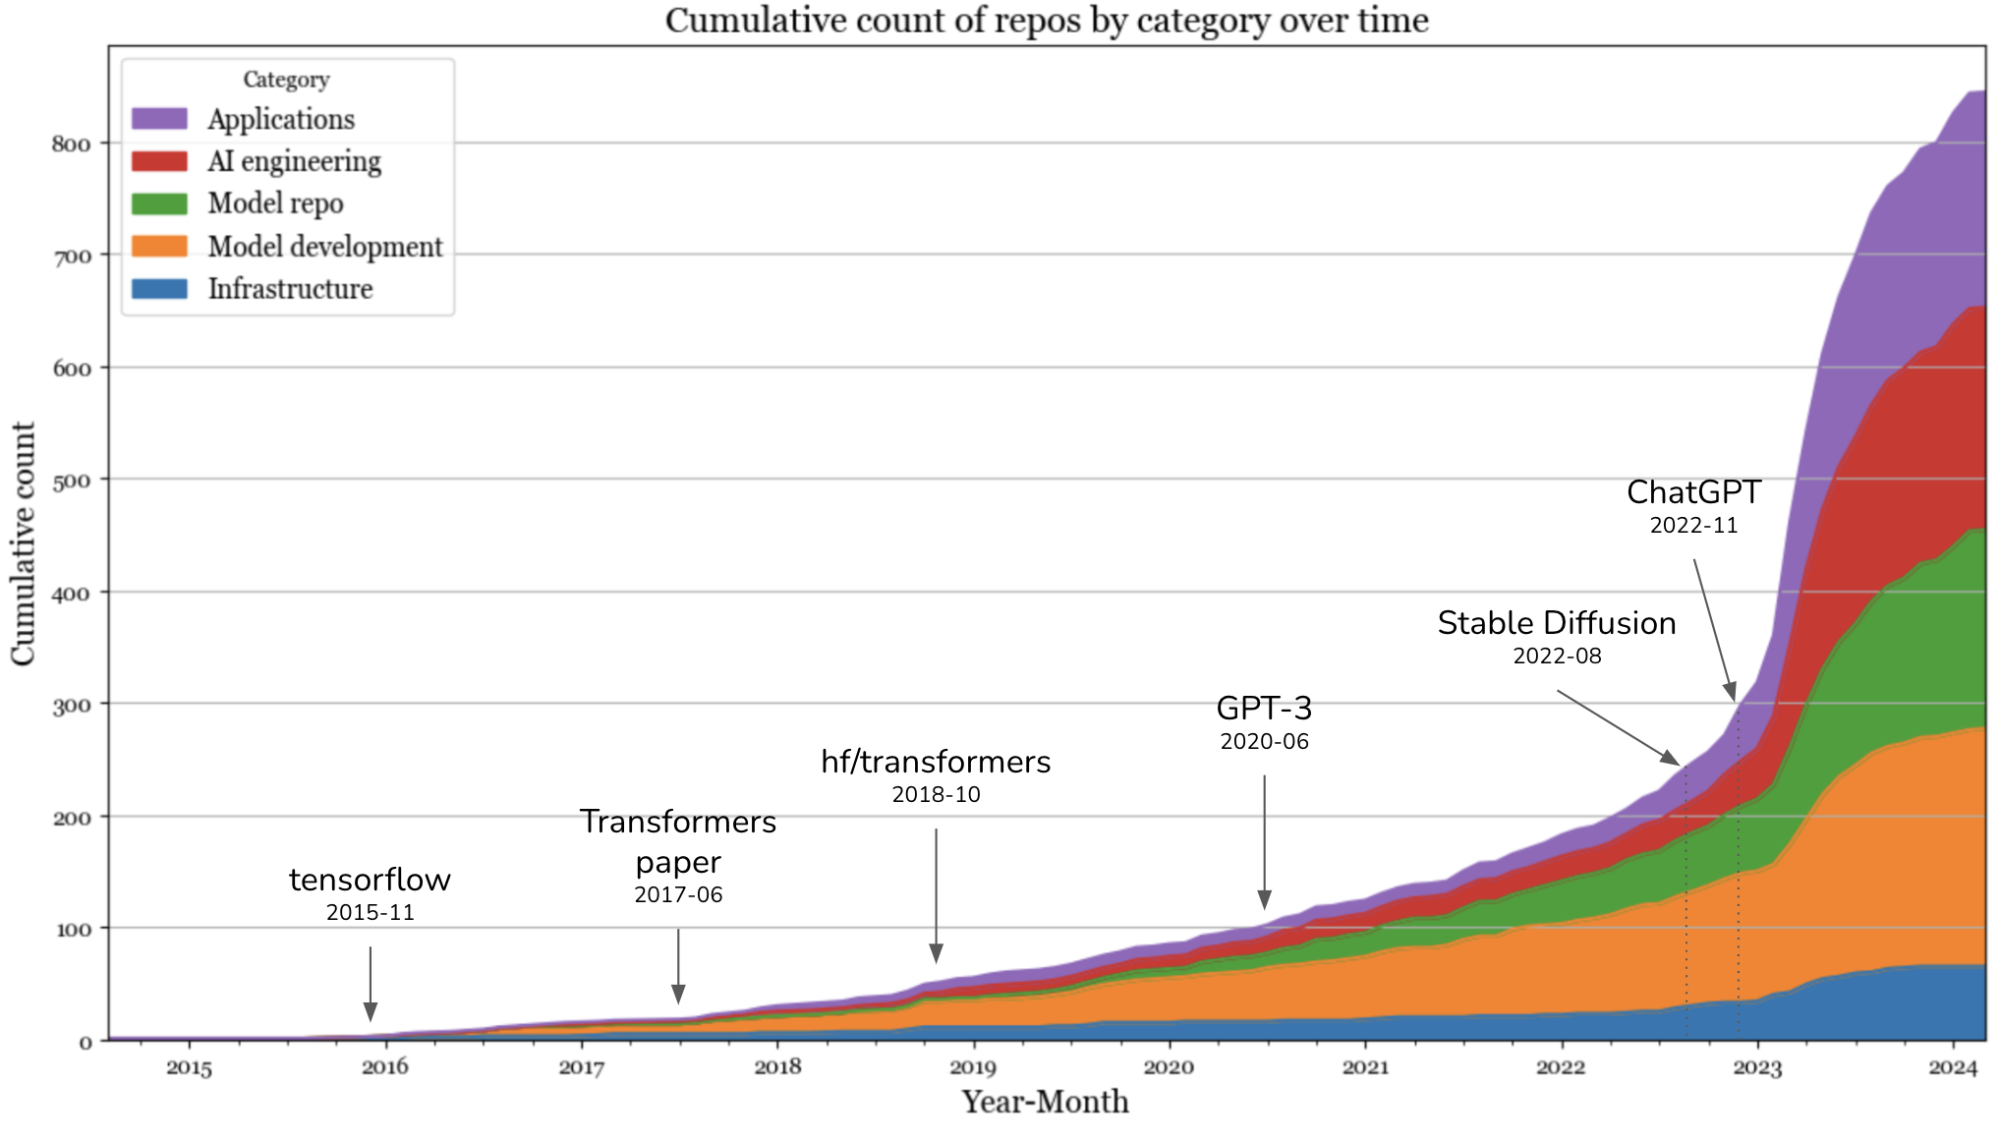
我繪製了每個類別儲存庫累積數量的月度圖表。在 Stable Diffusion 和 ChatGPT 推出後,2023 年新工具呈現爆炸性成長。曲線似乎在 2023 年 9 月趨於平緩,這可能歸因於三個原因:
1. 我的分析只包含至少有 500 顆星的儲存庫,而儲存庫需要時間才能累積這麼多星。
2. 大多數唾手可得的成果已被採摘。剩下的需要更多努力才能建構,因此能建構的人也較少。
3. 人們已經意識到在生成式 AI 領域競爭很困難,因此熱情有所降溫。根據經驗,2023 年初我與公司進行的所有 AI 對話都圍繞著生成式 AI,但最近的對話則更為務實。甚至有幾次提到了 scikit-learn。我希望在幾個月後重新審視這一點,以驗證其真實性。
2023 年,成長最顯著的層次是應用程式和應用程式開發層。基礎設施層也有一些成長,但遠不及其他層次的成長水平。
應用程式
不出所料,最受歡迎的應用程式類型是程式碼生成、聊天機器人(例如角色扮演、WhatsApp 機器人、Slack 機器人)和資訊彙整(例如「讓我們將其連接到我們的 Slack,並要求它每天總結訊息」)。
AI 工程
2023 年是 AI 工程之年。由於許多工具相似,很難對它們進行分類。我目前將它們分為以下幾類:提示詞工程、AI 介面、代理人,以及 AI 工程(AIE)框架。提示詞工程遠不止於調整提示詞,還涵蓋了約束取樣(結構化輸出)、長期記憶體管理、提示詞測試與評估等。
AI 介面為終端使用者提供與 AI 應用程式互動的介面。這是我最感興趣的類別。一些日益普及的介面包括:
- 網頁和桌面應用程式。
- 瀏覽器擴充功能,讓使用者在瀏覽時能快速查詢 AI 模型。
- 透過 Slack、Discord、WeChat 和 WhatsApp 等聊天應用程式的機器人。
- 外掛程式,讓開發者能將 AI 應用程式嵌入到 VSCode、Shopify 和 Microsoft Offices 等應用程式中。外掛程式方法對於能使用工具完成複雜任務的 AI 應用程式(代理人)很常見。
AIE 框架是一個統稱,指所有幫助您開發 AI 應用程式的平台。其中許多是圍繞 RAG 建構的,但許多也提供其他工具,例如監控、評估等。
代理人是一個奇怪的類別,因為許多代理人工具只是複雜的提示詞工程,可能帶有約束生成(例如模型只能輸出預定動作)和外掛程式整合(例如讓代理人使用工具)。
模型開發
在 ChatGPT 之前,AI 技術堆疊由模型開發主導。模型開發在 2023 年的最大成長來自於對推論最佳化、評估和參數高效微調(歸類於模型建構與訓練之下)日益增長的興趣。推論最佳化一直很重要,但當今基礎模型的規模使其對延遲和成本至關重要。
最佳化的核心方法保持不變(量化、低秩分解、剪枝、知識蒸餾),但許多新技術已專門針對 Transformer 架構和新一代硬體開發。例如,2020 年,16 位元量化被認為是最先進的。如今,我們看到 2 位元量化甚至更低的位元量化。
同樣,評估一直都是必不可少的,但隨著許多人將模型視為黑盒子,評估變得更加重要。有許多新的評估基準和評估方法,例如比較性評估(參見 Chatbot Arena)和 AI 作為評審。
基礎設施
基礎設施涉及資料管理、運算資源和用於服務部署、監控及其他平台工作的工具。儘管生成式 AI 帶來了所有變化,開源 AI 基礎設施層或多或少保持不變。這也可能是因為基礎設施產品通常不開源。此層中最新的類別是向量資料庫,包括 Qdrant、Pinecone 和 LanceDB 等公司。
然而,許多人認為這根本不應該是一個類別。向量搜尋已經存在很長時間了。現有的資料庫公司,如 DataStax 和 Redis,正在將向量搜尋整合到資料已經存在的地方,而不是專門為向量搜尋建構新的資料庫。
開源 AI 開發者
開源軟體,像許多事物一樣,遵循長尾分佈。少數帳戶控制著大部分儲存庫。一人十億美元公司?845 個儲存庫託管在 594 個獨特的 GitHub 帳戶上。有 20 個帳戶至少有 4 個儲存庫。這些前 20 名帳戶託管了 195 個儲存庫,佔清單上所有儲存庫的 23%。
這 195 個儲存庫總共獲得了 1,650,000 顆星。在 GitHub 上,帳戶可以是組織或個人。前 20 名帳戶中有 19 個是組織。其中,3 個屬於 Google:google-research、google、tensorflow。
這前 20 名帳戶中唯一的個人帳戶是 lucidrains。在星數最多的前 20 名帳戶中(僅計算生成式 AI 儲存庫),有 4 個是個人帳戶:
- lucidrains (Phil Wang):能以驚人的速度實現最先進的模型。
- ggerganov (Georgi Gerganov):一位來自物理背景的最佳化之神。
- Illyasviel (Lyumin Zhang):Foocus 和 ControlNet 的創建者,目前是史丹佛大學博士生。
- xtekky:一位創建 gpt4free 的全端開發者。
不出所料,在技術堆疊中越往下層,個人建構就越困難。基礎設施層的軟體最不可能由個人帳戶啟動和託管,而超過一半的應用程式由個人託管。由個人啟動的應用程式,平均而言,比由組織啟動的應用程式獲得了更多的星數。幾位人士推測,我們將看到許多非常有價值的一人公司(參見 Sam Altman 的訪談和 Reddit 討論)。我認為他們可能是對的。
一百萬次提交
超過 20,000 名開發者為這 845 個儲存庫做出了貢獻。他們總共提交了近一百萬次!其中,50 位最活躍的開發者提交了超過 100,000 次,平均每人超過 2,000 次提交。在此處查看前 50 名最活躍的開源開發者完整清單。
中國開源生態系的成長
中國 AI 生態系與美國的差異早已為人所知(我在 2020 年的部落格文章中也提到過)。當時,我認為 GitHub 在中國並未廣泛使用,我當時的觀點可能受到中國 2013 年禁止 GitHub 的影響。然而,這種印象已不再真實。GitHub 上有許多針對中國受眾的熱門 AI 儲存庫,其描述以中文書寫。
有為中文或中英文模型開發的儲存庫,例如 Qwen、ChatGLM3、Chinese-LLaMA。雖然在美國,許多研究實驗室已放棄 RNN 架構用於語言模型,但基於 RNN 的模型家族 RWKV 仍然很受歡迎。還有 AI 工程工具提供將 AI 模型整合到中國流行的產品中,如 WeChat、QQ、DingTalk 等。
許多流行的提示詞工程工具也有中文鏡像。在 GitHub 前 20 名帳戶中,有 6 個源自中國:
- THUDM:清華大學知識工程組(KEG)和資料探勘。
- OpenGVLab:上海人工智慧實驗室通用視覺團隊。
- OpenBMB:由 ModelBest 和清華大學自然語言處理組創立的大模型基礎開放實驗室。
- InternLM:來自上海人工智慧實驗室。
- OpenMMLab:來自香港中文大學。
- QwenLM:阿里巴巴的 AI 實驗室,發布 Qwen 模型家族。
生得快,死得早
去年我看到的一個模式是,許多儲存庫迅速獲得大量關注,然後又迅速消退。我的一些朋友稱之為「炒作曲線」。在這 845 個至少有 500 顆 GitHub 星的儲存庫中,有 158 個儲存庫(18.8%)在過去 24 小時內沒有獲得任何新星,有 37 個儲存庫(4.5%)在過去一週內沒有獲得任何新星。
以下是其中兩個儲存庫的成長軌跡與兩個更持續發展的軟體成長曲線的比較範例。儘管這兩個範例現在已不再使用,但我認為它們在向社群展示可能性方面很有價值,而且作者能夠如此快速地推出產品也很酷。
我個人最喜歡的想法
社群正在開發許多很酷的想法。以下是我最喜歡的一些:
- 批次推論最佳化:FlexGen、llama.cpp
- 使用 Medusa、LookaheadDecoding 等技術實現更快的解碼器
- 模型合併:mergekit
- 約束取樣:outlines、guidance、SGLang
- 看似利基的工具


