大約在 2025 年聖誕節前後,AI 工程師們注意到代理(agents)發生了變化,它們開始真正發揮作用了!很難確切指出原因。也許是我們終於有假期時間來嘗試最新的代理與最新的模型,也許是模型跨越了某個能力閾值,又或許是模型周圍的「框架」(wrappers)變得更加成熟。
本文將論證,這是後兩者的結合。模型與框架共同改進,然後它們的改進曲線在正確的時刻交叉。這種動態有助於解釋接下來會發生什麼:模型不斷將框架吸收到其權重中,工程師不斷刪除已被吸收的部分,而剩下的框架則是用來引導人類注意力,而非模型本身。
Transformer 的發明者之一 Lukasz Kaiser 在六月的「Unsupervised Learning」節目中說道:「去年冬天,去年聖誕節的變化,有點難以確切指出。我的意思是,框架變了,一些後訓練(post-training)也變了,然後新的預訓練模型也出現了……但感覺像是一個巨大的飛躍,很難確切指出是什麼導致了它。」
「發生了什麼?」這個問題的答案不僅僅在於模型的權重,它還在於圍繞這些權重發展起來的系統。答案就在於代理框架。
回想 2022 年 11 月,當時 ChatGPT 是最先進的 AI 工具。它唯一的能力是下一個詞元預測(next-token prediction),以及一些人類回饋強化學習(RLHF),使其能夠像一個有用的助手。沒有工具,沒有搜尋,也沒有推理能力。
最初的 ChatGPT 僅限於其訓練資料和你發送給它的提示詞。不多也不少,它就像一個「缸中之腦」。代理框架是一種讓大型語言模型(LLM)擺脫這種限制,並與真實數位資訊空間互動的方式。
代理框架是除了模型權重之外,讓代理運作的一切。它包括圍繞模型的環境、工具、上下文和安全機制(guardrails)。沒有框架,模型就是一個缸中之腦。它可以採取認知行動,但需要框架才能在真實數位空間中執行該決策。
框架就像是給模型的心智一個身體。有了框架,模型可以感知(上下文)、行動(工具)、持久化資訊(記憶和壓縮),並執行其邊界(權限和安全機制)。
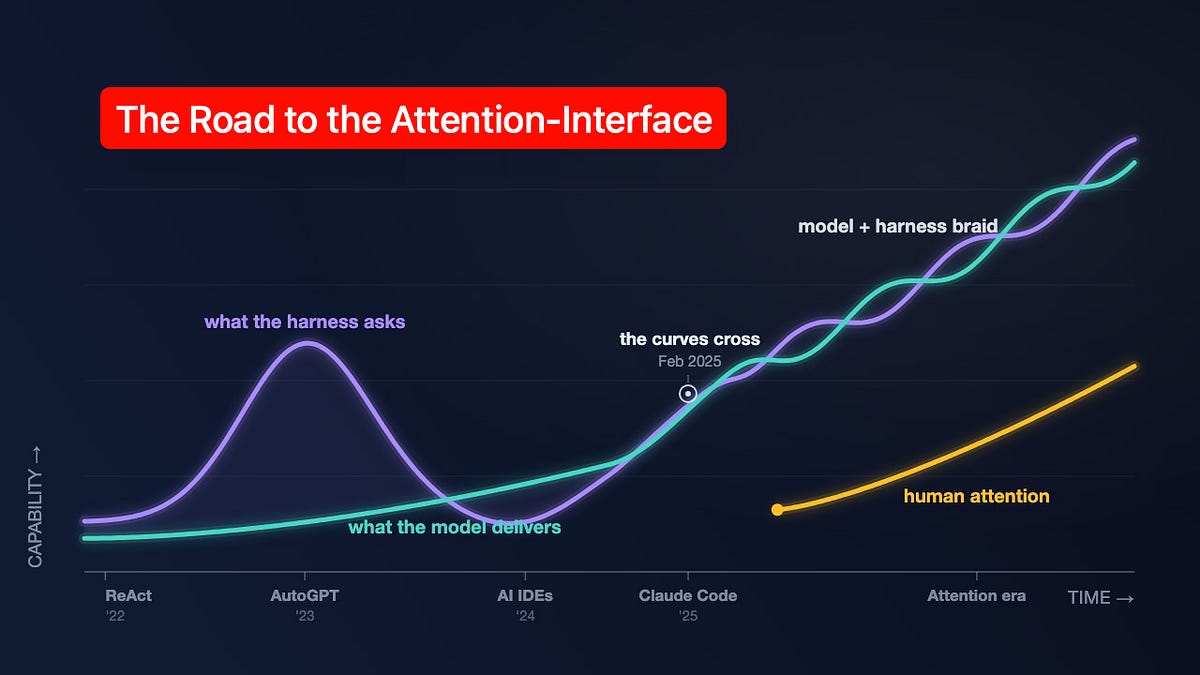
模型與框架演進的路徑中有兩條曲線:框架對模型的要求,以及模型在實踐中能提供的能力。這兩條曲線之間的差距等於代理的有效性,而我將論證,正是這個差距的縮小導致了 Lukasz Kaiser 所提及的代理的顯著改進。
以下是差距縮小的階段:
ReAct,「紙上的框架」(2022 年 10 月):ReAct 是一種提示詞技術,讓模型透過提示詞進行推理。它是紙面上的代理迴圈,獨立於模型權重之外。它定義了「代理迴圈」的概念,即模型進行推理 -> 行動 -> 觀察 -> 重複。同樣,ReAct 迴圈僅作為一種提示詞方法存在。當時提示詞是唯一存在的推理方法,沒有人稱之為「框架」。
Toolformer(Meta,2023 年 2 月)在同一個冬天暗示,工具使用可以透過訓練而非提示詞來實現。這有點像艾倫·圖靈在電腦實體化之前提出的概念。一個強大的想法,只是後來才得以實現。(ReAct 比 ChatGPT 早一個月,2022 年 10 月對比 2022 年 11 月)。此時兩條曲線都接近於零。差距很小,因為我們才剛開始。
AutoGPT/BabyAGI,「過早的自主性」(2023 年春季):在 AutoGPT/BabyAGI 時代,框架曲線遠超模型能力曲線。兩者都賦予模型完全的自主權,要求模型充當「自主員工」,但此時的模型仍然只是脆弱的下一個詞元預測器。迴圈本身並不會增加模型的能力。
迴圈會放大模型已有的能力,而在某個閾值以下,迴圈會放大錯誤而非可靠性。考慮負面複利的影響:一個 20 步任務中,每一步 95% 的可靠性會導致約 36% 的平均成功率。框架賦予模型一個它幾乎沒有機會完成的任務。這是差距最大的時候,接下來的 18 個月都是對此的反應和試圖縮小這個差距。
Cursor/Copilot,「退回人類在迴圈中」(2023 年 - 2024 年):第一批 AI 驅動的整合開發環境(IDEs)意識到賦予模型過多自主權的失敗模式。它們透過將框架曲線拉到模型曲線之下,來縮小差距。不要直接將迴圈交給模型;而是將迴圈交給人類,賦予人類協調迴圈的能力,同時模型加速人類的工作。
Devin 的第一個版本試圖將自主權交還給模型。Answer.AI 團隊的一項測試表明,這仍然為時過早,成功率約為 15%。這證明了從 IDE 退回到完全自主並非膽怯,而是正確的舉動。然而,儘管主流策略是將框架拉到模型之下,模型仍在不斷改進。
接近 2024 年底,隨著 o1,第一個推理模型的引入,差距首次反轉,我們開始看到模型能力過剩(model capability overhang)的初步跡象。
Claude Code,「曲線交叉」(2025 年 2 月):2024 年底的反轉創造了一個機會,有人必須抓住它:如果模型現在領先於框架,那麼一個刻意限制模型能力的框架將會浪費潛力。Claude Code 是第一個為抓住這個機會而構建的程式碼代理。
它放棄了 IDE,轉向終端機,賦予模型 Bash 和檔案讀寫權限,並用權限規則取代了每次更改都需要人類批准的需求。模型再次被賦予迴圈,這次它理解了任務。Boris Cherny 及其團隊在開發 Claude Code 時,考慮的是下一個模型的能力,而非當前的模型。
它之所以如此成功,並非因為它是第一個賦予模型自主權的產品,而是因為它在正確的時機做到了這一點。這個時機就是模型變得足夠可靠,能夠成功實現自主的交叉點。Claude Code 在六個月內成長到約 10 億美元的年經常性收入(ARR),這一切都歸因於 Anthropic 抓住了曲線開始匯合時的機會。
接下來發生的事情是,這些曲線不僅僅是匯合,它們開始編織在一起。今天,框架很重要,而且其重要性可以衡量。Harness-Bench 在不同的框架中,對相同的模型執行了相同的 106 項任務,分數從 52.4 到 76.2 不等:在模型沒有任何改變的情況下,差距達到了 23.8 分。代理的一半是框架。
OpenAI 在 ARC-AGI-3 上透過框架更改也取得了類似的結果。僅僅增加了保留推理(retained reasoning)和壓縮(compaction),GPT-5.6 Sol 在 ARC-AGI-3 上的分數就從 13.3% 提高到 38.3%,足足增加了三倍。
幕後發生的事情是,強化學習(RL)已經移到了框架內部。OpenAI 在 2025 年 5 月發布 codex-1 時宣佈:「codex-1 是透過強化學習,在各種環境中針對真實世界的程式碼任務進行訓練的。」這兩條曲線結合在一起,開始編織成一個統一的系統。
這就是 Toolformer 的夢想在現實中實現。現在工具調用不再是從外部提示,而是從模型內部環境中訓練出來的。然後,當模型在框架的環境中訓練時,它們開始將框架的能力吸收到模型權重中,例如,學習如何根據自身上下文視窗的知識自動壓縮。
GPT-5.1-Codex-Max 發布:「第一個原生訓練用於透過壓縮跨多個上下文視窗運作的模型。」一旦模型吸收了框架能力,框架就可以卸下鷹架。這是一種透過簡化來實現的生產。來自 Anthropic 的 Thariq Shihipar 表示,團隊最近刪除了 Claude Code 80% 的系統提示詞。
衡量代理框架演進速度的標準是,在保持相同能力水平的同時,你可以刪除多少框架。這就是我們作為 AI 工程師需要努力實現的未來。這就是模型與框架演進的迴圈:訓練 -> 吸收 -> 卸下 -> 重複。模型不斷攀升到它尚未能做到的下一個目標。
Kaiser 指出的飛躍之所以難以確切指出,是因為它不是一個離散事件。預訓練的飛躍是顯而易見的,因為你可以在模型卡中闡明它。模型與框架的共同演進飛躍則不那麼明顯,因為沒有關於演進過程的文檔。這就是去年冬天飛躍的答案:它發生在模型與框架協同工作的空間中。
我們需要問:如果每個框架能力最終都會被模型吸收,那會剩下什麼?不斷刪除模型可以吸收的一切。想像一下,當你完成這個過程後,你的代理會是什麼樣子。當你刪除了一切之後,你手中還剩下什麼?
模型權重接下來會吸收什麼?多代理協調、工具選擇、記憶……等等。研究人員正在構建自我改進的框架,這些框架本身也可以像模型一樣進行訓練。在這種刪除和吸收過程結束時,剩下的是以人為中心的代理能力。例如權限、身份、信任和可讀性。一個將權限吸收到自身中的模型,就已經消解了權限。吸收並不會終結框架,吸收會顛覆框架。
框架變成了代理與操作它的人類之間的介面。框架最初是人類與模型之間的介面。我們從聊天框發展到 IDE,再到終端機。如果模型吸收了面向電腦的能力,那麼演進的下一個階段將是更上一層的抽象。框架變成了模型與我們人類注意力之間的介面。
它變成了注意力介面。Ryan Lopopolo 在 Latent Space 的「Extreme Harness Engineering for Token Billionaires」節目中說道:「唯一根本稀缺的東西是我團隊的同步人類注意力。」詞元變得豐富且可靠,但我們仍然受制於稀缺的人類注意力。
我們已經看到了這種火花,例如 Anthropic 長期運行的代理進度檔案和代理批准佇列。當模型吸收框架時,模型與框架曲線之間的差距並不會消失。它會跨越人類邊界,創造一對新的曲線和一個新的差距。新的差距是代理對人類的要求,以及人類能夠回應的程度之間的空間。
我預測,在一年內,每個構建代理 AI 的公司都將推出一個人類注意力策略介面(human attention policy surface),就像每個代理 AI 公司都發布了 AGENTS.md 一樣。AGENTS.md 告訴代理如何與你的程式碼庫協作。
注意力介面將告訴代理如何與你協作。它將管理何時允許它打斷你,何時應繼續工作,哪些決策它可以自行做出,哪些決策需要你的批准。而且,就像代理系統中的其他一切一樣,它將成為系統的一個可學習組件,可以透過更多資料進行學習。每一次修正都將成為有用的資料。
模型最初是一個缸中之腦。框架給了這個大腦一個身體,然後這個身體開始溶解到大腦中。我們需要構建的,是未來任何模型都永遠無法吸收的東西:與唯一真正稀缺資源,人類注意力,的介面。


