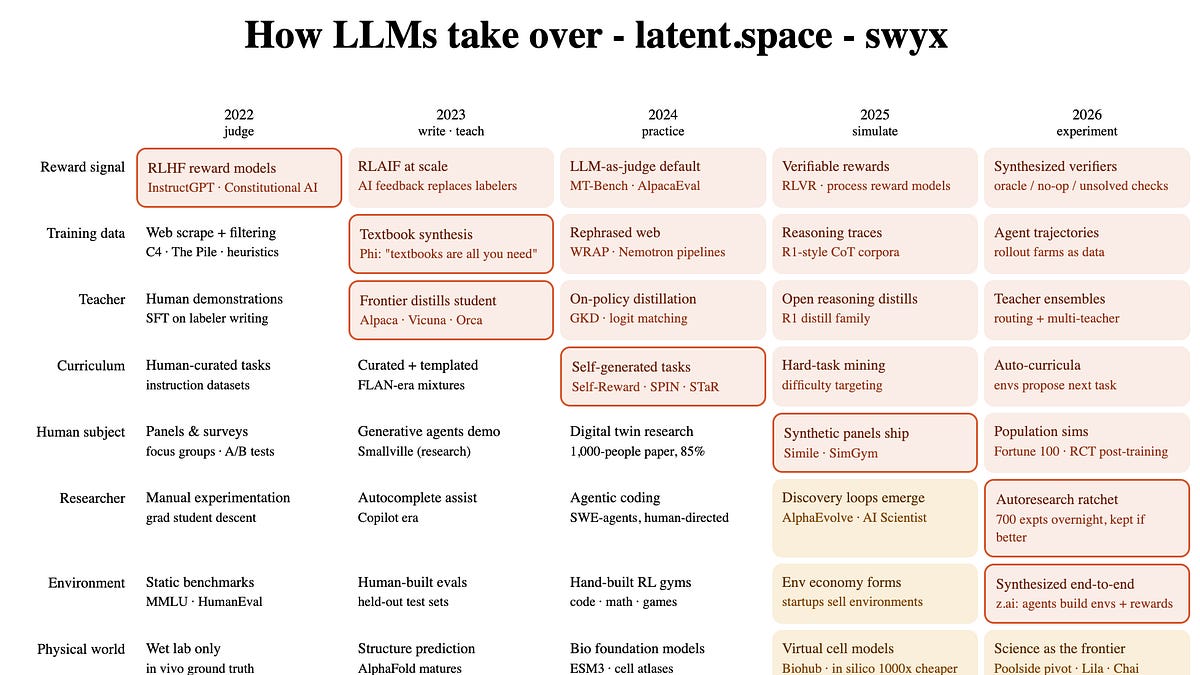
以今日 AI 的標準來看,這是一個相當平靜的星期五,所以是時候退一步,反思究竟發生了什麼。如果你閱讀了我們 2025 年的閱讀清單,並關注了我們對 Z.ai GLM 的報導,理解了 Poolside 的轉型,一直追蹤我們「AI 應用於科學」的主題,並收聽了今天的 Simile 播客,你不僅是 Latent Space 最忠實的讀者之一,很可能也會得出這個心智模型:
自 2022 年以來,每年都有一個生產機器智慧的管線組件從人類製造轉變為模型製造。這並非漸進式或均勻的變化,每一次轉變都有一個起源點,一篇論文或一個產品,其中合成版本首次在頂尖實驗室中承擔核心功能,從那時起,未來已至,只是尚未全面投入生產。
如果你仔細觀察,我們過去稱之為「合成資料」、「合成評分標準」、「AI 研究員」和「端到端強化學習環境」的東西,正日益成為雄心勃勃的人類模擬,精準度可能差 10%,但成本便宜 100 倍,速度快 10,000 倍。
第一個被合成的是,出乎意料地,評審。InstructGPT 確立了現今的經典技巧:收集一次人類偏好,訓練一個獎勵模型,然後讓策略根據模型而非人類進行最佳化。從策略的角度來看,給予認可的實體已經是一個 LLM。憲法式 AI 進一步推進,讓 AI 根據一套原則(RLAIF)自我批判,而 Lee 等人後來展示了 AI 回饋能以極低的成本達到與人類回饋相符的效果。
當 LLM 作為評審成為預設的評估方法(MT-Bench、AlpacaEval)時,整個認可機制,獎勵、批判、評估,都運行在模型評審模型之上。
Microsoft 的 Phi 系列在其標題中就闡明了論點:《Textbooks Are All You Need》。一個在 LLM 合成、教科書品質資料上訓練的小型模型,其表現遠超其參數規模,而 phi-1.5 證實這並非僥倖。Apple 的 WRAP 將此舉泛化:不僅生成資料,還利用 LLM 重寫整個網路內容,使預訓練效率提升約三倍。
從那時起,這個管線開始工業化,NVIDIA 的 Nemotron-4 340B 以寬鬆授權的合成資料生成管線作為其主要特色發布,到 2025 年,推理軌跡語料庫(由強大推理器生成的思維鏈)已成為標準的預訓練和中期訓練要素。語料庫,這個本應是不可簡化的、人類輸入的內容,現在主要由模型撰寫。
ChatGPT 的 API 開放數週後,Stanford 的 Alpaca 展示了在 GPT 生成的指令上進行 600 美元的微調,就能複製大部分頂尖模型的行為。Vicuna 透過共享對話實現了這一點;Orca 則透過豐富的教師解釋而非單純的答案。
這項技術從模仿發展成正規的訓練學科,在策略上泛化的知識蒸餾解決了訓練/推論不匹配的問題,並在 DeepSeek-R1 發布一系列蒸餾模型與旗艦模型一同推出時達到其文化高峰,使得「教師是模型」成為此後每個小型模型發布的預設假設。階段 1-3 使輸入合成化;階段 4 則是迴圈開始自我閉合,因為模型開始決定接下來要學習什麼。
這些組件很早就存在了,Self-Instruct(模型撰寫自己的指令集)和 STaR(模型自我引導其推理軌跡)都出現在 2022 年,但轉變發生在 Meta 的 Self-Rewarding Language Models 和 SPIN 展示了模型可以生成自己的任務、評審自己的輸出,並超越人類偏好資料的上限。
課程設計,歷史上機器學習中最具工匠精神的部分,憑直覺選擇接下來要訓練什麼,變成了模型自我完成的事情。
輔助時代(Copilot,然後是 SWE-agents)仍由人類選擇實驗。而發現時代則不然。DeepMind 的 AlphaEvolve 在 2025 年演化出真正的新演算法,而 Sakana 的 AI Scientist(現已發表在《自然》雜誌!)
勾勒出完整的論文撰寫管線。關鍵時刻是 Karpathy 在 2026 年 3 月的 autoresearch:一個刻意簡化的棘輪迴圈,其中一個程式碼代理修改真實的 LLM 訓練設定,運行一個五分鐘的實驗,僅在驗證損失改善時保留更改,然後徹夜重複。
他自己的長期運行將 700 個實驗累積成 20 項保留的改進,將達到 GPT-2 效能所需時間從 2.02 小時縮短到 1.80 小時,在他睡覺時發現了真實、可轉移的程式碼更改。
強化學習的擴展瓶頸從模型轉移到環境:你需要數千個可執行、可驗證、專業且真實的任務世界,而人類無法足夠快地手動建構它們。我們最近在 z.ai / GLM-5.3 的議題中報導了這一點:Z.ai 建構了端到端合成環境的管線,研究代理挖掘真實工作模式並將其轉換為具有隱藏狀態的長週期環境,評審代理嘗試每個任務以確認其可解,驗證器在未見參考解的情況下合成,然後透過預言機、無操作和未解狀態檢查進行壓力測試,直到其二元獎勵足夠可靠,可以直接用於訓練。
正如 GLM-5.3 版本所說,整個環境、評審和驗證堆疊完全是合成的。同一週,Ornith-1.5 發布,聲稱實現了端到端自我改進,模型提出自己的任務並生成自己的強化學習執行軌跡。訓練場、裁判和計分板現在都是模型。
如果模型可以是評審、教師和環境,那麼迴圈中剩下的人類角色就是「主體」,偏好、行為和需求的來源。這正是 Simile 正在取代的層次。其血統從 Joon Sung Park 的 Generative Agents(Smallville,2023)延伸到《1,000 人的生成式代理模擬》,其中根據兩小時的傳記訪談建立的數位分身,在兩週後,其複製原始人類的問卷和行為反應的準確度,達到人類自我複製的 85%。
需要克服的主要障礙是:頂尖模型被訓練成代理模型,這使得它們在模擬真實人類方面表現不佳,因此 Simile 針對訪談、交易資料以及來自開放科學框架的註冊隨機對照試驗進行後訓練,專門用於恢復人類的偏見、不一致性和因果結構,並報告了模擬品質的早期擴展定律。
隨著 Shopify 的 SimGym 模擬購物者軌跡,以及騰訊在粗略層面上的十億人設方法,焦點團體、使用者研究和 A/B 測試小組正轉變為推論工作負載。
網格的最後一行從未完全變紅,這正是重點。Poolside 的反向高階主管招募信精確地劃清了界線:世界上的問題分為智慧受限的問題(可透過擴展認知解決,很快會被開放權重商品化)和實驗受限的問題,其中「再多的智慧也無法取代真實世界的實驗回饋,沒有濕實驗室,十萬個聰明頭腦也無法治癒癌症。」
他們的賭注是,AI 的持久價值將歸屬於擁有實驗迴圈的人:AI 作為「世界上最有價值的科學發現引擎」。生物領域正從另一個方向採取相同的策略。CZ Biohub 正在將人類細胞圖譜成像為虛擬細胞,因為電腦模擬(in silico)比活體實驗(in vivo)便宜約 1000 倍,速度也快 1000 倍,並擴展到虛擬免疫系統,Chai、Xaira 和 Lila 的資料中心形狀實驗室正在填補 AI 輔助科學的堆疊。物理世界是唯一無法完全合成的組件,只能逐個細胞地壓縮成模型。
再讀一遍這個網格,第二個模式出現在第一個模式之下。每一次轉變都伴隨著相同的反對意見,模型崩潰、幻覺堆疊、垃圾進垃圾出,但每一次轉變都發生了,恰好在驗證機制使合成版本變得可信的那一刻:對 Phi 的教科書進行嚴格篩選,LLM 評估中的評審對評審一致性研究,RLVR 的單元測試和證明檢查器,z.ai 驗證器的預言機/無操作檢查,Simile 數位分身的註冊隨機對照試驗,虛擬細胞的濕實驗室迴圈。合成技術的進步並非來自生成能力的提升,而是來自驗證能力的精進。
這也暗示了接下來的發展方向。網格左下角剩餘的灰色三角形,物理實驗、具體化的真實情況,正是驗證最慢且最昂貴的區域。模型學會了寫作,然後學會了評審,然後學會了實踐,然後學會了實驗。這個十年剩下的問題是,它們需要觸及多少真實世界,以及它們能透過模擬來取代多少。精準度差 10%,便宜 100 倍,快 10000 倍……而且這三個維度都在快速改進。
再說一次,帶著感情:
2026 年 8 月 20 日至 8 月 21 日的 AI 新聞。我們檢查了 12 個 subreddit、544 個 Twitter,沒有進一步的 Discord。AINews 網站允許您搜尋所有過去的議題。提醒一下,AINews 現在是 Latent Space 的一個部分。您可以選擇訂閱或取消訂閱電子郵件頻率!
隱形模型、中國前沿壓力與 DeepSeek 的多模態推進
Ox Alpha 成為當天的核心神秘模型:多位開發者報告其程式碼編寫和代理能力異常強大,猜測集中在智譜/GLM 系列模型,可能是 GLM-5.3 Vision 或閃存變體,而非巨大的新基礎模型。報告包括 Theo 稱其在內部基準測試中表現出色,後來根據其批准合併了 8 個 PR,以及 Kimmonismus 引用在 10 項 DeepSWE 任務中達到 80% 以上,而 Fable 為 65%,GPT-5.6 Sol 為 52%。
社群透過 Hermes Agent/OpenCode/OpenRouter 和 Cline 迅速傳播。
社群最強的技術解讀是「後訓練 + 基礎設施 > 純粹規模」:幾位獨立觀察者認為 Ox Alpha 的速度和風格更像是高效的 GLM 衍生模型,而非萬億參數巨獸。Tim Dettmers 提到更快的輸出/較弱的部分預填充暗示更少的活躍參數,scaling01 認為它可能是將更大的教師模型蒸餾到 5.3 級模型中,teortaxesTex 反覆將範圍縮小到 GLM-5.3/5.4 Vision。
這種解釋符合來自詳細 GLM-5.3 分析的更廣泛論點:性能提升來自與 GLM-5.2 相同的 743B 基礎模型,改進歸因於規模化後訓練、更好的沙盒環境,以及 SAO 在長週期代理任務中更精細的歸因分配,這些都在 ZhihuFrontier 的討論串中總結。
DeepSeek 發布了當天最具體的產品:DeepSeek-V4-Flash-Vision-Exp 增加了多模態支援,據稱同時保留了 V4-Flash 的文字處理能力,DeepSeek 聲稱其多模態代理性能接近 Opus-4.8。此次發布包括混合文字+圖像 API 支援,117-384 個圖像 token 以 Flash 定價計費,以及用於可重複使用的上傳的新 Files API。
這似乎至少部分解決了 Ox Alpha 的困惑,觀察者指出這個神秘模型在某些測試中可能是一個「盲測 VLM」。
更廣泛的信號:中國實驗室正在價格/性能和多模態代理方面壓縮前沿技術。Kimmonismus 認為傳聞中的 GLM-5.3 Flash 級 Ox Alpha 將迫使美國實驗室做出反應,以及 SemiAnalysis 直接詢問開源模型是否正在迎頭趕上,都強化了這一點。
OpenAI、Codex 和定價/使用經濟學
OpenAI 宣布將 GPT-5.6 Sol 在 API 和基於點數的產品中的定價降低了 20% 以上,為期三個月。這與產品層面的促銷活動疊加,例如 Code 在 9 月 3 日前的 50% 折扣,以及 Cognition 指出,在 Devin 上,Sol 在合併折扣後,到 10 月 3 日前實際折扣達 76%。此舉被解讀為利用率/效率更新,以及對廉價中國推論的競爭回應。
Codex 的使用量似乎正在爆炸式增長:thsottiaux 表示 Codex 達到 2000 萬活躍用戶,並授予所有 Codex 和 ChatGPT Work 用戶「儲存重置」,Theo 和 Kimmonismus 迅速擴大了這一消息。還有產品超出預期限制的軼事,例如 Theo 聲稱一個長期的...


