隨著 AI 工廠從百萬瓦級擴展到十億瓦級,其建置不僅需要先進的運算能力,開放標準正協助業界更快、更有效率、更可靠地擴展 AI 基礎設施。
在聖荷西麥克納里會議中心舉行的開放運算計畫(OCP)全球高峰會上,NVIDIA 宣布了新的合作夥伴關係與貢獻,旨在為下一代 AI 基礎設施建立共同基礎。
NVIDIA 在開放運算計畫(OCP)全球高峰會上宣布多項合作與貢獻,旨在為下一代 AI 基礎設施建立共同基礎。透過開放 Vera Rubin 機架與運算托盤設計,並推出 DSX AI Factory 的開源軟體元件,NVIDIA 正與 Meta、Google 等超大規模業者合作,共同推動開放標準,以更快速、高效且可靠地擴展全球 AI 工廠。
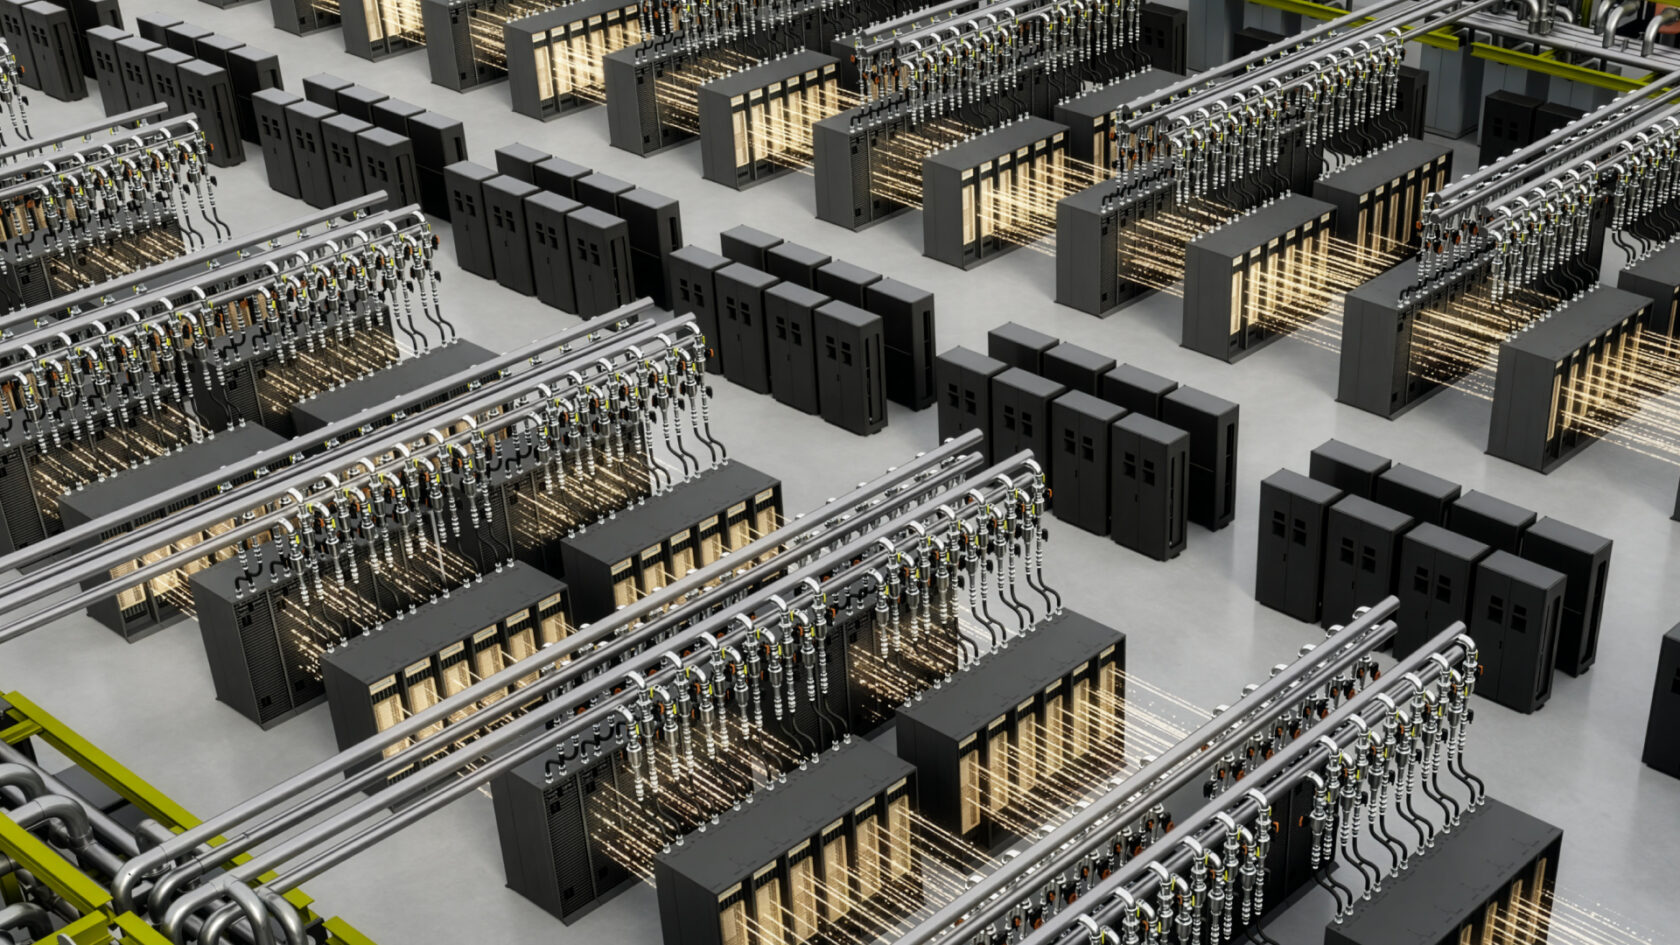
隨著 AI 工廠從百萬瓦級擴展到十億瓦級,其建置不僅需要先進的運算能力,開放標準正協助業界更快、更有效率、更可靠地擴展 AI 基礎設施。
在聖荷西麥克納里會議中心舉行的開放運算計畫(OCP)全球高峰會上,NVIDIA 宣布了新的合作夥伴關係與貢獻,旨在為下一代 AI 基礎設施建立共同基礎。
NVIDIA 透過開放的 NVIDIA MGX 架構,將關鍵的 NVIDIA Vera Rubin 機架與運算托盤設計貢獻給 OCP,為系統建置者提供了開發下一代 AI 工廠基礎設施的共同基礎。
這些努力涵蓋了 AI 工廠本身、為其供電的電網,以及現代加速運算核心的機架級架構。
NVIDIA 與合作夥伴宣布開放架構進展
在 OCP 活動中,NVIDIA 與合作夥伴發布了多項公告:
NVIDIA 與超大規模業者發布了下一代 AI 工廠的開放標準,包括 AI 工廠設計標準和電網韌性。
NVIDIA 為 NVIDIA DSX AI Factory 推出了新的開源軟體元件。
Meta 與 NVIDIA 透過 NVIDIA Spectrum-X 乙太網路 SuperNIC 和 Spectrum-6 創新,共同推進開放式 AI 網路。
Visionbay 推出適用於 Vera Rubin 時代的 800V 直流 AI 工廠設計。
NVIDIA 與 Cisco 宣布了超高密度小型可插拔(USFP)標準,這是業界首個用於 400Gb/s 網路架構的模組。
NVIDIA 與 Google 宣布未來的 NVIDIA ConnectX-10 SuperNIC 和 BlueField DPU 將支援 Falcon Transport。
在座無虛席的聽眾面前,NVIDIA 超大規模與高效能運算副總裁 Ian Buck 討論了開放基礎設施如何成為全球擴展 AI 工廠的關鍵要素。
OCP 的消息突顯了 NVIDIA 的極致協同設計結合開放標準,如何加速部署、提高能源效率並推動每瓦特處理的 token 數量效能。
Vera Rubin AI 工廠透過 OCP 的 MGX 機架貢獻取得進展
NVIDIA 與業界領導者共同透過 OCP 的開放資料中心倡議,為第三代 MGX AI 資料中心參考設計做出貢獻。
結合 MQD 和 MQDB 等開放式液冷技術,這項努力有助於將經過驗證的 AI 工廠設計轉化為業界標準,供其他廠商採用、製造和擴展。
對於 NVIDIA Vera Rubin AI 工廠,更新後的 MGX 1.2 規範擴展了 AI 工廠的開放架構,增加了機架級盲插式液冷、可互通的機架級互連基礎設施,以及為更高功率 AI 系統設計的液冷式 5,000 安培匯流排。它還增加了原生 19 英寸設備支援和更高密度的機架設計。
MGX 1.2 進一步擴展了模組化,包括可配置的 I/O 插槽、無風扇液冷運算托盤、標準化的電力和散熱介面,以及一個共同的基礎設施,有助於生態系合作夥伴建構可互通的加速運算平台。它改進了組裝、測試和服務時間,以簡化製造和現場服務,從而實現更快、更高效的基礎設施建置。該架構支援高達 250kW 的機架部署,同時簡化了可維護性、部署和基礎設施重用。
Vera CPU 機架設計規範將 NVIDIA MGX 開放架構擴展到加速運算之外,為日益發展的代理式 AI 時代提供了專用平台。雖然 Vera Rubin NVL72 作為大規模訓練和推論的基礎,但 NVIDIA Vera CPU 機架旨在支援工具呼叫、協調和沙盒執行,協助 AI 代理即時與應用程式、資料和服務互動。
Vera CPU 機架建基於第三代 NVIDIA MGX 機架架構,共享相同的機架級設計原則,將運算、網路、電力和散熱整合到一個共同的模組化平台中。這種方法使合作夥伴能夠部署專業基礎設施,同時受益於共享生態系、簡化整合和下一代 AI 工廠的一致基礎。
NVIDIA 為 DSX AI Factory 推出新的開源軟體元件
NVIDIA DSX AI 工廠平台採用極致協同設計,整合運算、網路、電力、散熱、設施和軟體,協助 AI 工廠作為一個最佳化系統運作,在可用基礎設施限制內最大化 AI 輸出。這個統一系統的核心是 DSX OS,一個開放的作業層,將 DSX 架構轉化為大規模協調、可重複的操作。
在 OCP 上,NVIDIA 擴展了 DSX OS,增加了用於配置網路、驗證叢集、管理機架和配置裸機的開源元件:
NVIDIA Config Manager:大規模自動化交換器配置,讓客戶能夠以最少甚至無需手動干預的方式部署、驗證和維護一致的 AI 工廠網路架構。
NVIDIA Cluster Readiness Engine:透過實際工作負載模擬對 GPU 叢集進行壓力測試,確保硬體健康,避免昂貴的任務崩潰,從而消除代價高昂的任務失敗。
NVIDIA Rack Management Service:提供機架硬體抽象化與操作解決方案,將機架視為一級單元,以改進 AI 工廠規模的韌體管理。
適用於 NVIDIA 基礎設施控制器的 Cluster API Provider:加速裸機部署和租戶上線,將原始 AI 硬體在數小時而非數天內轉變為可投入生產的叢集。
這些開源元件是根據 NVIDIA 營運 NVIDIA DGX Cloud 的經驗開發的,使雲端供應商和軟體合作夥伴能夠將 AI 工廠功能直接整合到他們的多租戶平台中。
開發人員可以造訪 DSX AI Factory Github 頁面,探索並貢獻 NVIDIA DSX AI Factory 平台的新舊開源軟體元件。
NVIDIA 與超大規模業者發布下一代 AI 工廠的開放標準
為了讓 AI 基礎設施在全球範圍內擴展,它需要的遠不止先進硬體,還需要整個產業可以建構的共同基礎。
在 OCP 上,NVIDIA 與 AMD、Google 和 Meta 共同發布了一項新的開放規範,確立了這一基礎。開放資料中心規範 v0.7 定義了下一代 AI 工廠設施設計的統一藍圖,從電力架構到散熱基礎設施再到實體佈局。
由 Google、Meta、Microsoft 和 NVIDIA 發布的 OCP 電網韌性規範,確立了大規模 AI 基礎設施在電網擾動期間應如何運作:保持連接、自動響應,並在不到兩秒內恢復到接近滿載的狀態。
隨著這些標準的開放,全球製造商有了共同的建置目標。設備製造商、主機代管業者和資料中心營運商可以開始設計、製造和交付為全球建設中的 AI 工廠提供動力的基礎設施層,而無需等待個別客戶的專有規範。
這些規範與 NVIDIA DSX 參考設計相容,提供了兩項規範的經過驗證、可部署的實施方案,從設施佈局和電力架構,到即時監控和響應電網訊號的軟體。對於正在建構 Vera Rubin AI 工廠的營運商來說,現在從開放社群標準到運行系統有一條直線路徑。
Visionbay.ai 為 Vera Rubin 時代設計 800VDC AI 工廠
隨著 AI 工廠變得更大、更強大,一個挑戰籠罩著所有工廠:為驅動下一代 AI 的加速運算系統提供足夠的電力。
在 OCP 上,Visionbay 公布了 K-1 的計畫,這是一個圍繞 800 伏特直流(VDC)架構設計的下一代 AI 工廠平台,並考慮到未來的 NVIDIA Vera Rubin 部署。該專案結合了 NVIDIA 的 800 VDC 參考架構與 Vertiv 的電力和散熱技術,為高密度 AI 基礎設施創建了可擴展的基礎。
該設計解決了一個日益增長的行業挑戰。隨著 AI 訓練、推論和推理工作負載的擴展,機架功率密度持續上升。傳統低壓配電變得越來越難以擴展,需要更多的銅、更多的電纜和更多的電力轉換設備。
透過採用 NVIDIA 的 800 VDC 架構,K-1 為更高密度的 AI 基礎設施創造了一條路徑,同時保留了現有部署的靈活性。該平台並非要求第一天就完全轉換,而是旨在逐步引入 800 VDC 配電,在效益最大化的地方應用,協助營運商為未來幾代的加速運算做好準備,而無需大規模設施重新設計。
該架構圍繞叢集級電力中心設計,這些中心集中了交流轉直流(AC-to-DC)轉換,並將 800 VDC 分配到更靠近運算資源的地方。這種方法簡化了下游電力傳輸,支援模組化擴展,並為未來 AI 工廠的增長創建了可重複的建構區塊。
K-1 也反映了 NVIDIA AI 工廠背後的系統級設計理念,其中電力、散熱和運算是一起設計的。憑藉對液冷基礎設施、可擴展電力分配和未來 Vera Rubin 級部署的支援,該專案展示了生態系合作夥伴如何將 NVIDIA 的 AI 工廠架構轉化為為下一代加速運算設計的可部署基礎設施。
在活動中,Meta 與 NVIDIA 宣布,Meta 將採用 NVIDIA Spectrum-6 102.4Tb/s 乙太網路交換器,在開放網路基礎上建構更大、效能更高的 NVIDIA Vera Rubin AI 工廠。
Spectrum-6 提供 Spectrum-4 兩倍的交換容量和每通道頻寬,並提供每通道 200G 的無損乙太網路 AI 網路,具有高有效頻寬和效能隔離,可防止一個任務的流量減慢另一個任務的速度。
Meta 基於 Spectrum-6 的交換器 N-IceCube,可插入 Meta 的 100T 液冷機架 IcePack 中。N-IceCube 運行 Facebook 開放交換系統(FBOSS),這是 Meta 的開源網路作業系統,已貢獻給 OCP 以支援超大規模的高效網路。
FBOSS 建基於交換器抽象介面(Switch Abstraction Interface),這是一個 NVIDIA 協助開發的 OCP 標準,提供了一種獨立於供應商的交換器硬體控制方式。這些技術共同支援超過 10 萬個 GPU 的代理式 AI 工廠,用於訓練和服務大規模專家混合模型。
這項宣布標誌著 Meta 在超大規模營運 AI 基礎設施的經驗與 NVIDIA 網路技術結合的合作邁出了下一步。
這項合作的核心是 Spectrum-X 多平面技術,由 Spectrum-6 交換器和 ConnectX-9 SuperNIC 實現。多平面在硬體層面將 GPU 流量分散到最多八個獨立的網路平面,使 AI 工廠能夠擴展到超過 10 萬個 GPU,同時減少交換器層級並降低基礎設施成本。
GPU 之間的多重路徑提高了網路利用率和韌性:當組件故障時,流量會轉移到剩餘的平面,即使頻寬降低,也能保持 GPU 的生產力並使 AI 應用程式持續運行。
Meta 與 NVIDIA 透過部署經驗和快速工程迭代,共同加強了這種韌性。團隊在內部部署和雲端環境中驗證了改進。
Meta 資料中心與 AI 網路資深總監 Omar Baldonado 表示:「我們很高興與 NVIDIA 緊密合作,使多平面網路架構在操作上具有可擴展性和高效能,這對我們自己的基礎設施建置以及我們的共同雲端合作夥伴來說都是關鍵要求。將 FBOSS 擴展到 Spectrum ASIC 意味著我們可以在整個網路架構中運行相同的軟體堆疊,而 Meta 新的基於 Spectrum 的交換器 N-IceCube 將其引入 Icepack,我們的液冷機架。」
覺得值得一看?分享給朋友。
以上為 AI 自動翻譯導讀。原文版權歸 NVIDIA Blog 所有, 建議透過「閱讀原文」前往原始網站,以取得最完整資訊並支持原作者。
43 個來源、每 2 小時更新,太多看不完。電子報每週挑最值得看的幾則,附上 Max 的看法。

