由 SerpAPI 榮譽呈現:今天的發布內容涵蓋廣泛,但您可以將所有這些資訊抓取成 Markdown 格式,供您的 AI 代理使用。JSON 格式的 Token 成本可減少 50%。
我們上次在四月報導了推論拐點,歷史上大多數進展都來自 Fireworks、Baseten 和 Modal 等閉源的獨角獸公司。現在,是時候讓開源社群做出回應了。在 PyTorch Conf 的第一天,DeepSeek 向業界投下了一枚洲際彈道飛彈,開源了 DeepInfer,這是他們的生產堆疊,能夠實現長達 72 小時的提示詞快取,遠超 OpenAI 剛宣布的 12 小時。
DeepSeek 在推特上表示:「隆重推出 DeepInfer,我們的內部推論框架,現已完全開源!它以高吞吐量和低延遲大規模驅動 DeepSeek-V4.1-Flash。我們正在分享我們的生產堆疊,以幫助社群降低運算成本,減少能源使用,並使 AI 更…」
DeepInfer 是他們對 vLLM 的客製化版本,並借鑒了 SGLang 和 TRRTLLM 的成果,但增加了許多內容,除了他們的「皇冠上的寶石」:超優化的 KV 快取(緊湊且壽命超過 8 小時)、PD/解聚合以及負載平衡(他們的 3FS 已於一段時間前開源)。我們已將他們的部落格文章翻譯並發布,同時提供完整的技術指南、解釋、程式碼對應和子系統指南。
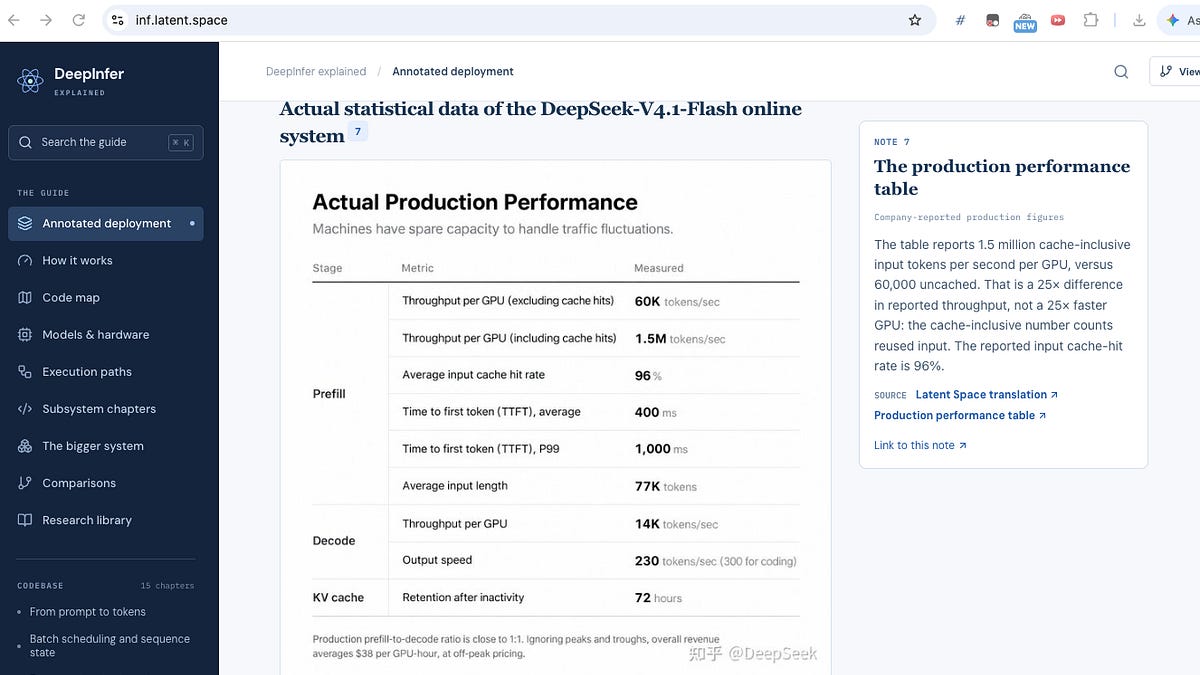
正如我們在他們額外披露的資訊中指出的,他們聲稱每天處理 155 兆 Token,以離峰價格計算(目前輸入/輸出 Token 每百萬分別為 0.15 美元/0.60 美元),每張 SM100/A950 顯示卡每小時可產生 38 美元收入。根據他們的生產數據(我們已翻譯),每台預填充 GPU 每秒處理 150 萬個包含快取的輸入 Token,輸入快取命中率達 96%,每台解碼 GPU 每秒輸出 14,000 個 Token(約 2400 個 GPU),總成本每張顯示卡每小時 5-8 美元,這意味著推論利潤率超過 80%!
經過叢集計算,這大約是每 GW 1660 億美元,推論利潤回收期為 81 天(DeepSeek 以 10 個月回收期聞名)。想像一下,如果擁有更多 GW,這家巨頭能做些什麼。
由 SerpAPI 贊助!為您的 AI 代理提供即時搜尋數據,並減少 Token 消耗。透過 SerpApi 的 100 多個 API,以乾淨、結構化的 Markdown 格式接收結果,平均比 JSON 格式減少約 50% 的 Token 消耗。只需添加 output=md 或使用 /search.md 端點即可。它無需任何配置,並包含在所有方案中,無需額外費用。
這是 2026 年 10 月 19 日至 20 日的 AI 新聞。我們檢查了 12 個 Reddit 子版塊、544 個 Twitter 帳戶,但沒有進一步的 Discord 資訊。AINews 的網站允許您搜尋所有過往的發布內容。提醒您,AINews 現已成為 Latent Space 的一個版塊。您可以選擇接收或不接收電子郵件頻率!
頭條新聞:DeepSeek DeepInfer,生產推論、開源界限與快取 Token 的經濟效益。DeepSeek 發布了 DeepInfer,這是 V4.1 Flash 背後的推論引擎,同時披露了生產服務的詳細資訊,使得這份工程報告與程式碼本身一樣重要。
這次發布涵蓋了推論引擎和 API 處理層。DeepInfer 支援分散式推論、推測解碼、SWA Bounded Replay 和 NVIDIA 及華為昇騰平台上的結構化輸出。隨附的 deepseek-recipe 元件實現了生產 Token 編碼/解碼和與官方 API 相容的處理。DeepSeek 表示,未來的模型推論實現和優化也將出現在這個儲存庫中。
報告的生產數據非常可觀,但描述的是一個高度快取的服務。DeepSeek 的工程報告,如所提供文章中總結和引述的,報告一個叢集每天處理 155 兆 Token,輸入快取命中率達 96%,首次 Token 平均時間為 400 毫秒,生成速度為 230 Token/秒,程式碼生成可達 300 Token/秒。
它還報告在離峰價格下,每個加速器每小時收入 38 美元。這些是第一方的生產聲明,並非獨立審計的測量結果。
「完全開源」並不意味著整個生產服務可以從這次發布中完全重現。儘管 DeepSeek 將 DeepInfer 描述為完全開源,但技術說明指出,KV 快取管理和負載平衡元件尚未完全發布,因為它們仍與內部基礎設施耦合。引擎是開源的,但重要的服務級協調仍是部署的責任。
vLLM 提供了最具體的比較回應。vLLM 團隊承認 DeepInfer 最初主要基於 vLLM 並以 Apache 2.0 許可證發布後,報告稱在匹配配置下,GB200 上的解碼吞吐量與 DeepInfer 公布的結果相差不到 6%。它還發布了 AgentX 結果和重現方法,實質上質疑了 DeepSeek 效率對於現有開源引擎來說是不可企及的說法。
這次發布引發了兩場不同的辯論:DeepSeek 是否擁有獨特的強大服務堆疊,以及其披露的資訊是否普遍證明了高推論獲利能力。第一個問題現在有了比較基準證據;第二個問題仍然對工作負載組合、快取計算、硬體成本以及包含哪些費用敏感。
DeepInfer 披露的架構將視覺編碼、預填充和解碼分開,允許每個階段根據其瓶頸進行擴展。建議的部署形式是預填充使用普通的八加速器機器,解碼使用 64-128 加速器的超級節點。解碼使用寬專家並行性來分佈 MoE 專家,同時保持較大的有效批次。這些是部署建議,並非 DeepSeek 生產叢集確切硬體組成的充分證據。
排程細節解釋了為什麼傳統的「每批次 Token 數」比較可能會錯過實質性差異:預填充排程估計注意力計算成本。工作是根據估計的計算量而非單純的原始請求長度來分配的。區塊大小會根據時間預算而變化,而不是在異質請求中強制執行一個固定的區塊大小。
預填充路由不需要快取親和性。由於快取的前綴被匯集在共享儲存中,請求可以發送到任何可用的工作者,而不是之前服務其前綴的工作者。在一份詳細的中文分析中,推論工程師蘇金燕強調這是一個特別有用的生產設計:預填充數據並行組在「計算 Token」上平衡,而共享儲存提供可重用的狀態。同一分析還強調了請求分桶和帶有運行時估計器的 FIFO 排程。
解碼路由平衡了運行中請求的數量和 KV 快取的長度。請求數量近似於排程壓力;累積的 KV 長度捕捉了單純請求數量無法捕捉的記憶體/狀態壓力。工程評論將預填充的擴展訊號描述為總體計算負載,將解碼的擴展訊號描述為運行中的請求。
專家並行負載平衡複製了受歡迎的專家。副本會定期重新分佈,以減少因路由傾斜導致的設備間等待。這是一種以額外 HBM 消耗換取更高吞吐量的權衡,隨著複製增加,回報會遞減;有用的複製因子是工作負載特定的。
CPU 排程與加速器執行重疊。非同步排程消除了解碼步驟之間的閒置間隙,而不是將主機端協調視為免費。
一個值得注意的技術觀察是,在披露的 Blackwell 配置中似乎沒有張量並行性。一位評論員將此與預設的 vLLM/SGLang 方法進行對比,並將這種方法追溯到 DeepSeek V3 的 H800 時代互連限制。這是一種對配置的解釋,並非證明張量並行性普遍較差。
規模也很重要。蘇金燕認為,寬專家並行預填充需要足夠的流量和工作者才能發揮效益,並建議對於只有少量預填充工作者的中小型部署採用管線並行。作者還指出,層異質性可能會使管線劃分複雜化。這是實踐者的判斷,並非建立普遍交叉點的基準測試。
快取設計是吞吐量、代理工作負載和每個加速器報告收入之間的關鍵連結。持久區塊 KV 存在於一個獨立的 3FS 儲存叢集中,擁有約 100 PiB 的 SSD 容量。報告的保留時間為代理流量三天,聊天機器人流量七天。任何預填充工作者都可以檢索快取的前綴,將快取局部性與計算位置解耦,並允許儲存和計算獨立擴展。
這種保留對於重複發送不斷增長的指令歷史、儲存庫內容、工具輸出和先前回應的代理非常有用。這也意味著每天服務的 155 兆 Token 不應被解讀為每天新生成的 155 兆 Token:快取命中是服務 Token 計算的一部分,而新計算的預填充和自回歸輸出會產生非常不同的成本。因此,報告的 96% 輸入快取命中率是頭條吞吐量的關鍵背景資訊。
實作解決了兩種不同的狀態生命週期:持久區塊快取是異步載入的。主機到設備的傳輸與層執行重疊。蘇金燕強調了一個較低層次的實作細節:細粒度 KV 區塊複製透過 CUDA 複製引擎執行不佳,因此描述的路徑使用基於 GDR/RDMA 的傳輸,旨在飽和 PCIe 頻寬而不佔用 SM。這是一個基於報告的技術觀察,並非推文中單獨測量的結果。
滑動視窗注意力狀態保留在主機記憶體中,而不是持久 SSD 儲存中。它主要在活躍會話中發揮作用,並且比可重用區塊前綴的生命週期更短。
SWA Bounded Replay 僅從最新的 128 個 Token 重建缺失的短期狀態。Replay 將注意力限制在該片段,同時重用持久區塊快取,產生一個近似值,而不是重建整個先前歷史的狀態。DeepSeek 報告稱,這幾乎將總預填充計算量減半。這種近似及其模型特定的有效性在考慮可移植到其他架構時很重要。
蘇金燕補充報告稱,長期的保留尾部僅增加了約 0.5-1 個百分點的額外快取命中率,說明了儲存容量與重新計算之間的權衡。同一評論建議,由解碼主導的快取管理允許生成的輸出在後續回合中成為可重用的前綴狀態。
這次發布的時機引發了與 OpenAI 另外宣布的 12 小時 API 提示詞快取(相對於其 30 分鐘的預設值)的比較,包括請求中混合的保留期限。這些並非相同的產品或架構,但兩者都針對在長時間間隔內重用上下文的持久代理。動態消息中關於無限登入快取的其他說法是評論,並非 API 公告的條款。
DSpark 使推測驗證具有適應性。它預測草稿 Token 的接受機率,並改變驗證長度以最大化預期吞吐量。DeepSeek 報告稱,與始終驗證五個草稿 Token 相比,生產吞吐量提高了 6%。這是相對於特定推測解碼基準的增量收益,而不是相對於非推測解碼的 6% 收益。
deepseek-recipe 解決了服務介面,而不僅僅是 Tokenizer 速度。它支援 Chat Completions、Responses 和 Messages API,並行化 Tokenization,並區分真實的。