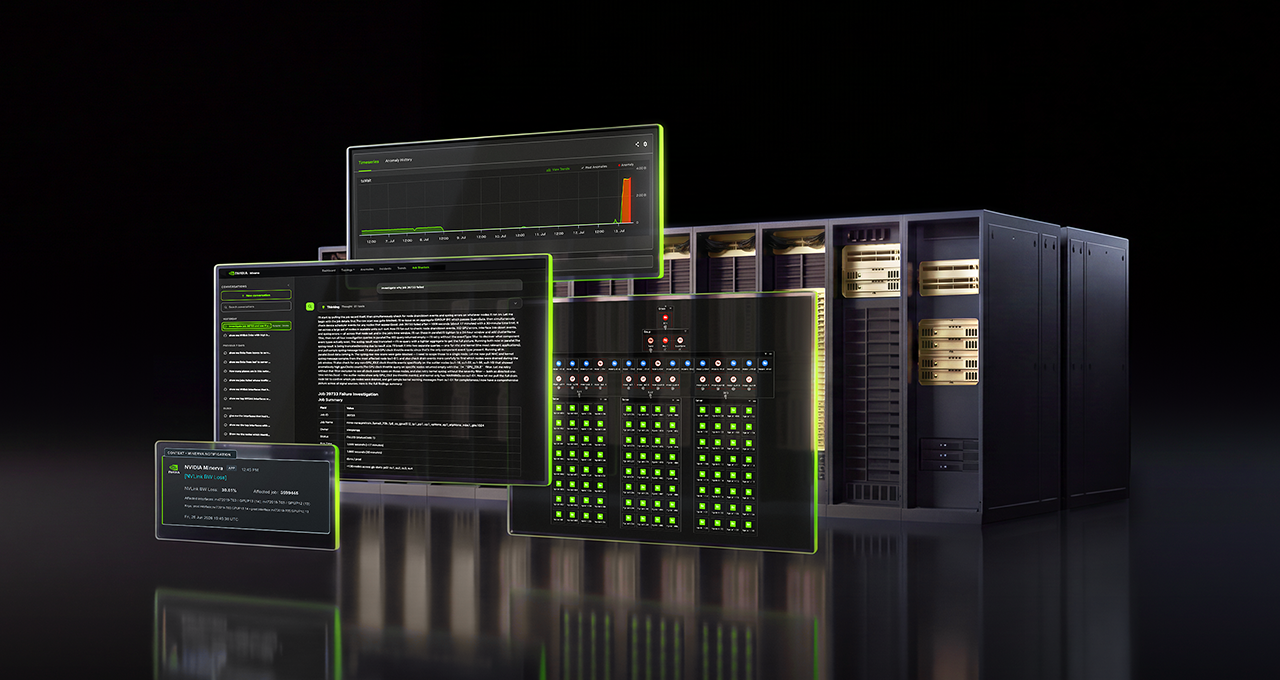
NVIDIA Minerva 是一個今日發表的智慧維運(AIOps)平台,旨在幫助團隊及早發現問題並維持 AI 工廠的生產力。它整合了基礎設施和 AI 工作負載的遙測數據,然後應用專門建構的 AI 模型,將這些數據轉化為及時且可執行的洞察。
AI 工廠是世界上最複雜的運營之一,其中大量的 GPU 透過高速網路協同工作,以訓練模型和服務 AI 應用程式。在這種規模下,一個單一的降級元件就可能拖慢整個任務。警告訊號可能很容易被忽略,例如一個 GPU 運行溫度高於其他同儕,或者一個 NVMe 磁碟在負載下性能下降。
該平台專注於 AI 工廠的「良率」,這是一個衡量基礎設施透過 GPU 工時、有效吞吐量(goodput)、叢集正常運行時間和 token 產出所產生的有用工作的指標。
提供 AI 工廠的動態視圖
傳統的監控工具通常將資料中心劃分為獨立的視圖。網路、運算、站點可靠性(SRE)和機器學習團隊各自看到運營的不同部分。Minerva 則將這些訊號串聯起來,涵蓋 NVIDIA GPU、網路、儲存、排程器和工作負載。
透過這些訊號,Minerva 建立了一個動態知識圖譜,邏輯性地映射了基礎設施(GPU、SuperNIC、交換器和纜線)以及在其上運行的任務。這種上下文有助於操作員追溯緩慢的訓練任務,找出影響它的元件,即使是在擁有數十萬個 GPU 的工廠中也能做到。
它每小時分析數十億個數據點,使用監督式和非監督式機器學習。它學習正常行為,檢測以前未見的異常,預測即將發生的故障,並根據工廠的拓撲結構關聯相關事件。它不是將每個症狀都發送給操作員,而是能將事件風暴歸類為一個重點事件,並指出可能的根本原因。
Minerva 內建 AI 助理,並可連接到外部的代理式 AI 工具。這增加了一個基於即時遙測數據的自然語言介面。操作員可以透過對話查詢叢集健康狀況,並接收建議的修復方案。團隊可以選擇讓人力介入手動實施修復,或者透過基礎設施應用程式介面(API)和外部系統將 Minerva 連接到自動化流程。
最大化 AI 工廠良率的成果
關聯工作負載和基礎設施問題的能力,以及其代理式 AI 功能,有助於簡化 AI 工廠的運營。Minerva 將相關問題匯總為單一可執行的項目,而不是處理鋪天蓋地的警報。這使得智慧維運團隊能夠從被動維護轉向主動維護。所有這些都有助於 AI 工廠最大化 GPU 的正常運行時間。
Minerva 為 AI 工廠關注的關鍵指標帶來價值:
更長的無中斷運行時間:Minerva 在問題發生之前就發現它們,因此任務可以運行更長時間而不會發生事故。
更快的修復時間:當事件確實發生時,Minerva 能精確定位問題,從而顯著加快解決速度。
更深入的洞察:現代 AI 基礎設施產生大量數據;Minerva 將其過濾掉,只留下少數真正重要的警報。
IREN 是使用 Minerva 優化其 AI 工廠的 NVIDIA 合作夥伴之一。
IREN 技術長 Denis Skrinnikoff 表示:「隨著我們擴展 AI 工廠,為客戶提供最佳服務的關鍵是最大化我們 GPU 的生產力。NVIDIA Minerva 讓我們的運營團隊能夠全面檢視網路、GPU 及在其上運行的任務,因此我們能更專注於主動維護,而非故障排除。這種可視性強化了我們為未來基礎設施建立的運營模型。」
除了 IREN,Aolani、Bitdeer AI、IBM、Jio、Lambda、Quake AI 和 Tesla 也計劃部署 Minerva。
此外,Dell Technologies、Lenovo 和 Supermicro 也將把 Minerva 作為其 AI 工廠運營產品組合的一部分提供。