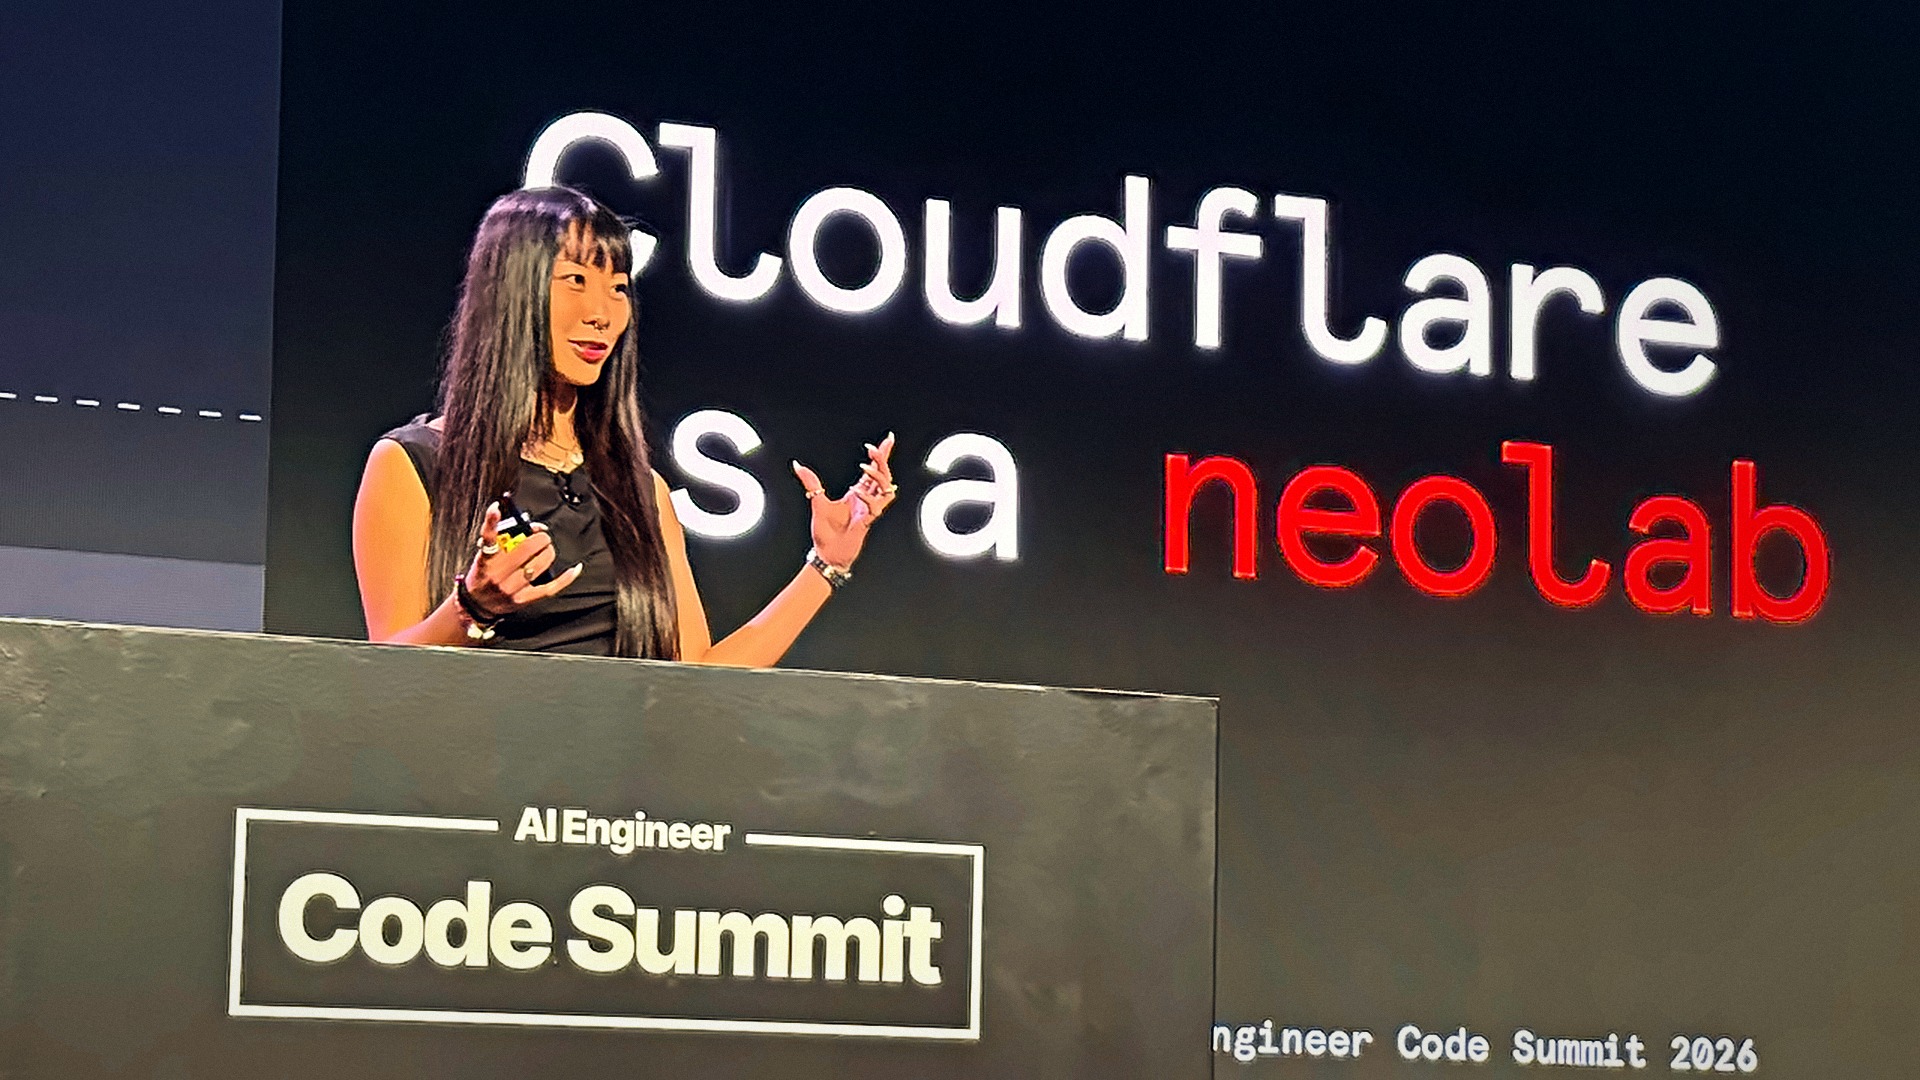
過去十五年來,Cloudflare 一直是網路不可或缺的基礎設施公司之一。然而,根據 Cloudflare 產品端 AI 平台負責人 Michelle Chen 在 AI 工程師程式碼峰會上的演講,該公司正轉型為一個「新實驗室」(neolab)。
簡單來說,新實驗室就是那些開發模型但並非 OpenAI 或 Anthropic 的公司。Cloudflare 之所以自稱新實驗室,是因為它也開始推出自己的模型,確切來說是兩款 System One 模型:Clef 和 Clairic。Chen 在演講中解釋,Clef 是一個決策模型,直接受到 TypeSafe AI 革命性 Jev 模型的啟發,而 Clairic 則是 Cloudflare 稱之為「提取」模型的新型 System One 模型。
Chen 在演講後接受 Latent Space 採訪時暗示,Cloudflare 不會只生產 System One 模型,未來也將推出大型語言模型(LLM)。她表示:「我們成為新實驗室的目的,不只是為了推出 System One 模型,儘管這對我們的基礎設施來說很有意義。
我們現在已經打開了潘朵拉的盒子,可能性是無限的。」Chen 補充說,他們不僅在研究 System One 模型,還可能包括推理模型和其他 LLM 等。
不過,她也提到這些模型可能不會是像頂尖實驗室那樣從頭開始預訓練的模型。她認為:「這不是我們的重點,但我認為我們可以利用現有的資源,使其更有效率和效益。」她指出,他們團隊的大部分工作都集中在「後訓練」階段,這將是模型開發的重點。
那麼,什麼是「新實驗室」,Cloudflare 真的符合這個定義嗎?「新實驗室」這個詞字面意思是「新的實驗室」,由 The Information 的 Stephanie Palazzolo 在去年 11 月提出,她將其定義為「新一代專注於研究的 AI 新創公司」。
Menlo Ventures 的合夥人兼 AI 意見領袖 Deedy Das 維護著一份龐大的新實驗室清單,其中包括 Thinking Machines Lab、Poolside 和 TypeSafe AI 等公司。
根據 Das 的說法,新實驗室通常僱用頂尖研究人員,投入大量運算資源(通常用於訓練自己的 AI 模型),尚未有顯著的營收表現,而且通常是已募得大量資金的新創公司。然而,Cloudflare 至少不符合其中一半的條件,因為它是一家上市公司,擁有可觀的營收。
事實上,本月初 Cloudflare 宣布了創紀錄的財報。執行長 Matthew Prince 表示:「第三季是 Cloudflare 有史以來表現最好的一季,我們年度營收突破 30 億美元,本季營收達 7.82 億美元,年增 39%。」因此,Cloudflare 自稱「新實驗室」顯然是挑戰了這個詞的既定定義。
然而,正如 Chen 在演講中所述,開發模型是該公司自然發展的一部分:從基礎設施,到運算(例如 Workers 平台,現在也支援代理),再到儲存,接著是透過 Workers AI 提供 Kimi、GLM 和 DeepSeek 等開源模型,直到現在開發自己的模型。
Chen 坦承 Jev 模型啟發了 Cloudflare 轉向模型開發。她引用一句中國諺語,將 Jev 在九月的出現比喻為「東風」,意外地改變了 Cloudflare 對 AI 模型的看法。
Chen 在演講中說:「當 System One 和 Jev 的典範開始出現時,我們覺得這對我們來說非常有意義,對吧?我們不必將每個請求都發送給 LLM,我們可以將其中一部分發送給 System One 模型。」
在我們的對話中,Chen 提到他們只花了兩週就開發出 Clef(Jev 的複製品),而 TypeSafe AI 則花了兩年才開發出 Jev。她此言是為了讚揚 TypeSafe AI 在創造這種新型模型上所付出的努力。她說:「所有功勞都歸於 TypeSafe,他們確實開拓了這個領域,並在這裡發明了新東西,讓大家能產生強烈共鳴並加以使用。
是的,我們很快就開發出模型,但他們做了大量的基礎工作,我們也清楚 API 結構應該是什麼樣子。」
Cloudflare 的核心本質仍然是一家基礎設施公司,速度和低延遲是其主要優勢。Chen 指出,System One 模型的主要好處是,它們能讓更小、更快的模型完成更多工作,其輸出時間以毫秒而非秒來衡量。
儘管 Clef 是 Jev 的複製品,Cloudflare 很快就推出了對 System One 的獨特創新:Clairic。Clairic 上個月發布,被譽為「新型 System One 提取模型中的第一個」。Chen 在演講中解釋:「Clairic 的作用是接收非結構化輸入,並從中提取、計算、估計和預測數值。」
在我們的採訪中,Chen 表示她的團隊希望利用 System One 的原則,找出 LLM 表現「過度」且不總是能返回正確答案的其他領域。他們解決的問題之一是 LLM 不總是能很好地處理非結構化輸入。Chen 解釋說,由於 LLM 是自迴歸的,它們容易產生幻覺,有時會返回格式錯誤的 JSON。
她說:「所以我們在那裡使用了與 Jev/Clef 相同的 System One 原則,並決定採用提取功能。」她舉了一個發票的例子,LLM 有時會弄錯重要的細節,例如訂單號碼。她說:「當你把訂單發送給 LLM 時,它們會說,等等,我認為訂單號碼是三,也許是四,也許是五。
但實際上,數字就在那裡,你只需要讀取它!」因此,Clairic 的想法是,它將在一次前向傳遞中,從非結構化數據中提取像數字這樣的類型化值。
現在 Cloudflare 為何要投入實驗室開發?使用「新實驗室」這個標籤聽起來有點像行銷噱頭,但對 Cloudflare 來說,生產 System One 模型,甚至未來開發推理模型,都非常有意義。Chen 在演講中表示:「成為新實驗室意味著我們可以創造我們所缺乏的東西。」
在我們的採訪中,她也提到開發自己的模型讓 Cloudflare 能夠降低其 AI 營運的風險。她說:「我認為 AI 領域存在很多風險,就像 Jev 是閉源的我們無法運行一樣,市面上有很多模型可能存在監管風險,例如中國的開源模型。我認為許多模型實驗室也希望賺錢,因此會實施相當昂貴的授權。」
如果你現在查看 Cloudflare 的產品頁面,它就像 Web 2.0 巔峰時期 Amazon 雲端運算產品頁面的樣子,也就是說,上面有很多東西!但仍有空間容納更多模型。