輝達的 Ian Buck 週一在芝加哥舉行的 SC26 大會上,為公司本週的活動揭開序幕,並發表了專為 AI 代理設計的新工具。這些軟體代理能夠在研究人員自己的系統上規劃實驗、執行程式碼並檢查結果。
在輝達的特別演講中,Buck 宣布推出 Nemotron for Science、Rubin HPC GPU 以及擴展用於高效能運算的 Vera CPU 平台。他也詳細說明了與 IBM 和費米國家加速器實驗室在量子運算領域的新合作計畫。
輝達(NVIDIA)在 SC26 大會上發表了多項創新,包括專為科學研究設計的 AI 代理工具 Nemotron for Science。同時,公司也推出了 Rubin HPC GPU 和擴展的 Vera CPU 平台,以強化高效能運算能力。此外,輝達還宣布與 IBM 和費米國家加速器實驗室合作,共同推動量子運算發展。
輝達的 Ian Buck 週一在芝加哥舉行的 SC26 大會上,為公司本週的活動揭開序幕,並發表了專為 AI 代理設計的新工具。這些軟體代理能夠在研究人員自己的系統上規劃實驗、執行程式碼並檢查結果。
在輝達的特別演講中,Buck 宣布推出 Nemotron for Science、Rubin HPC GPU 以及擴展用於高效能運算的 Vera CPU 平台。他也詳細說明了與 IBM 和費米國家加速器實驗室在量子運算領域的新合作計畫。
輝達超大規模與高效能運算副總裁 Buck 表示:「運算的前沿和新的科學堆疊,將一如既往地是模擬,但會結合 AI 和未來的量子運算。」
Buck 在演講開場時回顧了 20 年前,他在佛羅里達州坦帕市的 SC06 教學課程中,首次公開談論 CUDA 的情景。他指出,輝達現在提供了超過 1,000 個 CUDA-X 函式庫。
Buck 提到,AI 代理已經徹底改變了我們與超級電腦、裝置、儀器互動的方式,以及我們進行研究的方法。
他強調,模擬仍然是科學運算的基礎,將永遠處於核心地位,而 AI、量子運算以及現在的 AI 代理則與其協同運作。
Buck 解釋說,Nemotron for Science 將 Nemotron 3.5 Super VL 開源模型,與新的開源化學資料集以及生命科學和化學領域的後訓練配方結合。研究人員可以在 DGX Spark、工作站或自己的超級電腦上本地執行它。
Buck 表示,在阿貢國家實驗室,一個使用該工具包建構的 AI 代理,僅透過一個提示詞,就規劃並測試了假設,選擇要執行的模擬,並識別出兩個新的結合位點。
Buck 強調:「你擁有自己的資料,你擁有自己的模型。」
Buck 也點出其他已在使用的 AI 代理:
瑞典皇家理工學院(KTH Royal Institute of Technology)開發的 GROMACS 代理,能夠自行修復損壞的 GROMACS 設定。在一次單一 DGX Spark 的隔夜運行中,它修復了 81% 的測試案例。
SETI 協會(SETI Institute)在艾倫望遠鏡陣列(Allen Telescope Array)中,一個 AI 代理透過一行提示詞繪製了甲醇譜線。Buck 解釋說,它隨後自行調整了都卜勒頻移。
輝達的新 Nsight AI Porting Agent 將天氣研究與預報模型(WRF)中的一個例程移植到 GPU 上,Buck 表示,這將速度提升了五倍以上,使用了約 1.5 億個 token。
Buck 解釋,AI 代理在模型步驟之間執行工具呼叫時,需要依賴 CPU。
他表示:「這正是 AI 代理所需要的,它們需要一個能夠運行、評估、執行工具、執行操作並收集結果的 CPU。」
德國氣候運算中心(DKRZ)已選擇 Vera CPU 用於其 HLRE-5 超級電腦,預計於 2028 年初啟用。Buck 表示,它將加入德州先進運算中心(Texas Advanced Computing Center)已宣布的 Vera 系統。
Rubin HPC 是 Vera Rubin 平台中的一款新 GPU,專為科學、工程、分析和 AI 而建。
它支援從 FP64 到 FP4 的精確度,增加了稀疏資料加速功能,並透過第七代 NVIDIA NVLink 連接。Buck 表示,它擁有超過 50,000 個 CUDA 核心,大約是 Hopper 的三倍。預計於 2028 年推出。
Buck 表示,在尤利希研究中心(Jülich)的 JUPITER 超級電腦上進行的模擬顯示,一種稱為「魔術狀態培養」(magic state cultivation)的技術,可以將一個邏輯步驟所需的操作次數減少十倍。這項工作正被加入 CUDA-Q 中。
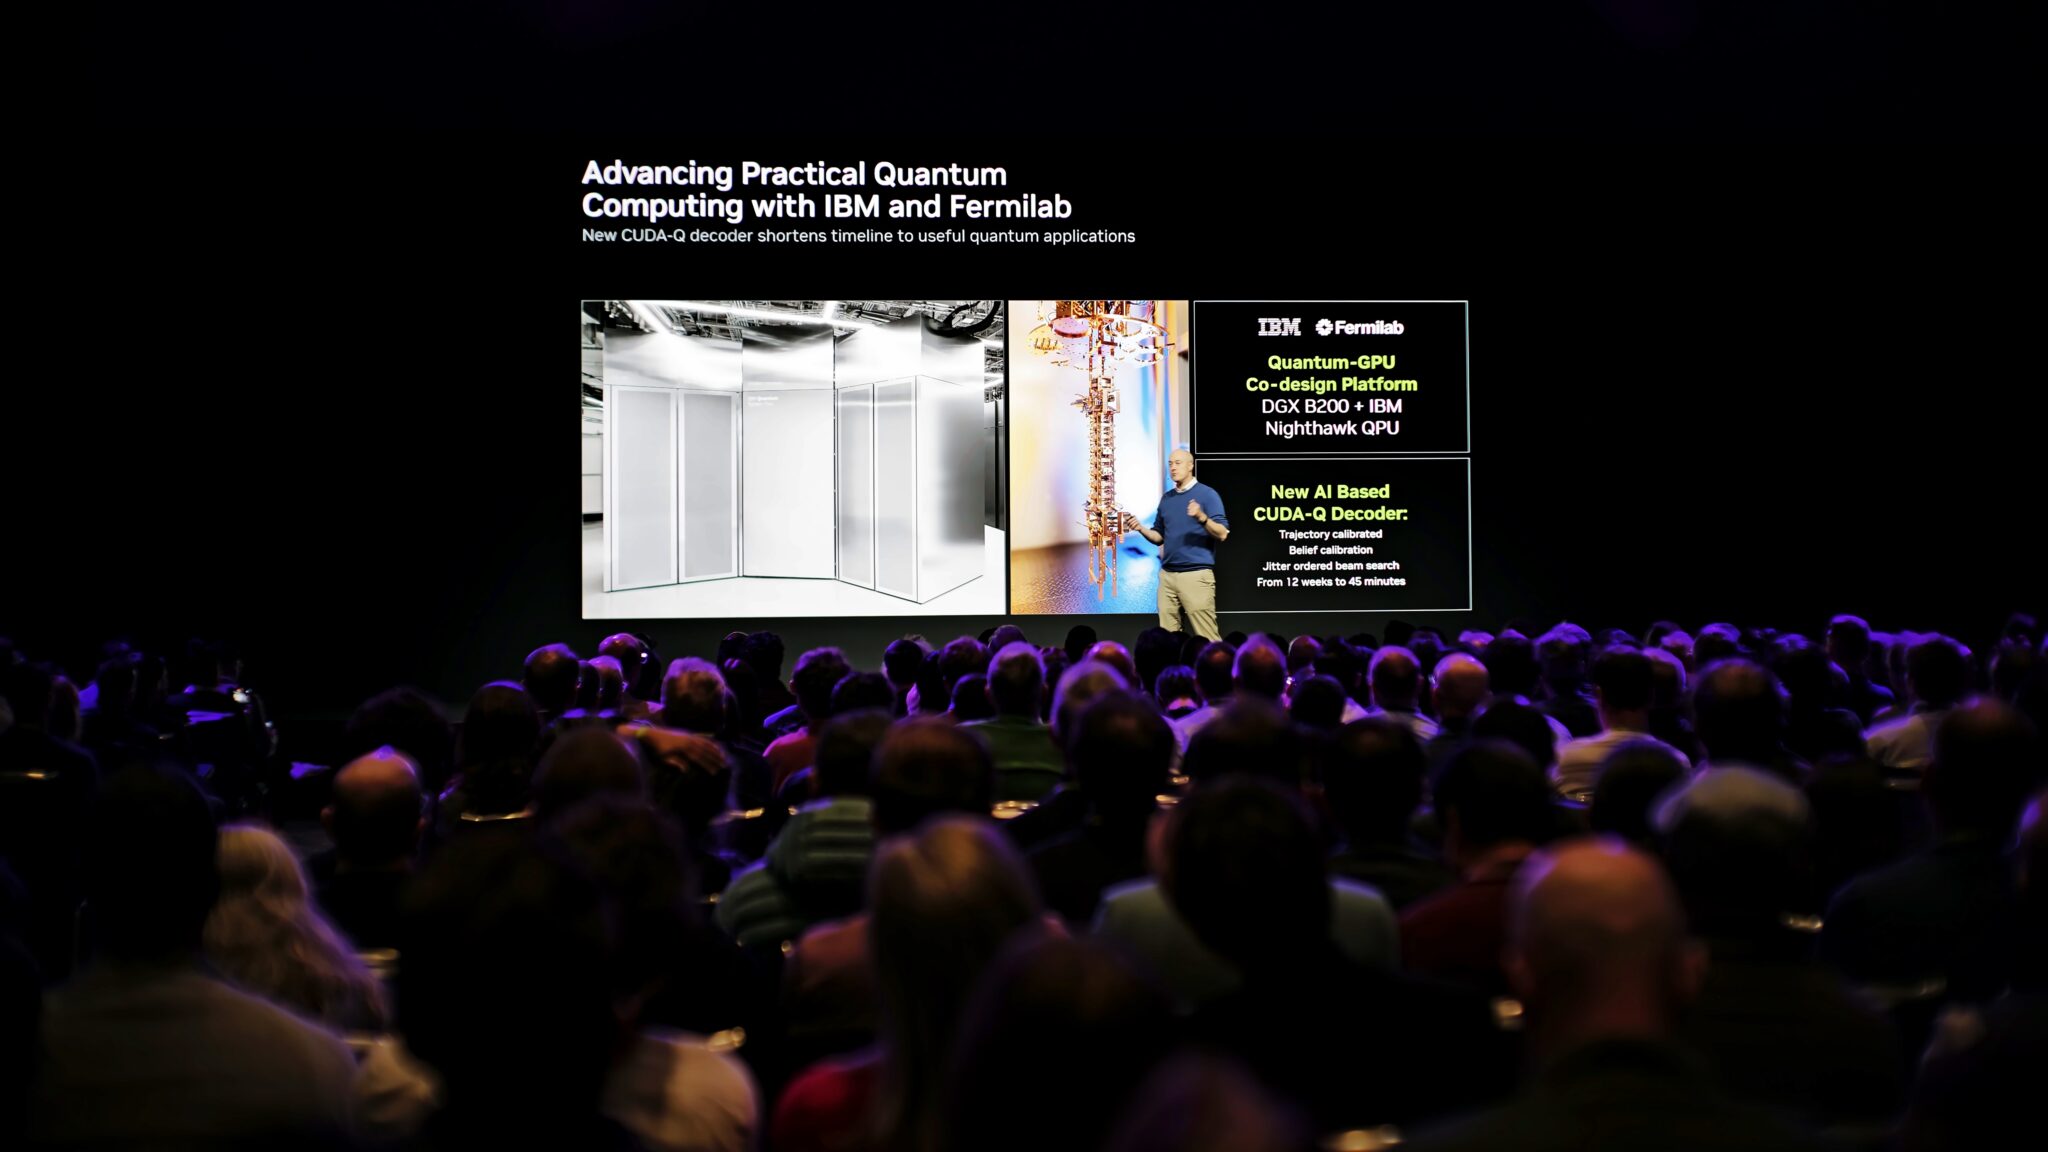
輝達、IBM 和費米國家加速器實驗室今天宣布,計劃建立一個量子運算協同設計平台,以支援錯誤修正和應用研究。輝達和 IBM 將把輝達 DGX B200 系統與 IBM 量子電腦(包括由 IBM Quantum Nighthawk 驅動的電腦)配對。
Buck 還介紹了量子解碼方面的新突破。他解釋,目標是將解碼延遲從約 300 微秒縮短到 10 微秒。一種新的 CUDA-Q 解碼演算法 TCBP-JOBS,將錯誤修正研究的運算時間從 12 週縮短到 45 分鐘。
Buck 還展示了輝達 Photonics 共同封裝光學交換機的首批部署之一,地點在 Lambda。他表示,它們在位元錯誤和鏈路抖動方面的可靠性提高了 15 倍。
覺得值得一看?分享給朋友。
以上為 AI 自動翻譯導讀。原文版權歸 NVIDIA Blog 所有, 建議透過「閱讀原文」前往原始網站,以取得最完整資訊並支持原作者。
43 個來源、每 2 小時更新,太多看不完。電子報每週挑最值得看的幾則,附上 Max 的看法。