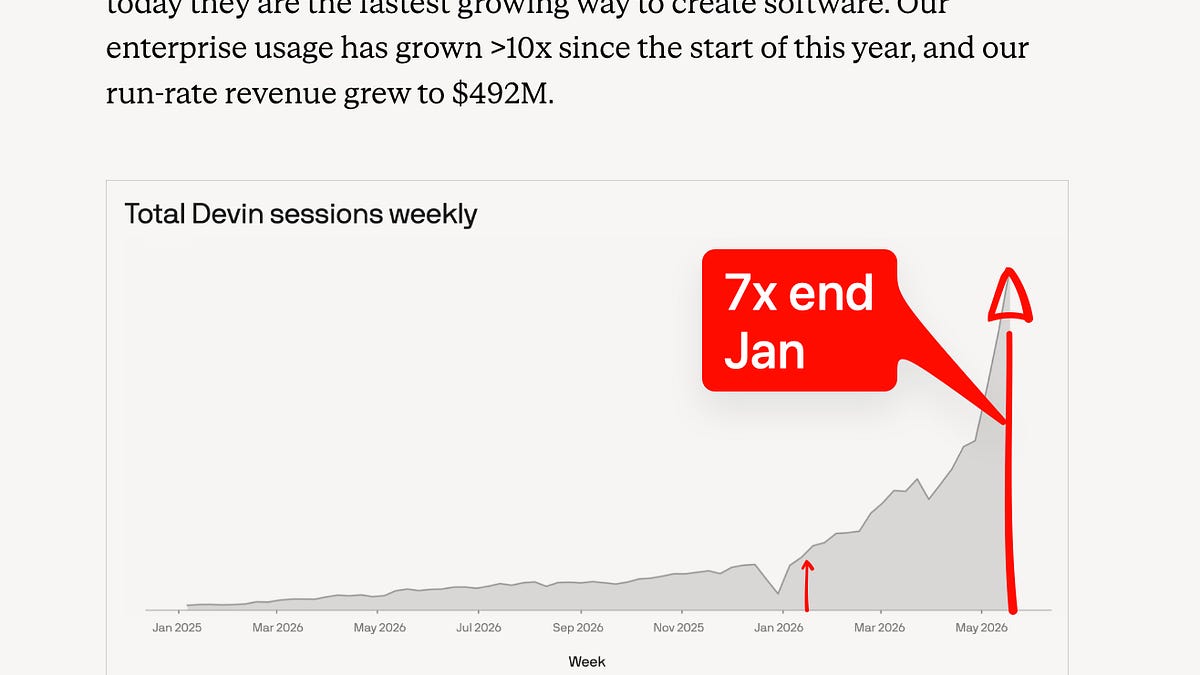
我們上次報導 Cognition 是在去年九月的 100 億美元 C 輪募資,當時 Smol.ai 也加入了 Cognition,而 AINews 最終也遷至 Latent Space。八個月後,Cognition 的價值增長了 2.5 倍,並正式成為 AI 領域中最大的獨立代理實驗室,這也是我們去年所預測的趨勢。
隨著官方年化經常性收入 (ARR) 的披露(目前預計年底將超過 10 億美元),其成長軌跡清晰可見,與「2025 年發生了什麼」的圖表驚人地相似(這並非巧合)。在企業級 SaaS 業務中,ARR 是使用率的滯後指標,而其客戶名單中不乏企業和新創生態系統中最嚴苛、最挑剔的客戶(包括上週介紹的 Exa 和 Modal)。
我們將在明天的 Cognition 播客中發布更多資訊。以下是 2026 年 5 月 26 日至 27 日的 AI 新聞。我們查閱了 12 個 Reddit 子版塊、544 個 Twitter 帳號,並未發現其他 Discord 資訊。AINews 網站可供您搜尋所有過往的報導。
提醒您,AINews 現已成為 Latent Space 的一個專區。您可以選擇訂閱或取消電子郵件頻率!
推論效率、服務架構與成本曲線
推論優化日益趨向架構層面,而非僅限於核心層:EAGLE 3.1 透過穩定隱藏狀態回饋並減少深度解碼步驟中的注意力漂移,提升了推測解碼的穩健性,特別強調長上下文的接受長度與實際服務的可靠性;該團隊也強調了與 vLLM 和 TorchSpec 的合作。
在核心/系統層面,Perplexity 開源了一個重新建構的 Unigram 分詞器,將 CPU 使用率降低 5-6 倍,並在 514 個 token 時達到 63 微秒,且零堆積記憶體分配。同時,據報導 Qwen3.5 在 TokenSpeed 上透過阿里巴巴、LightSeek、NVIDIA、Mooncake 和 FlashAttention-4 貢獻者的聯合優化,針對代理式工作負載可達到每秒 580 個 token。
支援函式庫也獲得改進:MaxSim v2 新增了反向傳播功能,並報告在 H200 上比原始 PyTorch 快 10.33 倍,在 A100 上快 11.94 倍。
API 價格調降歸因於 KV 快取和注意力機制的結構性變革:多篇貼文都指向同一主題:中國實驗室近期 API 價格調降似乎是可持續的,因為這反映了每個 token 更低的服務成本,而非暫時性補貼。@kimmonismus 總結了 DeepSeek V4-Pro 如何利用混合注意力(包含壓縮稀疏注意力與高度壓縮注意力)將 100 萬 token 的 KV 快取大小降至 V3.2 的約 10%,並將單 token 推論的浮點運算次數降至 27%,同時仍能從總計 1.6 兆參數中路由 490 億個活躍參數。
小米的 MiMo 也類似地透過稀疏視窗注意力 (SWA) 和分層快取管理來減少快取流量。這也得到了 @_LuoFuli 的直接證實,他表示 MiMo 最顯著的輸入快取命中成本降低,來自於 5 倍的快取 token 容量、約 80% 的快取成本降低,以及架構上 1:7 的全注意力與稀疏視窗注意力稀疏比。
更廣泛的啟示是:長上下文推論的經濟效益現在正由注意力設計、快取層級和路由所推動,而不僅僅是更便宜的硬體。
代理、框架、記憶體與持續學習
技術堆疊正從「模型品質」轉向「模型-框架-記憶體適配」:大量推文聚焦於實用的代理工程。LangChain 推出了 Deep Agents v0.6,其中包含 Delta 通道,將 200 輪編碼會話的檢查點儲存從 5.3 GB 減少到 129 MB,並在 Fleet 中推出了電腦使用功能,以及用於版本化代理上下文/技能的 Context Hub。
LangSmith Engine 被定位為自動化「評估 → 診斷 → 修復」循環的工具,多位實踐者強調其將追蹤回饋轉化為可重複使用的線上/離線評估器的價值。同時,@Vtrivedy10 提出了當天最清晰的論點:任務-框架適配與模型品質同樣重要,而客製化垂直系統透過將工具、提示詞和上下文範圍縮小到特定任務,表現優於通用框架。
持續學習正重新成為一個產品類別,而不僅僅是研究主題:此處最大的公告是 Trajectory 的推出:這是一個利用產品使用訊號和代理追蹤來持續後訓練大型代理模型的平台,獲得 1500 萬美元的資金,設計合作夥伴包括 Clay、Harvey、Decagon、Mercor 和 Rogo。
Baseten 表示,它支援這些部署,提供 FP8/NVFP4 量化和自動擴展的 H100 基礎設施,其中包括一個在夜間部署 3970 億參數模型的案例。同樣的趨勢也出現在開源工具中:一個基於 LangChain/LangGraph 建構的開源記憶體中心代理,因其明確的檢索/儲存/推理/學習分離而受到多位開發者的讚揚,而 RLM 的極簡訓練框架顯示,小型團隊現在可以在一天內使用 8 個 A100 GPU 對長上下文代理進行強化學習微調。貫穿其中的主線是,「部署後學習」正從願景轉變為基礎設施。
基準測試、擴展定律與訓練方法
新的基準測試越來越關注長週期、混亂且真實世界的工作流程:DeepSWE 被強調為一個軟體工程師/代理基準測試,包含 5 種語言、91 個儲存庫中的 113 項任務,使用極簡的純 bash 框架和更短的提示詞,但仍比 SWE-Bench Pro 需要多 5.5 倍的程式碼,平均觸及 7 個檔案。
在企業營運方面,Artificial Analysis 和 IBM 推出了 ITBench-AA,這是一個針對 Kubernetes 事件響應的站點可靠性工程師 (SRE) 基準測試,所有頂尖模型得分均低於 50%;Claude Opus 4.7 以 47% 領先,GPT-5.5 以 46% 緊隨其後,而 GLM-5.1 Reasoning 以 40% 領先開源權重模型。
另一個有用的可靠性角度來自 AgingBench,它將部署代理的退化視為由壓縮、干擾和記憶體更新引起的生命週期問題。
訓練效率研究在理論和系統兩方面都保持活躍:Sakana AI 的 DiffusionBlocks 是技術上最有趣的發布之一:它將前向傳播重新詮釋為類似擴散的去噪步驟,因此深度網路可以逐塊訓練,大幅減少記憶體,同時在 ViTs、DiTs、遮罩擴散、自迴歸 Transformer 和遞歸深度 Transformer 中匹配端到端性能。
在強化學習系統方面,Snowflake 推出了 ZoRRo,聲稱透過消除冗餘的 rollout 計算,可將長上下文強化學習速度提高 3.5 倍,上下文視窗長度增加 3.2 倍,同時還推出了專用的 Arctic-Text2SQL-R2 企業 SQL 模型。
在理論方面,Tiberiu Musat 的預印本認為,對於固定精度網路,最小神經權重範數與最小程式長度在對數因子內匹配,而統一神經擴展定律 (Unified Neural Scaling Law) 提出了一種多變量函數形式,旨在比先前的擬合更準確地外推神經擴展行為。
模型與模態發布:生物學、視覺、光學字元辨識與嵌入式 AI
蛋白質建模領域表現突出:ESMFold2 被宣布為一個用於蛋白質結構預測和設計的開放科學引擎,在蛋白質交互作用和抗體方面報告了強勁的結果,並附帶一個包含 68 億個蛋白質和 11 億個預測結構的圖譜。此次發布強調了實際的設計成果,針對五個治療靶點的微型蛋白質結合劑和單鏈抗體,以及關於湧現蛋白質表示的機制可解釋性發現。
此次發布得到了 @proteinrosh 的響應,並由 @cgeorgiaw 進行了背景說明,他指出該圖譜在規模上超越了 AlphaFold DB。
一系列規模較小但實用的多模態/開源發布也相繼推出:Google DeepMind 分享了 Gemini Embedding 2 的白皮書,該模型被描述為一個原生多模態嵌入模型,支援文字、圖像、音訊和視訊的統一表示。NVIDIA 的 LocateAnything 結合了 Qwen2.5-3B + Moon-ViT,實現高速基礎定位,聲稱在密集物件偵測方面速度提升 10 倍。
Hugging Face 整合了 Roboflow 的 RF-DETR,將其定位為優於 YOLO 風格系統的即時偵測/分割工具。對於文件處理流程,Surya OCR 2 作為一個 6.5 億參數模型發布,在 OLMOCR 基準測試中達到 83.3%,在內部 91 種語言基準測試中達到 87%,並在 RTX 5090 上達到每秒 5 頁的速度;LiteParse v2 用 Rust 重寫了解析器,可實現高達 100 倍的速度提升,並透過 WASM 部署到邊緣裝置/瀏覽器。
裝置端 AI 也獲得關注,Google 推出了新的 Coral 開發板,用於本地語音、視覺和控制演示。
開發者平台、企業控制與編碼代理產品化
編碼代理正整合為具備企業級控制的完整產品堆疊:OpenAI 持續收緊 Codex 的產品介面:GPT-5.2 和 GPT-5.3-Codex 將在 Codex 中退役,轉而使用 GPT-5.5,而企業功能現在包括透過僅限出站 HTTPS 的私有 MCP 連線、工作負載身份聯盟,以及擴展的管理員 API 控制,用於支出警報、允許列表、保留策略和託管工具管理。
OpenAI 還發布了一個關於使用 Codex 實現自我改進稅務代理的具體案例研究,其核心是將審閱者的修正追溯到評估和修復中。
編碼代理的競爭現在明顯聚焦於可靠性、工作流程廣度與企業採用:Claude Code 分享了可靠性/性能更新和更容易捕捉錯誤報告的功能,而 GitHub 則透過 Copilot 開發者日和 MCP 定位,持續推動「代理化 IDE」的方向。最大的商業數據點是 Cognition:募資超過 10 億美元,估值達 260 億美元,今年迄今企業使用量增長超過 10 倍,年化營收達 4.92 億美元,並伴隨著不斷增長的客戶名單和來自 Exa 等用戶的強力推薦。
同時,較小的基礎設施/產品變動表明生態系統正在擴展:適用於 Windows 的 Cua Driver 為 Windows 代理帶來了後台電腦使用功能;Cloudflare 的代理平台因其「碎片化運算」經濟效益而屢獲好評;而 Grok Build 的工作樹支援則針對儲存庫規模的多代理程式碼群。
熱門推文(依互動數)
Cognition 的規模擴張:Cognition 宣布募資超過 10 億美元,估值達 260 億美元,年化營收 4.92 億美元,這是編碼代理正轉變為大型企業業務的最明確訊號之一。
Claude Code 可靠性推進:Anthropic 的 ClaudeDevs 發布了關於回應速度、可靠性與更好回饋收集的高互動更新,證明產品品質和信任現在是核心戰場。
Sakana AI 的 DiffusionBlocks:@hardmaru 引起了對逐塊訓練的廣泛關注,該方法可以在大幅降低記憶體需求的同時,匹配端到端性能。
ESMFold2 發布:@alexrives 宣布了當天最具實質性的科學發布之一:圖譜規模的開放蛋白質建模,具有治療設計意義。
OpenAI 企業控制 + MCP:@OpenAIDevs 關於私有 MCP 和相關管理/安全更新的內容,反映了頂尖 API 在爭奪大型組織採用方面的競爭焦點。
PrismML 剛發布 Binary and Ternary Bonsai Image 4B:1 位元/三元文字轉圖像擴散 Transformer,甚至可以在瀏覽器上透過 WebGPU 100% 本地運行。(活動:759):PrismML 發布了 Binary and Ternary Bonsai Image 4B,被描述為 1 位元/三元文字轉圖像擴散 Transformer 變體,具有約 3GB 的檢查點、Apache-2.0 授權和 WebGPU 瀏覽器演示(HF 集合、演示)。
該貼文將其與約 16GB 的 FLUX.2 Klein 4B 進行比較;一條熱門技術評論聲稱 Bonsai Image 主要是一個 FLUX.2 Klein 4B 的量化/後訓練衍生品,除了白皮書之外,歸屬說明不足。主要的爭議是歸屬/品牌:一位評論者認為 PrismML 正在將量化/微調的基礎模型重新品牌為「Bonsai」,同時最小化對原始實驗室的歸屬,將其比作將 Qwen 的量化版本作為新模型發布。
另一位評論者詢問它是否可以在具有 16GB RAM 的 CPU 上運行,但提供的評論中沒有技術答案。一位評論者聲稱 PrismML 的「Bonsai-Image」並非新訓練的基礎模型,而是 FLUX.2 Klein 4B 的二進制/三元量化版本,並經過額外的後訓練以恢復品質。
他們認為該專案的 HF 演示/模型頁面和 GitHub 忽略了對原始 FLUX 模型/團隊的明確歸屬,據報導原始模型僅在白皮書中提及。一條技術可用性說明指出,儘管聲稱是 1 位元/三元壓縮,但瀏覽器/WebGPU 模型需要大約 2 GB 的下載量,這對於完全本地推論來說是相關的。
另一位用戶詢問它是否可以在具有 16GB RAM 的 CPU 上運行,但沒有提供技術答案。

