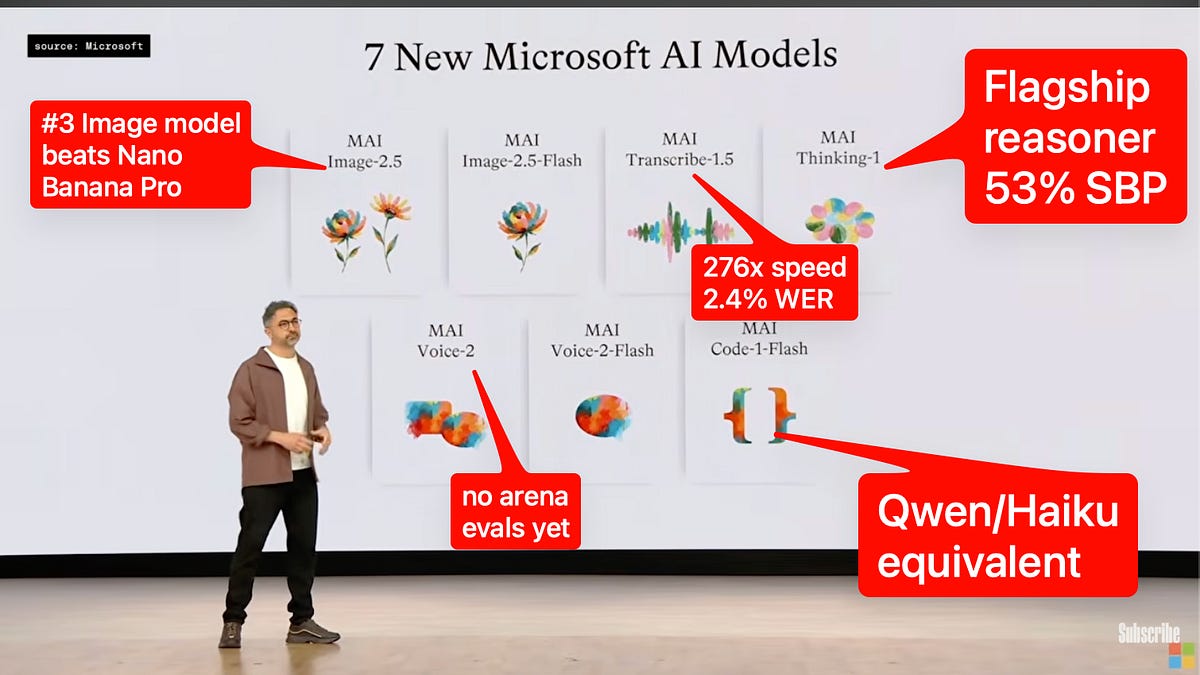
今天是一個重要的日子,除了我們深入了解 GitHub 與 AI 代理程式的現況,並與 No Priors 和 Satya Nadella 錄製了一集特別節目外,Satya 和 Mustafa 在微軟 Build 大會上宣布了七款全新的 MAI 模型。
這是一個令人印象深刻的陣容,特別是考量到微軟與 Inflection 達成協議成立 MAI 僅在兩年前,且這些模型都是從零開始預訓練的。目前的 MAI 絕非一個完全成熟的前沿實驗室,但它是一個優秀的二線新興實驗室,顯然有動機支援領域特定的微調(相較於那些幾乎都已停止微調的前沿實驗室)。
本次大會的焦點是長達百餘頁的 MAI 技術報告,研究社群對其讚譽有加:elie@eliebakouch 表示,微軟的 MAI 技術報告是個寶庫,對於如此規模的模型而言,這是最具透明度的報告之一。該模型未使用任何合成資料或從先前模型進行蒸餾。
這意味著推理、代理行為和工具使用都是在後訓練階段完全學習而來,沒有任何冷啟動問題。Mustafa Suleyman @mustafasuleyman 興奮地宣布今天推出七款世界級的 MAI 模型。它們代表了我們所認為的 AI 新時代,旨在讓使用者掌握控制權並站在前沿。
首先是我們的文字基礎模型 MAI-Thinking-1,在推理和軟體工程(SWE)任務上表現異常強大。您可以透過 Verge 的精彩回顧和以下的推文摘要,了解所有其他的發布內容。AI 新聞(2026 年 6 月 1 日至 6 月 2 日):我們檢查了 12 個 Reddit 子版塊、544 個 Twitter 帳號,沒有其他 Discord 資訊。
AINews 網站可供您搜尋所有過往議題。提醒您,AINews 現已成為 Latent Space 的一個專區。您可以選擇接收電子郵件的頻率!頭條新聞:微軟 Build 大會回顧與新 MAI 模型技術細節。微軟利用 Build 大會將自己定位為 AI 平台公司和前沿模型實驗室,將廣泛的產品發布與其新 MAI 模型家族異常詳細的披露結合在一起。
根據 @MicrosoftAI 和 @mustafasuleyman 的說法,微軟 AI 宣布推出七款涵蓋推理、程式碼、圖像、語音轉錄和語音功能的全新 MAI 模型,由 MAI-Thinking-1、MAI-Code-1-Flash、MAI-Image-2.5、MAI-Transcribe-1.5 和 MAI-Voice-2 領銜。
旗艦級推理模型 MAI-Thinking-1 被譽為微軟首款推理模型,根據 @mustafasuleyman、@baseten、@tuhinone 和 @HannaHajishirzi 的貼文,它採用純淨資料血統,且未從第三方模型進行蒸餾。
微軟發布了 MAI-Thinking-1 長達 109 頁的技術報告,其高度透明性獲得了技術導向讀者的強烈好評,其中包括 @eliebakouch、@ethanCaballero、@nrehiew_、@yacinelearning 和 @stochasticchasm。
微軟也強調本地端 AI 和以代理程式為核心的 Windows:Build 大會的訊息突顯了代理程式的安全執行層、全新的 Surface RTX Spark Dev Box、Windows AI 對更廣泛 Windows GPU 安裝基礎的存取,以及 Project Solara/Scout 等概念硬體,由 @yusuf_i_mehdi、@TheTuringPost、@kimmonismus 和 @kimmonismus 進行了總結。
Build 大會還包括了 GitHub Copilot 應用程式的重大推動,作為「代理程式原生軟體開發的桌面主頁」,具備畫布、跨裝置連續性以及更緊密的 GitHub 代理程式工作流程,來自 @pierceboggan、@lukehoban 以及 @techgirl1908 的回應。
微軟推出了 Web IQ,這是一個針對 AI 代理程式的新型基礎/搜尋 API 堆疊,聲稱這些 API 已為「當今業界幾乎所有 AI 代理程式和聊天機器人提供支援,包括 Copilot 和 ChatGPT」,透過 @JordiRib1。Satya Nadella 將 Build 大會視為一個生態系統的時刻,而非單一產品的發布,而 Mustafa Suleyman 則將其視為微軟內部「爬坡機器」的成果,見於 @satyanadella、@mustafasuleyman 和 @nrehiew_ 的回應。
微軟在 @mustafasuleyman 的貼文中將 MAI-Thinking-1 描述為一個擁有 350 億個活躍參數的 MoE 模型,具備 256K 的上下文視窗。@scaling01 的另一份摘要指出,該模型是一個 1T@35B 參數的模型,經過 30T 個 token 的預訓練,並使用 8192 個 GB200 GPU 進行訓練;這似乎是對技術報告的解讀,而非微軟的行銷文案。
@kimmonismus 也將其總結為一個擁有 450 億個活躍參數的中型 MoE 模型,但這與 Mustafa 自己的 350 億個活躍參數數據相衝突;推文集中更具權威性的數字是官方的 350 億個活躍參數。微軟聲稱在 AIME 2025 上達到 97%,在 SWE-Bench Pro 上達到 53%,並且 Surge 上的盲測人類評分者普遍認為它優於 Sonnet 4.6,來自 @mustafasuleyman 和 @asadovsky。
微軟表示,該模型已在 MAIA 200 上進行優化,在端到端運行 MAI 模型時,每美元效能提升 30%,每瓦效能提升 1.4 倍,相較於 GB200,根據 @mustafasuleyman。微軟及其合作夥伴一再強調沒有第三方蒸餾、「純淨資料血統」,以及透過 Baseten 實現「100% 無人干預」的後訓練資料的企業控制微調,見於 @baseten、@tuhinone 和 @MicrosoftAI。
微軟推出了 MAI-Code-1-Flash,這是一款適用於 VS Code 和 GitHub Copilot CLI 的快速程式碼模型,最初由 @pierceboggan 宣布,隨後由 @mariorod1 強調。根據 @mustafasuleyman 的官方微軟訊息,Code-1-Flash 儘管只有 50 億個參數,但在 SWE-Bench Pro 上仍達到 51%,使其定位接近 Haiku 級別的大小/成本。
@scaling01 的一份競爭性摘要將其描述為一個 1370 億個參數的 MoE 模型,256K 上下文,經過 10T+ 個 token 的訓練,並且「比 Claude 4.5 Haiku 更強大、更高效」。這可能表示 50 億個活躍參數而非總參數;這些推文並未完全調和這一區別,但共同暗示在一個更大的 MoE 中,其活躍佔用空間較小。
根據 @scaling01 和 @mariorod1 的說法,發布時的可用性主要集中在 GitHub Copilot / VS Code。微軟推出了 MAI-Image-2.5 及其 Flash 版本,聲稱兩者都在排行榜上達到第二名,@mustafasuleyman 表示它們在圖像編輯方面超越了 Nano Banana 2。
獨立排行榜帳戶也支持其高排名:@arena 報告在 Image Edit Arena 中排名第二,得分 1401,比 Nano Banana 2、Grok Imagine 和 ChatGPT Image Latest HF 高出 10 分。
@arena 進一步表示 MAI-Image-2.5「推進了帕累托前沿」,意味著在其價格區間內沒有模型能在此基準測試中獲得更高分數。分銷合作夥伴迅速跟進,包括 @OpenRouter 和 @fal。@ArtificialAnlys 報告稱 MAI-Transcribe-1.5 在語音轉文字(STT)前沿展現了異常強大的速度/準確性:約 276 倍即時速度,2.4% AA-WER,在其排行榜上總體排名第三。
該模型支援 43 種語言,包括英語、法語、阿拉伯語、日語和中文,並支援針對姓名和醫學術語等稀有詞彙的關鍵字偏向,根據 @ArtificialAnlys。據報導,透過 Microsoft Foundry,每 1,000 分鐘音訊的定價為 6 美元,見於 @ArtificialAnlys。
OpenRouter 也將該模型列為其當天推出的三款 MAI 模型之一,見於 @OpenRouter。MAI-Voice-2 出現在微軟的「七款模型」傘狀計畫中,以及 OpenRouter 的可用性貼文中,見於 @OpenRouter。除了發布/可用性之外,推文集中關於 Voice-2 本身的技術細節很少。
主要的技術反應是微軟發布了一份異常詳細的前沿模型報告:@eliebakouch 稱其為「如此規模模型中最具透明度的報告之一」,@nrehiew_ 說它「確實可以作為當今 LLM 訓練的更新教科書」,而 @stochasticchasm 則稱其為「寶庫」。
多位讀者強調,該報告披露了管線細節、擴展階梯方法、資料策劃、基礎設施指標和 MFU 數字;這種詳細程度正是 @ethanCaballero、@eliebakouch 和 @nrehiew_ 讚揚的原因。評論中重複出現的一項主要技術主張是,MAI-Thinking-1 在後訓練以及整個披露的管線中,未使用任何合成資料和蒸餾,來自 @eliebakouch、@stochasticchasm 和 @HannaHajishirzi。
@eliebakouch 表示,報告明確指出資料來源於 Common Crawl 和私人來源,針對不同領域設有目標子管線,進行了大量的提取/去重工作,並有意選擇不使用合成資料。報告中用於擴展決策的內部私人 NLL 集,@eliebakouch 總結如下:50% 程式碼、17.5% STEM、17.5% 數學、10% 一般知識、5% 多語言。
@eliebakouch 表示,擴展階梯中的架構提升是基於效率增益(EG)指標:基準模型需要多少額外運算才能匹配候選模型的損失。同一討論串指出,約每參數 100/200 個 token 的消融實驗,被描述為接近該設置的「Chinchilla 最優」,同時也指出由於 MoE 結構,這與密集模型啟發式方法不同,見於 @eliebakouch。
最受討論的技術選擇是,微軟似乎從一個沒有先前推理經驗的檢查點開始強化學習(RL),這讓幾位讀者覺得值得注意。@stochasticchasm 稱這是一個「非常有趣的決定」,而 @stochasticchasm 對圖表顯示從 AIME25 低於 20% 跳升到超過 95% 的情況做出了反應。
@HannaHajishirzi 將「從零開始攀升」的方法描述為簡單的配方、嚴謹的科學、自我蒸餾、耐心和卓越的基礎設施。@soldni 將此過程描述為「不經蒸餾的攀升,就像大公司一樣」。一些獨立讀者從報告中推斷,即使微軟在此刻意避免使用合成資料,合成資料在更廣泛的領域中對於代理行為效能仍然非常有價值;見 @stochasticchasm。
一個引起 DSPy/後期互動社群高度關注的細節是:據報導,微軟在預訓練資料策劃和品質評分中使用了 GEPA / DSPy 優化的 LLM 評審。這由 @bj2rn、@LakshyAAAgrawal 和 @lateinteraction 強調。
據報導,微軟披露了每次迭代的精確 MFU,多位讀者表示這種規模的數據很少公開,根據 @eliebakouch。@scaling01 總結該運行使用了 8192 個 GB200 GPU。@eliebakouch 指出,據報導每瓦吞吐量類型數據高出約 40%,稱其「相當令人印象深刻,並看好微軟晶片」,儘管這可能指的是機架級預算或服務配置,並未在推文中完全闡明。
微軟的官方框架將模型設計與 MAIA 200 客製化晶片聯繫起來,並強調相較於 NVIDIA GB200,在 @mustafasuleyman 的貼文中,其每美元效能和每瓦效能更佳。Build 大會更廣泛的 Windows/本地端 AI 敘事也圍繞著硬體細節,例如:在 DGX Station 上本地運行 1 兆個參數、128GB 統一記憶體、110 TOPS AI 效能、20 個 CPU 核心、70 多個 PowerToys 工具,來自 @TheTuringPost。
回應也指向大型模型的本地運行,例如 @kimmonismus 在 RTX Spark 上本地運行 1200 億個參數的模型。GitHub 推出了 GitHub Copilot 應用程式,@pierceboggan 將其定位為代理程式原生軟體開發的桌面介面。
主要主題包括:根據 @Techmeme,用於使用者和代理程式之間雙向工作的畫布;根據 @lukehoba,跨 CLI、行動裝置、網頁、本地端和雲端的連續性;根據 @techgirl1908 和 @OrenMe,GitHub 作為代理程式工作流程中心的日益增長的角色。
Copilot CLI 還獲得了一個實驗性的終端使用者介面,具備分頁、內建回饋/橡皮鴨除錯、提示詞排程和語音輸入功能,根據 @GHchangelog。微軟的 Windows 部門將 Build 大會圍繞著「更快的開發者執行、代理程式的安全執行層,以及在裝置上本地運行的無限制智慧」來構建,根據 @yusuf_i_mehdi。
多篇貼文強調,微軟希望 Windows 成為代理程式的信任執行平台,而不僅僅是 Azure。@TheTuringPost 將 Project Solara 描述為代理程式優先裝置的平台,其概念包括:一個桌面 AI 夥伴、一個帶有攝影機、麥克風、感測器和安全認證的可穿戴徽章。
@kimmonismus 將這些視為用於控制代理程式的手持/桌面裝置,並將其與人們對獨立 OpenAI 硬體的期望進行了比較。@kimmonismus 另外強調 Microsoft Scout 是一個「始終在線的個人工作代理程式」。@JordiRib1 宣布 Microsoft Web IQ 作為一套針對網頁的 AI 原生基礎 API。


