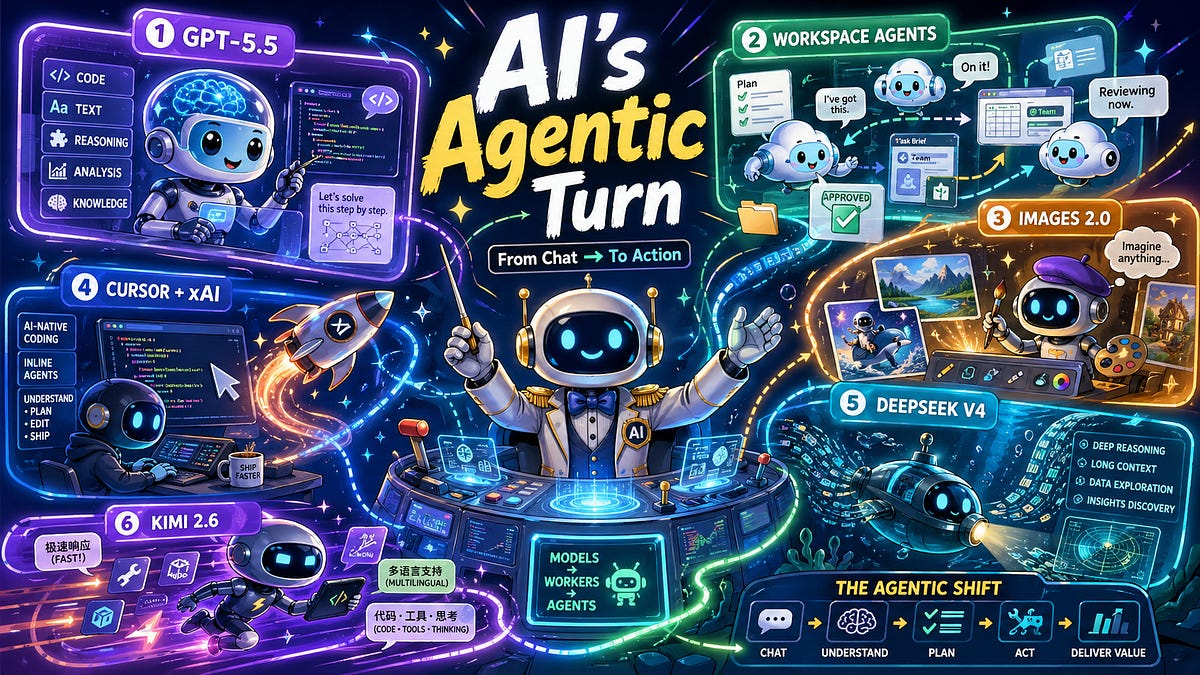
本週的 AI 發展,感覺不再只是模型發布的另一個循環,更像是軟體底層結構的轉變。重要的故事不僅僅是新模型變得更強大,這在過去幾年一直是預設的發展軌跡。更有趣的進展是,模型正日益與實際工作發生的系統糾纏在一起:程式碼編輯器、企業工作流程、雲端環境、協作工具以及代理介面。
OpenAI 的 GPT-5.5 發布顯然是重心所在。它代表了前沿模型在推理、程式碼編寫、工具使用、長上下文處理和專業任務方面能力的持續擴展。但基準測試的敘事幾乎已退居次要地位。前沿模型不再僅僅是一個模型,它是一個執行環境,是程式碼環境、研究工作流程、企業助理和自主系統中的智慧層。模型正變得越來越不像一個更聰明的聊天機器人,而更像一個能夠協調行動的運算引擎。
OpenAI 的其他發布使這一論點更加清晰。Workspace Agents 將 ChatGPT 從個人生產力工具推向共享的組織底層:由 Codex 驅動的代理程式可以存在於公司內部、在雲端運行、跨 ChatGPT 和 Slack 等工具操作、遵循權限、記住上下文並執行長時間運行的工作流程。
這不僅僅是「企業包裝的客製化 GPTs」,它是 AI 作為可重複使用的制度化流程的開端。同時,ChatGPT Images 2.0 將 AI 工作的表面範圍從語言和程式碼擴展到視覺生成,具有更強的文字渲染、多語言支援、視覺推理和「帶思考的圖像」功能,模型可以在生成前花更多時間規劃和完善。
總而言之,這些發布顯示 OpenAI 試圖讓 ChatGPT 更不像一個應用程式,而更像一個多模態工作環境:一個文字、程式碼、圖像、工具、記憶、審批和代理程式開始匯聚的地方。
xAI 與 Cursor 的交易完美契合了這一更大的模式。Cursor 已成為 AI 原生軟體開發從新奇事物轉變為基礎設施的最清晰範例之一。程式碼是代理程式的理想環境,因為它是明確的、可測試的、可組合的且具經濟價值的。程式碼代理程式可以提出、編輯、運行、偵錯和驗證。它在一個可以衡量進度的循環中運作。誰擁有這個循環,誰就擁有未來 AI 最重要的表面之一。
同時,DeepSeek V4 和 Kimi 2.6 顯示了開源和半開源模型生態系從底層壓縮前沿技術的速度有多快。新的競爭不再僅僅是關於聊天品質或排行榜競爭,它關乎長上下文、程式碼性能、工具使用、延遲、成本和代理可靠性。換句話說,戰場正從對話式智慧轉向執行式智慧。
這才是本週的真正主題:AI 正在變得可操作。模型本身不再是產品,產品是模型加上框架、工具、記憶、權限、環境和回饋循環。我們正從回答問題的模型轉向執行工作的系統。
AI 實驗室:Google DeepMind, Google Research
摘要:本論文介紹了 Decoupled DiLoCo,這是 DiLoCo 框架的演進版本,旨在提高大型語言模型預訓練對硬體故障和網路問題的韌性。透過將運算分散到獨立、非同步通訊的「學習器」中,該框架顯著提高了訓練效率(goodput),同時即使在透過混沌工程模擬的高度故障環境中,也能保持具競爭力的模型性能。
AI 實驗室:Inclusion AI, Ant Group
摘要:本論文介紹了 LLaDA2.0-Uni,這是一個統一的離散擴散大型語言模型,可在單一框架內無縫整合多模態理解和生成。透過將視覺輸入離散化為語義標記並採用區塊級遮罩擴散,該模型可與專門的視覺語言模型相媲美,同時支援交錯生成和推理。
AI 實驗室:Carnegie Mellon University, Amazon AGI
摘要:作者提出了 SkillLearnBench,這是第一個旨在評估代理程式技能生成持續學習方法的基準,涵蓋 20 個真實世界任務。他們的評估顯示,儘管持續學習方法比無技能基準提高了性能,但它們仍未達到人類編寫的技能水平,並且難以應對開放式任務。
AI 實驗室:Meta Superintelligence Labs, University of Washington, New York University, Google DeepMind, Carnegie Mellon University, Princeton University
摘要:本論文提出了一種用於長週期程式碼代理程式的測試時擴展框架,透過將嘈雜的運行軌跡轉換為緊湊、結構化的摘要。利用遞歸錦標賽投票(RTV)進行並行擴展和並行蒸餾精煉(PDR)進行序列擴展,這種以表示為中心的方法顯著提升了前沿模型在具挑戰性的代理基準上的性能。
AI 實驗室:Stanford University
SWE-chat 引入了第一個大規模的真實世界程式碼代理程式會話資料集,捕捉了來自開源開發者的 6,000 多次互動、63,000 個使用者提示詞和 355,000 次工具呼叫。分析這些資料顯示,儘管「氛圍程式碼編寫」(vibe coding)越來越受歡迎,但它仍然成本高昂並引入更多安全漏洞,經常促使使用者中斷或糾正代理程式。
AI 實驗室:Microsoft
摘要:AutoAdapt 是一個端到端的自動化框架,旨在在嚴格的資源限制下優化大型語言模型複雜的領域適應過程。透過採用多代理程式辯論系統來導航最佳實踐,以及基於 LLM 的替代模型進行高效超參數調整,該框架比最先進的自動化基準提高了 25% 的相對準確度。
DeepSeek 的新版本已發布,具有 1M 上下文長度和令人印象深刻的代理能力。
Kimi 2.6 推出,具備卓越的代理程式碼編寫能力。
OpenAI 在 ChatGPT 中發布了大幅增強的圖像生成功能。
OpenAI 推出了 Workspace Agents,這是一種用於創建可在 ChatGPT 內部處理複雜工作流程的代理程式的新體驗。
Hugging Face 開源了 ML Intern,這是一個研究和編寫機器學習相關程式碼的代理程式。
- SpaceX 搶在 Cursor 接近完成的 20 億美元融資(估值 500 億美元)之前,提出以 600 億美元的 IPO 後收購選項,並在此期間支付 100 億美元作為「合作」費用,因為與 xAI 合併後的 SpaceX 正努力將自己定位為一家 AI 公司。
- Infosys 和 OpenAI 宣布建立戰略合作夥伴關係,將 Infosys Topaz Fabric 與 OpenAI 的 Codex 和前沿模型結合,以大規模推動企業軟體工程、舊系統現代化和 DevOps 自動化。
- 由俄亥俄州立大學教授 Yu Su 與共同創辦人 Xiang Deng 和 Yu Gu 創立的 AI 代理實驗室 NeoCognition,以 4,000 萬美元的種子輪融資從隱身狀態中浮現,由 Cambium Capital 和 Walden Catalyst Ventures 共同領投,旨在建立能夠開發特定工作環境世界模型的自學習代理程式。
- Anthropic 從 Amazon 獲得額外 50 億美元投資(使 Amazon 總投資達到 130 億美元),以換取一項價值超過 1,000 億美元的十年期 AWS 承諾,涵蓋高達 5GW 的 Trainium2 到 Trainium4 運算能力,用於訓練和服務 Claude。
- Microsoft 承諾到 2029 年底向澳洲投資 250 億澳元(約 180 億美元),將 Azure AI 超級運算能力擴展 140% 以上,深化與 ASD 的網路防禦工作,並承諾到 2028 年為三百萬澳洲人提供 AI 技能培訓。
- Jeff Bezos 和 Vik Bajaj 的實體 AI 實驗室 Project Prometheus 以約 380 億美元的估值完成 100 億美元融資,參與者包括 JPMorgan 和 BlackRock,同時獨立探索高達 1,000 億美元的控股公司,以收購其營運數據將回饋到實驗室模型的工業企業。
- Bret Taylor 和 Clay Bavor 的 Sierra 收購了總部位於巴黎、由 YC 投資的 Fragment,這是其 2026 年繼 Opera Tech 和 Receptive AI 之後的第三次收購,將共同創辦人 Olivier Moindrot 和 Guillaume Genthial 納入團隊,以鞏固 Sierra 在法國的代理程式開發工作。
- ComfyUI 在由 Craft 領投的融資中籌集了 3,000 萬美元,估值 5 億美元(Pace Capital、Chemistry 和 TruArrow 參與),利用其 400 萬使用者和 60,000 多個節點的開源社群,使其基於節點的工作流程成為生產級生成媒體的事實控制層。
- Google 承諾向 Anthropic 投資高達 400 億美元,目前以 3,500 億美元估值投資 100 億美元,另有 300 億美元取決於績效里程碑,同時擴大 Google Cloud 協議,在未來五年內提供 5GW 的基於 TPU 的運算能力。
- Meta 簽署了一項為期多年、價值數十億美元的協議,將數千萬個 AWS Graviton5 核心納入其運算組合,用於代理式 AI 推理工作負載,成為 AWS 最大的 Graviton 客戶之一,並驗證了代理式 AI 正在將需求轉向 CPU 的論點。

