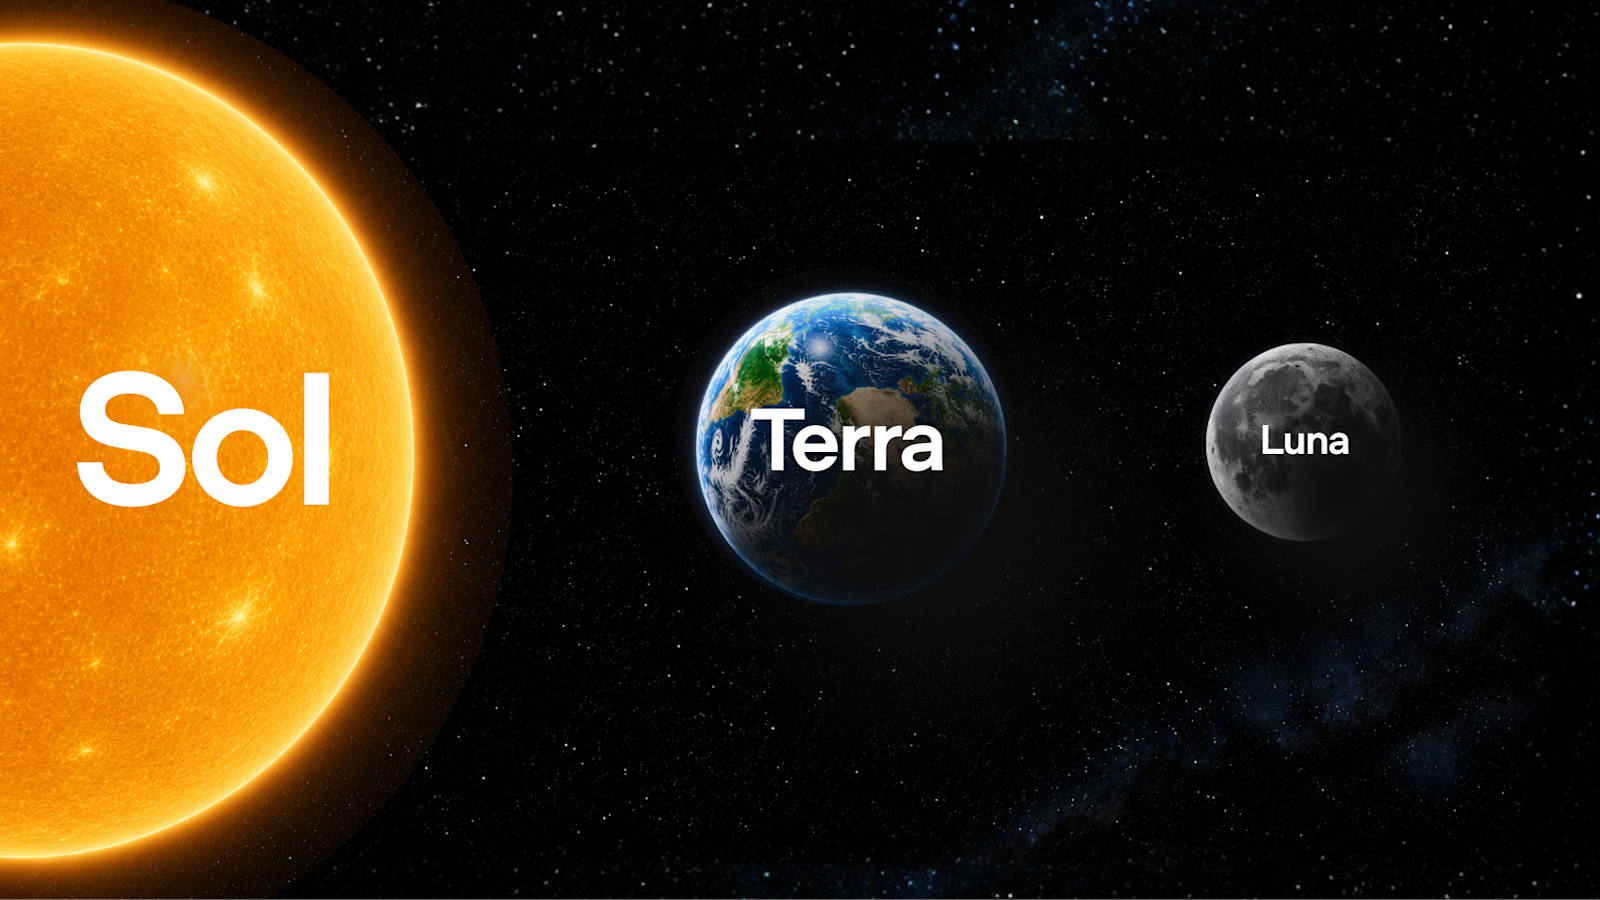
我們正開始對 GPT-5.6 系列進行有限預覽:Sol 是我們的旗艦模型;Terra 是一款適用於日常工作的平衡模型;而 Luna 則是一款快速且經濟實惠的模型。Terra 的效能與 GPT-5.5 相當,但價格便宜兩倍,Luna 則以最低成本提供強大的功能。
GPT-5.6 Sol 搭載了我們迄今最完善的安全防護機制。我們加強了對高風險活動、敏感網路安全請求和重複濫用的保護,並花費數週時間尋找弱點、對系統進行壓力測試,並強化其以抵禦真實世界的攻擊。
我們相信廣泛的存取權限,並計劃在未來幾週內全面開放 GPT-5.6 Sol、Terra 和 Luna。作為我們與美國政府持續合作的一部分,我們在今天發布前預先展示了我們的計劃和模型能力。應他們的要求,我們將首先向一小群信任夥伴提供有限預覽,這些夥伴的參與已與政府分享,之後才會更廣泛地發布。
在這次預覽期間,我們將繼續與合作夥伴密切測試和協調,以實現更廣泛的可用性。我們不認為這種政府存取流程應該成為長期的預設模式。它會讓使用者、開發者、企業、網路防禦者和全球合作夥伴無法獲得他們所需的最佳工具。
我們採取這項短期措施,是因為我們相信這是未來幾週內實現更廣泛可用性的最強途徑,同時我們也與政府合作開發網路安全行政命令框架和未來模型發布的可重複流程。
GPT-5.6 Sol 是我們迄今最強大的模型。為了預覽模型效能,我們分享了一系列評估結果,突顯其在編碼、生物學和網路安全方面改進的代理能力,更多安全和準備評估可在我們的系統卡中查閱。當模型全面開放時,我們將分享更全面的評估結果。
透過 GPT-5.6,我們引入了新的「最大推理投入」(max reasoning effort),讓 Sol 有更多時間進行深度推理。此外,我們還引入了新的「超級模式」(ultra mode),透過利用子代理(subagents)來加速複雜工作,超越單一代理的能力。
對於編碼工作流程,GPT-5.6 Sol 在 Terminal-Bench 2.1 上樹立了新的最先進水準,該基準測試需要規劃、迭代和工具協調的命令列工作流程。
GPT-5.6 Sol 在生物學工作流程方面也顯示出廣泛的改進。在 GeneBench v1 上,該基準評估長期基因組學和定量生物學分析,它比 GPT-5.5 取得了更強的結果,同時使用了更少的 token。
GPT-5.6 Sol 是我們迄今為止在網路安全方面能力最強的模型。它提升了包括漏洞研究和利用在內的長期安全任務的效能效率前沿。在 ExploitBench² 上,GPT-5.6 Sol 與 Mythos Preview 具有競爭力,但僅使用了約三分之一的輸出 token。
在 ExploitGym³ 上,一個由加州大學柏克萊分校研究人員與 OpenAI 和其他前沿實驗室合作建立的基準,GPT-5.6 Sol、Terra 和 Luna 模型在我們增加推理能力時,都展現了網路安全能力的顯著提升。
我們以迄今最完善的安全防護措施開發了 GPT-5.6 Sol、Terra 和 Luna,並根據每個模型的能力進行了配置。隨著模型能力的增強,我們設計了安全防護措施,使其能夠越來越好地承受真實世界的惡意攻擊壓力,同時保留對合法工作的存取權限,例如程式碼審查、漏洞研究、修補程式開發、除錯、安全教育和防禦性測試。
我們的目標是讓被禁止的攻擊性活動變得更加困難、不確定和可偵測,而不會不必要地限制這些有益的用途。根據我們對模型和安全防護措施的評估,我們預計對合法的防禦性工作將帶來實質性好處,同時有效限制被禁止的攻擊性使用。
GPT-5.6 Sol 更擅長幫助人們發現和修復漏洞,而不是可靠地執行端到端攻擊。隨著這些能力的持續進步,我們的首要任務是確保它們能夠惠及防禦者,防禦者可以利用這些工具來發現弱點、開發修補程式並更廣泛地強化系統。
根據我們的「準備框架」(Preparedness Framework),GPT-5.6 Sol 並未跨越「網路關鍵門檻」(Cyber Critical threshold)。在涉及 Chromium 和 Firefox 的評估中,它識別出錯誤和利用原語(漏洞利用的基礎構件),但在測試條件下並未自主生成功能性完整鏈利用。儘管如此,基準門檻無法捕捉模型可能被使用或與其他工具結合的每種方式。
這種不確定性,加上模型能力的顯著提升,是我們將模型增強的能力與更強大的安全防護措施和分階段發布相結合的原因。我們在 GPT-5.6 預覽系統卡中分享了更多關於我們安全防護措施的細節。
沒有單一的安全防護措施足以抵禦蓄意或適應性濫用。在 GPT-5.6 預覽版中,我們使用分層的安全防護措施,具體配置因模型而異,並對其進行壓力測試以應對真實世界的攻擊。這些措施包括模型內建的保護、生成過程中的即時檢查、帳戶層級訊號、差異化存取、監控、執行和持續測試。
GPT-5.6 經過訓練,會拒絕被禁止的網路協助,即使使用者試圖偽裝其意圖或越獄模型。這些模型層級的安全防護措施為模型應該和不應該提供幫助的範圍建立了第一道防線。
即時網路和生物學濫用分類器透過在生成時評估輸出,提供了另一層保護。對於高風險情況,如果它們偵測到潛在違規行為,生成可能會暫停,同時更大的推理模型會審查對話及其上下文。如果輸出被評估為不允許,它將在到達使用者之前被阻止。
標記的活動還可以觸發對相關對話和風險訊號的帳戶層級審查,這符合我們關於內容保留和審查的條款和政策。超越單一對話的審查有助於我們的系統區分持續的惡意行為與合法的雙重用途安全工作,因為相似的技術概念可能出現在非常不同的情境中。
總體而言,這些層次使整體方法比任何單一安全防護措施都更為穩健。模型行為降低了有害回應的可能性,即時系統可以在生成過程中進行干預,帳戶層級審查可以識別更廣泛的模式,差異化存取則在不預設廣泛提供最敏感功能的情況下,保留了重要的防禦性工作。
尤其是在預覽期間,使用者可能會遇到阻擋或拒絕某些請求的安全防護措施。其他請求可能需要更長時間,因為生成會暫停以進行額外審查。安全防護措施偶爾可能會干預合法工作,特別是在防禦性和攻擊性活動最初可能看起來相似的雙重用途領域。
這正是預覽版旨在測試的一部分。我們不僅要了解安全防護措施是否能限制濫用,還要了解合法使用者是否仍能可靠高效地完成正常工作。預覽期間的回饋將幫助我們減少不必要的阻擋和延遲,改進安全防護措施對上下文的解釋,並在更廣泛發布之前創造更流暢的體驗。
我們還與企業客戶合作,制定長期方法,包括保護隱私的偵測、客戶操作的安全控制,以及根據客戶、使用者或工作負載的風險調整的存取權限,以在支援企業隱私要求的同時推進安全性。
當攻擊者調整策略時,安全防護措施也需要保持有效。僅對一組已知攻擊有效的保護對於前沿模型來說是不夠穩健的。這就是為什麼我們比以往任何時候都投入更多的智慧和運算資源來確保安全,使用我們自己的模型來發現弱點並更快地改進安全防護措施。
我們投入了超過 70 萬 A100 等效 GPU 小時用於自動化紅隊演練,旨在尋找通用越獄:這些攻擊可以在許多提示詞或情境中起作用,而不僅僅是狹窄的設定。專注於這些更困難、更普遍的攻擊,讓我們能夠測試超出固定已知失敗集的安全防護措施。它還讓我們能夠探索比單獨的人工測試所能涵蓋的更多攻擊模式,更早地識別失敗模式,並縮短從發現弱點到解決弱點的路徑。
除了自動化紅隊演練,我們還與第三方測試人員合作進行了廣泛的人類專家紅隊演練,這將在預覽期間繼續進行。人類紅隊演練透過測試安全防護措施以應對試圖以我們的系統可能無法預料的方式濫用模型的創意專家,來補充自動化工作。
沒有任何評估可以代表所有產品配置、多步驟攻擊或真實世界的工作流程。因此,我們維持一個快速響應流程,以重現、評估、優先處理和修復新發現的越獄,然後將它們添加到我們正在進行的評估中,以便我們將來可以針對類似的失敗進行測試。
在預覽期間,GPT-5.6 模型最初將透過 API 和 Codex 提供給選定的信任夥伴和組織。我們計劃很快將它們更廣泛地提供給使用 ChatGPT、Codex 和 API 的使用者。
在 GPT-5.6 引入的這種新命名系統中,數字表示模型的世代,而 Sol、Terra 和 Luna 則表示可以按各自步調發展的持久能力層級。總體而言,這個系列為人們和開發者在智慧、速度和成本方面提供了更清晰的選擇。
GPT-5.6 按每百萬 token 定價,分為三種模型大小:Sol 的輸入價格為 5 美元/輸出價格為 30 美元;Terra 的輸入價格為 2.50 美元/輸出價格為 15 美元;Luna 的輸入價格為 1 美元/輸出價格為 6 美元。
GPT-5.6 還引入了更可預測的提示詞快取,包括支援明確的快取中斷點和 30 分鐘的最短快取生命週期。對於 GPT-5.6 及更高版本模型,快取寫入按模型未快取輸入費率的 1.25 倍計費,而快取讀取則繼續享受 90% 的快取輸入折扣。
我們還將於 7 月在 Cerebras 上推出 GPT-5.6 Sol,速度高達每秒 750 token,以史無前例的速度為客戶帶來前沿智慧。隨著我們擴大容量,初期存取將僅限於選定的客戶。
我們很高興能繼續從這次預覽期中學習,並很快將 GPT-5.6 Sol、Terra 和 Luna 帶給更多人。


