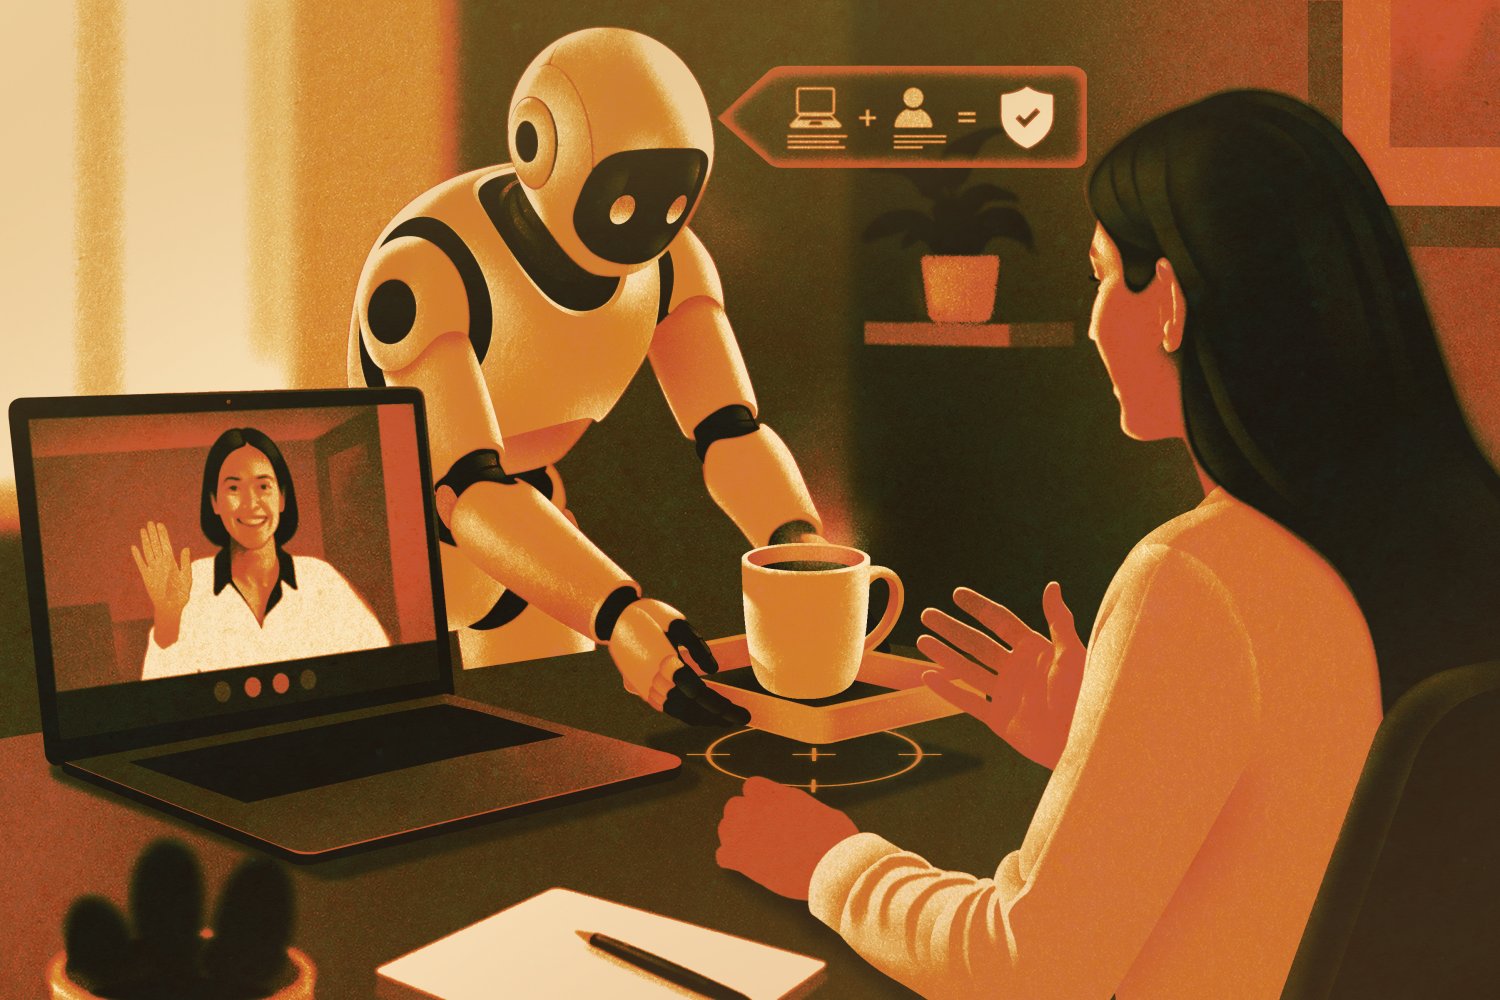
想像在不久的將來,你在倉庫或辦公室工作,被要求教導一位新進的實習生基本工作內容,而這位實習生竟然是個機器人。為了教導它們,你可能會想玩一場「邊做邊說」的遊戲,也就是親自示範幾種不同的做法,同時解釋你的操作。
假設你要求機器人把咖啡放在你的桌上,但不要在你進行 Zoom 會議時打擾你。你當然會希望機器人不要太靠近你和筆記型電腦,以免中斷會議。為了實現這種行為,機器人需要透過明確展示完整任務的數據進行訓練。電腦科學家曾嘗試透過記錄大量實際示範或編寫詳盡指示來向機器人解釋操作任務,但如果兩者皆不具備,機器人很可能會誤解其需要執行的內容。
對人類來說,進行所有這些「邊做邊說」的示範是費力的。因此,麻省理工學院電腦科學與人工智慧實驗室(CSAIL)的研究人員已將教導機器人的過程自動化,同時自動澄清指令,並使用近五分之一的示範數據。他們提出的「遮罩式逆向強化學習」(Masked IRL)方法利用一個大型語言模型(LLM)根據用戶示範收集的數據,闡述模糊的提示詞。
另一個 LLM 則會縮小演算法應納入運動規劃的細節範圍,讓機器人能夠安全地在家中、辦公室和工廠完成任務。
麻省理工學院博士生兼 CSAIL 研究員 Minyoung Hwang 是該專案論文的主要作者,他表示:「當人類與機器人互動,但不想詳述任務的所有細節時,我們的方法就能派上用場。我們透過讓機器人深入了解用戶真正想要什麼,來最大限度地減少人類的努力。」
Hwang 指出,Masked IRL 可以幫助機器人在人類可能不會在提示詞中描述,但卻至關重要的環境元素中安全地操作。例如,機器人從廚房為你拿零食時,可能不知道要避免撞到你的筆記型電腦;同樣地,工廠機器人將物品放入不同箱子時,也必須小心翼翼地避開貨架。
為了在這些情況下學習新任務,Masked IRL 利用機器人的感測器捕捉周圍環境的資訊。這些組件還會記錄每次動覺示範的動作,這是一種訓練方法,人類會實際移動機器人來執行特定動作。這有點像擔任機器人的物理治療師,彎曲關節以特定方向,向機器人展示如何抓取、移動和放置物體。
麻省理工學院的系統隨後會呼叫一個 LLM,將這一系列動作(稱為軌跡)與最短路徑進行比較。該模型還會闡述提示詞中可能不清楚的內容,將「靠近一點」之類的請求轉化為「靠近桌子表面」。透過軌跡比較和澄清後的指示,LLM 開始理解其所訓練的動作為何對任務很重要。
第二個 LLM 接著評估環境的細節,例如障礙物的位置和機器人目標物體的形狀。在此過程中,它會「遮罩」(換句話說,忽略)它認為與手頭任務無關的元素,將每個元素評分為「1」(重要)或「0」(不那麼重要)。例如,用戶在示範期間是否靠在桌子上會被評為「0」,使其變得不相關。任何被認為是「1」的細節都會被演算法納入最終的行動計畫中。
這些遮罩讓 Masked IRL 在 3D 和真實世界的示範中,相較於同類基準方法具有關鍵優勢,因為它教會了機器人哪些資訊需要優先處理。多虧了研究人員的系統,虛擬和真實機器人都能巧妙地在障礙物周圍移動物體,例如將咖啡杯繞過筆記型電腦移動到桌上不同的位置。在這些任務中,Masked IRL 正確識別用戶未在提示詞中明確說出的偏好,比同類基準方法高出多達 15%。
在模擬實驗中,CSAIL 研究人員還發現 Masked IRL 學習速度很快。它比其基準方法需要更少的示範來理解如何移動馬克杯。他們還發現,當 LLM 澄清指令時,機器人的表現更好,而不是讓機器人嘗試遵循模糊的請求。這種更具針對性的方法也很好地轉移到真實的機械手臂上,執行了系統在訓練階段未曾見過的提示詞。
在經過 50 次動覺示範訓練後,機器人小心翼翼地將杯子移向人類,同時避免與用戶的電腦碰撞,這是它透過闡述更一般的「保持距離」請求而學會避免的障礙。它還在「靠近」桌子時擦拭了桌子,並在「遠離」人類和桌子時遞給用戶一包洋芋片。
Masked IRL 感知並解釋了用戶未說出的內容,但很快,它也可能「看見」這些內容。CSAIL 研究人員計劃透過為其配備攝影機,讓機器人能夠拍攝周圍環境的圖像,從而使他們的方法更具動態性。然後,它就可以突出並專注於附近的特定元素。例如,如果你要求機器人撿起一個玩具,它可能會看到附近的一些香蕉,然後在處理其目標物體之前忽略它們。
Hwang 與三位 CSAIL 同事共同撰寫了這篇論文:博士生 Alexandra Forsey-Smerek ’20, SM ’22;博士後研究員 Nathaniel Dennler;以及麻省理工學院助理教授 Andreea Bobu,她是航空航天系和 CSAIL 的成員。
他們的工作部分得到了 Tata Group 透過 MIT 生成式 AI 影響聯盟獎以及美國國防部的支持。他們將於 2026 年 6 月在 IEEE 國際機器人與自動化會議上展示該專案。


