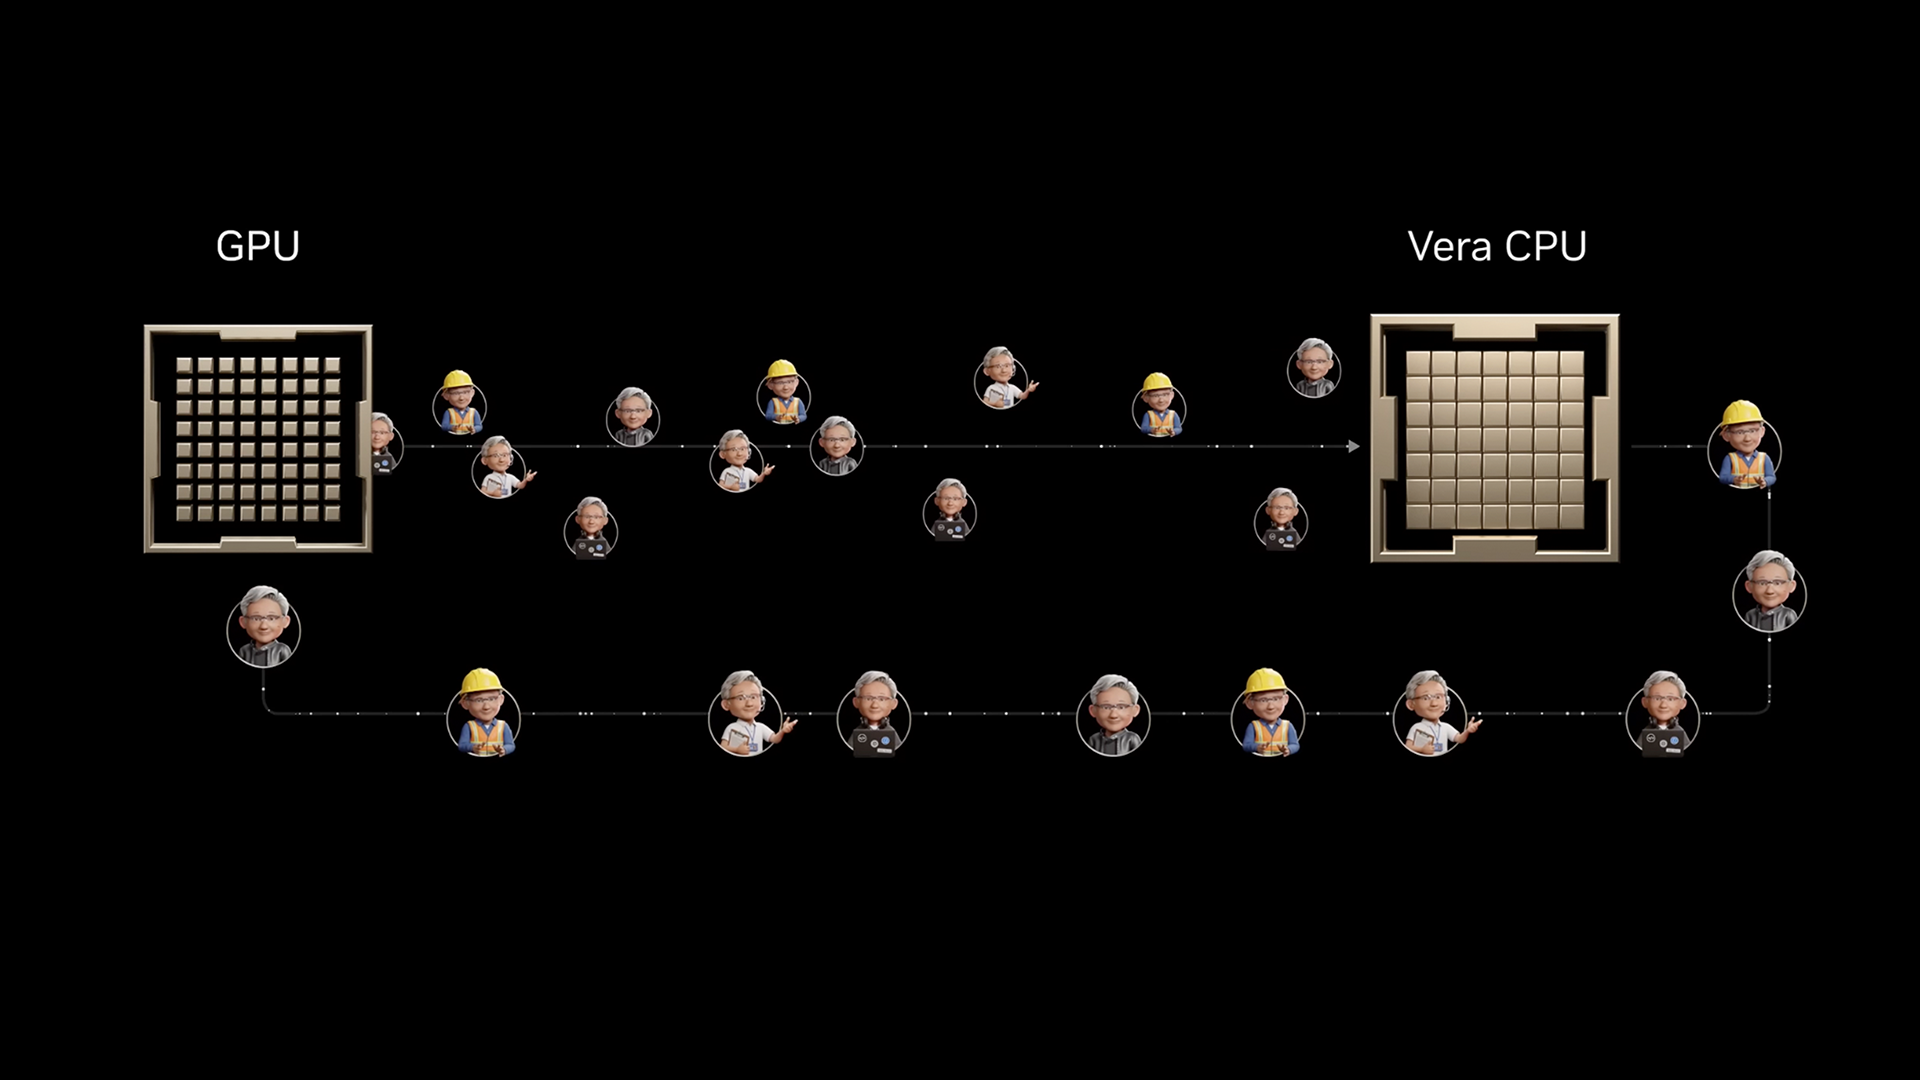
大規模單執行緒 CPU 是為代理式 AI 時代打造的新型 CPU。
在代理式系統的建立與部署過程中,CPU 在推理、回應時間和學習方面扮演關鍵角色。CPU 負責執行 AI 模型發出的指令,包括工具呼叫、程式碼執行、資料處理、KV 快取和結果分析。
對於 AI 工廠中的代理而言,速度至關重要。CPU 執行工具的速度越快,代理完成手邊任務的速度就越快。
對於 AI 工廠來說,GPU 的利用率是資料中心中最寶貴的資源,因此任何等待任務完成的時間都會限制 AI 工廠的營收,甚至更糟的是,影響 GPU 利用率,因為它在等待 CPU 完成任務。AI 工廠需要具備最大單執行緒效能的 CPU,以最大化 AI 工廠的營收和代理效能。
現今的資料中心 CPU 並非為大規模速度而設計。儘管世界上有適用於 PC 和工作站的快速 CPU,但資料中心 CPU 的發展方向卻偏離了單執行緒效能。雲端的出現促使 CPU 製造商打造更高核心數的 CPU,同時以犧牲效能為代價來最小化成本。
打造優化每個可租用核心成本的 CPU,增加了每個晶片的核心數量,卻減少了用於提升核心速度的矽晶面積,例如高效能記憶體架構和更快的單核心指令處理。轉向小晶片架構進一步降低了成本,但也產生了「小晶片稅」,使得每個 CPU 的核心無法再完全存取晶片的記憶體效能。
AI 代理需要專為大規模單執行緒效能設計的 CPU。大規模單執行緒 CPU 能夠在系統滿載時,保持每個代理步驟的快速執行。每個核心都能以全速完成代理任務,而不會被其他核心拖慢。大規模單執行緒 CPU 的設計有所不同,旨在提供:
負載下強勁的單核心效能
每個核心足夠的記憶體頻寬以供應資料
可預測的延遲
每個核心都能完成其任務,而不會被其他核心拖慢,從而提供卓越的吞吐量,更重要的是,實現最快的單核心任務效能。NVIDIA Vera 正是這類新型 CPU 設計的典範。
大規模單執行緒 CPU 如何為代理迴圈而生
AI 代理在單一請求後並不會停止運行,它以迴圈方式運作。模型推理下一步,CPU 執行模型周圍的工作,結果返回,模型決定下一步該怎麼做,然後迴圈再次運行。
這種模式產生了一種傳統 CPU 未優化的需求模式。傳統 CPU 的工作是間歇性且由使用者驅動的,由人們觸發的短暫互動組成。代理式工作則是持續且並行的:大量代理持續運行,每個代理都透過一系列步驟推進,其中每個步驟都依賴於前一個步驟的結果。
CPU 中更多的核心意味著每個 CPU 可以處理更多的代理任務,而資料中心 CPU 需要大量核心才能最大化任務的吞吐量。
然而,增加 CPU 的核心數量並不能縮短單一代理迴圈中每個步驟的時間。更多的核心無法讓任何一個任務運行得更快。事實上,旨在最大化核心數量的 CPU 甚至可能因為爭奪資源而降低每個核心的效能。
單獨的單核心效能對於推動每個步驟的完成速度至關重要。額外核心的吞吐量雖然有用但不足夠。由於每個動作都依賴於前一個結果,因此單核心速度決定了迴圈推進的速度。
單執行緒核心效能與吞吐量。歸根結底,最好的代理式 CPU 需要最佳的單核心單執行緒效能,並且每個核心都需要毫無妥協地提供這種效能。世界以秒計時,而代理則以奈秒計時。NVIDIA Vera 正是為這種新型工作和速度而生。
NVIDIA Vera 是為代理設計的大規模單執行緒 CPU
NVIDIA Vera 是一款大規模單執行緒 CPU,從頭開始為代理迴圈設計:即代理在使用工具、處理資料、執行程式碼和檢查結果時,在模型呼叫之間發生的工作。
NVIDIA Vera CPU。
Vera 的核心是 NVIDIA 的客製化 CPU 核心 Olympus,其每週期指令數比 NVIDIA Grace 高出 50%。這很重要,因為許多代理步驟是循序的。工具呼叫、程式碼執行、測試運行或資料處理步驟必須先完成,下一個模型呼叫才能使用結果。更快的核心能更快地推進每個迴圈。
Vera 將這些更快的核心與高達 1.2TB/s 的 LPDDR5X 記憶體頻寬(功耗低於 40 瓦)配對,加上單晶片運算核心,有助於活躍核心持續獲得資料供應,並透過 3.4TB/s 的核心間頻寬保持資料移動的可預測性,這是任何其他資料中心 CPU 的三倍。這使得所有 88 個核心都能獲得 CPU 的完整記憶體效能,而不會產生拖慢每個核心的瓶頸。
結果是更快的代理迴圈。在代表代理式執行的負載 CPU 工作負載中,Vera 提供比 x86 高 1.8 倍的持續單核心效能。
這些效益在工具呼叫、程式碼執行、資料處理步驟和驗證過程中累積,幫助 AI 工廠利用現有的 GPU 完成更多代理工作。
Perplexity 測試了 Vera 在其日常運行的代理式工作。在運行真實的程式碼工作流程(複製儲存庫並在沙盒中執行其測試套件)時,Vera 完成任務的速度比 x86 快約 1.5 倍,並以高達 1.9 倍的速度啟動並行沙盒。Perplexity 目前正尋求在其即將推出的生產系統中部署 Vera。
代理也依賴資料。它們不斷地查詢、檢索、過濾和移動資訊,而 Vera 能更快地運行這些 CPU 端的資料工作負載。合作夥伴測得使用 Starburst 進行大規模 SQL 分析速度快 3 倍,使用 Redpanda 進行即時串流的延遲降低高達 6 倍,兩者均優於領先的 x86 伺服器 CPU。
代理工作並非單一工作負載。代理運行工具和沙盒、處理資料、服務請求並透過強化學習訓練下一個模型,所有這些都依賴於相同的優勢。
一個 Vera 即可處理所有範圍的工作,而無需為每種工作類型配備不同的 CPU。而且由於 Vera 是 NVIDIA Vera Rubin 中託管 GPU 的相同 CPU,並為 NVIDIA BlueField-4 STX 儲存處理器提供動力,整個 AI 工廠都運行在單一架構和單一工具鏈上。
NVIDIA 並未止步。NVIDIA 的下一代 Rosa CPU 搭載 Rigel 核心,將繼續公司為代理式 AI 時代規劃的 CPU 藍圖。Rigel 是 NVIDIA 的下一代 Arm v9.2 CPU 核心,在保持相同晶片面積的同時,提供比 Olympus 更高的單核心效能。主要改進包括更好的指令傳遞、更大的 L2 快取和更高效的記憶體處理。
為代理的速度而生
在代理式 AI 時代,將有數十億個代理,每個代理都將依賴 CPU 進行行動、檢查、檢索、執行和驗證。在這個新市場中,完成的代理工作就是產品。更快的代理迴圈有助於每個 GPU 花更多時間產生營收的工作,減少等待時間。
NVIDIA Vera 是為這個未來而打造的 CPU。
了解更多關於 NVIDIA Vera CPU 的資訊。


