恭喜 Meta Superintelligence 擁有全球前二或前三的圖像/影片模型!這本來有機會成為頭條新聞,但可惜我們對 Muse Image/Video 的細節知之甚少,沒有論文,也沒有任何技術細節。儘管如此,這仍然超越了上個月的 Microsoft MAI 模型,表現不錯。
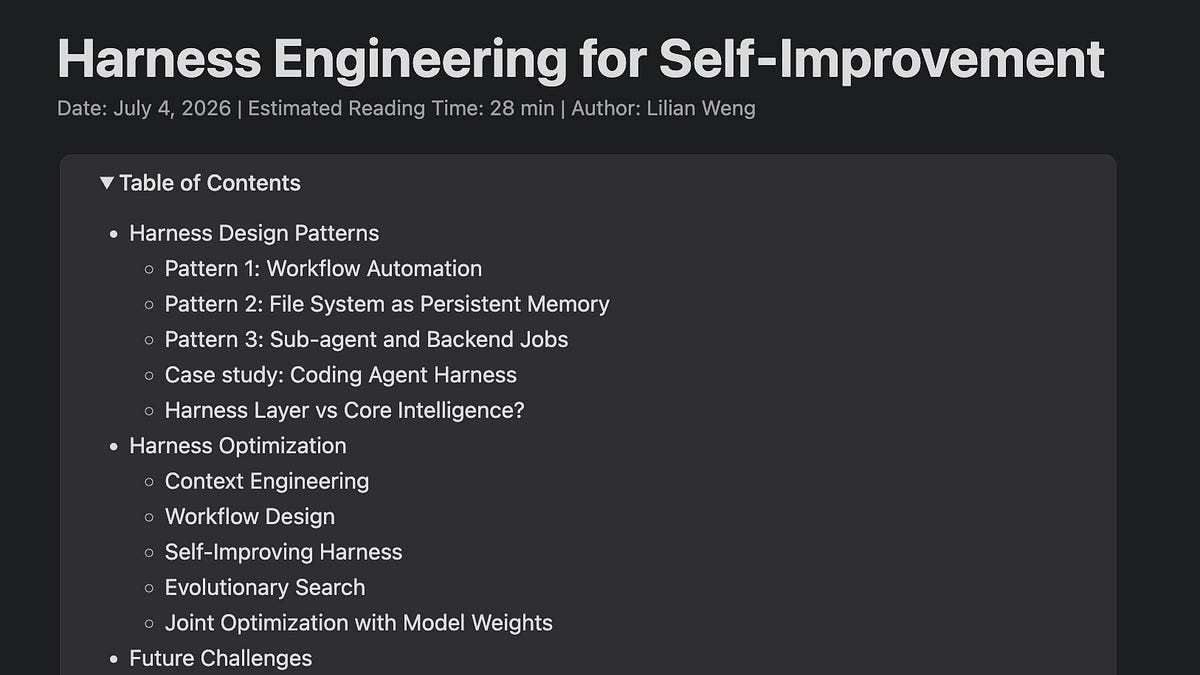
我們是 Lilian Weng 的忠實粉絲,因此每當她發布新的研究回顧時,我們都會特別留意,尤其現在她已是 Thinky 的共同創辦人,這種機會更為難得。今天,她正在思考「駕馭工程」(harnesses)與 AI 自我改進(RSI)之間的關係。
Lilian Weng 在她的新文章中探討了 AI 自我改進的「駕馭工程」。她認為,未來 AI 自我改進對駕馭工程的依賴程度難以預測,但駕馭工程很可能會朝著自我改進和自動研究的方向發展,進而實現更智慧的 AI。
我們之前曾報導過,即使是 Greg Brockman 現在也默默支持代理/駕馭工程。令人欣慰的是,像 Lilian 這樣受人尊敬的思想家和新實驗室共同創辦人也認同:「即使許多駕馭工程的改進最終被核心模型內化,指定目標和情境的需求也不會消失。」
她的文章闡述了駕馭工程中所有人都應該了解的主要設計趨勢,並回顧了駕馭優化相關文獻,從著名的 ACE 論文到最近的 Meta-Harnesses 等趨勢,這些我們都曾在 AINews 上非正式地報導過。這也暗示了 Thinky 除了互動模型之外,還在思考什麼。
這是 2026 年 7 月 6 日至 7 月 7 日的 AI 新聞。我們查閱了 12 個 Reddit 子版塊、544 個 Twitter 帳號,但沒有進一步的 Discord 資訊。AINews 網站提供所有過往刊物的搜尋功能。提醒您,AINews 現已成為 Latent Space 的一個專區,您可以選擇訂閱或取消電子郵件頻率。
Anthropic 擴展了 Claude 的「背景代理」使用者體驗:最受關注的產品發布是 Claude Cowork 登陸行動和網頁平台,將 Claude 定位為執行任務的背景隊友,而非前景聊天介面。相關貼文顯示產品正朝著共享首頁標籤和更緊密的 Chat/Cowork 整合方向發展。
此外,Anthropic 透過 @claudeai 的高參與度公告,將付費方案用戶使用 Claude Fable 5 的權限延長至 7 月 12 日,儘管許多用戶在 @kimmonismus 等人的回應中指出,這與每週使用限制的時間點有些尷尬。
駕馭工程日益成為代理設計的核心:Lilian Weng 的新文章被廣泛引用,將遞迴式自我改進的重點重新定義為圍繞駕馭工程,而非直接修改模型權重。Sakana 的摘要將此與 The AI Scientist、ShinkaEvolve 和 Darwin Gödel Machine 聯繫起來。
LangChain 也響應了這一轉變,推出了新的 Deep Agents 課程和一個開源駕馭專案。Google 也在將此方向產品化:Gemini API Managed Agents 增加了背景執行、遠端 MCP 伺服器、自訂函數呼叫和憑證刷新功能。
實用代理基礎設施的意見越來越明確:有幾項值得注意的面向操作員的更新。Codex Mobile iOS 增加了任務管理、過濾差異、SSH 金鑰登入、分支比較和附件流程。
Hermes Agent 增加了可插拔的秘密管理器,以及原生的 1Password 整合,並支援將會話/資料集匯出到包括私人 Hugging Face 儲存庫在內的格式。Weaviate 1.38 的 MCP 伺服器已全面上市,提供執行時控制的寫入權限,特別是允許在不重啟的情況下即時切換 MCP_SERVER_WRITE_ACCESS_ENABLED。
@omarsar0 還提出了一種更具實驗性的模式,使用 Dial MCP 伺服器,讓代理可以透過電話/簡訊/iMessage 升級決策,實現人機協作控制。
Meta 的 Muse Image/Muse Video 將代理式生成推向媒體領域:Meta Superintelligence Labs 推出了 Muse Image 並預覽了 Muse Video。其顯著的技術角度不僅在於圖像品質,更在於明確的代理式生成循環:在渲染之前進行規劃、網路搜尋、工具使用、程式碼執行和自我完善。
Meta 還表示,性能會隨著測試時運算規模的擴大而提升,並且自我完善行為是在強化學習過程中自然產生的,而非手動編寫。在公開評估中,Muse Image 迅速在 Image Arena 排名中位居第二,僅次於 GPT Image 2,而 Muse Video 則在 Video Arena 首次亮相便位居第三。
NVIDIA 和 Cohere 都發布了強大的音訊模型:NVIDIA 發布了 Audex,這是一個擁有 300 億參數、30 億活躍 MoE 且具備 100 萬上下文的統一文字+音訊模型。該模型的核心主張是在保留文字智慧的同時,透過單一 MoE 主幹增加廣泛的音訊生成和理解能力。
Cohere 推出了 Cohere Transcribe Arabic,據稱是 Apache 2.0 授權下最準確的開源阿拉伯語 ASR 模型,特別強調方言、語碼轉換和帶有阿拉伯語口音的英語。
開源機器人技術持續整合於 Hugging Face + NVIDIA 生態系:NVIDIA 將其機器人技術堆疊擴展到 HF 生態系,將 GR00T 1.7 和 Isaac Teleop 整合到 LeRobot 中,旨在支援開源人形機器人工作流程。
在具身智慧方面,UMA 展示了強大的全棧機器人敘事:@RemiCadene 描述了一個小型團隊在 9 個月內建立的原型,而 Northstar 的揭示和 @psermanet 的安全說明則強調了垂直整合的硬體/軟體,以實現值得信賴的機器人。
Liquid AI 的「Antidoom」直接解決推理循環的失敗模式:當天最明確的技術發布之一是 Liquid AI 的 Antidoom,這是一種開源訓練方法,旨在減少小型推理模型重複生成 token 直到上下文耗盡的「死循環」。
據報導,其減少效果顯著:在貪婪採樣下,LFM2.5-2.6B 的死循環從 10.2% 降至 1.4%,Qwen3.5-4B 從 22.9% 降至 1%,並帶來下游評估的提升。該方法 FTPO(Final Token Preference Optimization)重新標記觸發循環的 token,並將機率重新分配給替代方案。這很好地體現了該領域最近的模式:移除特定的失敗模式,而不僅僅是擴大參數規模。
推理效率和壓縮仍然是主要前沿:NVIDIA 的 Puzzle-75B-A9B 壓縮工作引起了廣泛關注。它在壓縮混合 MoE 父模型的同時,保留了推理、編碼、長上下文和代理品質,使 H100 上的伺服器吞吐量約提高兩倍,100 萬上下文的併發請求從 1 個增加到 8 個。
在工具方面,Nsight Python 1.0 發布,使 GPU 性能分析可以在 Python 中編寫腳本。Unsloth 也為 DeepSeek-V4-Flash 發布了 GGUF,並支援匯出到 NVFP4/FP8,同時加速了 GRPO 和 MoE。
代理強化學習(RL)和驗證正變得更加專業化:@cwolferesearch 強調了 GRPO 風格的正規化如何被應用於任務或環境層面的代理強化學習,以處理多輪環境中較高的獎勵變異。
此外,@omarsar0 指出了一篇來自 Stanford/NVIDIA/Berkeley 的無需訓練的驗證器論文,該論文透過評分 token 的 logits 讀取校準後的連續分數,在 Terminal-Bench V2、SWE-Bench Verified、RoboRewardBench 和 MedAgentBench 上取得了優異成績,表明驗證正成為一個獨立的擴展軸。
Anthropic 的 J-space 工作主導了可解釋性討論,但也引發了尖銳批評:社群對於這項工作究竟是有用的機械分析,還是反對其意識框架,意見分歧。
@danburonline、@paul_cal 和 @scaling01 等人提出了強烈批評,他們認為這些向量在 Jacobian-lens 定義下,很大程度上是透過建構而具有因果關係的。@jacobandreas 提供了一個有用的歷史參考,引導讀者回顧原始的 Jacobian lenses 論文。
更強大的技術啟示是跨模型結構,而非意識論述:@eliebakouch 計算了 38 個開源模型在 J-lens 幾何上的 CKA 相似度,發現了令人驚訝的普遍層次/深度組織,即使在 Llama 和 OLMo 等不相關的模型家族中也是如此。
Anthropic 和 Neuronpedia 也發布了開源模型的 J-lens 權重。同時,Goodfire 引入了用於激活中多維概念的 Block-Sparse Featurizers,認為許多視覺概念本質上是 2-4 維的區塊,而非單一方向。
代理和法律基準測試持續揭示「通過多項標準」與「完全解決實際工作」之間的差距:Agent Arena 將 Claude Sonnet 5 (Thinking) 排在第六位,在確認任務成功和 bash 使用方面表現最強,但在可控性方面仍存在不確定性。
Artificial Analysis 推出了 Harvey LAB-AA,這是一個涵蓋 24 個實踐領域、超過 120 項私人法律任務的法律代理基準測試。其中 Claude Fable 5 以 14.2% 的總通過率領先;Claude Opus 4.8 和 GLM-5.2 以 7.5% 的通過率並列,而 GLM 達成此成績的每任務成本約為 Fable 的 6%。
這傳達的重要訊息是,模型即使能滿足許多單一評分項目,仍可能無法產生可接受的端到端交付成果。
研究自動化和專業領域系統正在擴展:Google 在 ICML 貼文中推廣了 Experience AI Scientist,這是一個用於端到端科學工作流程的多代理系統。
DeepMind 也推出了 Predicting the Past,透過簡單的英語互動,將 Gemini 應用於 Aeneas 和 Ithaca 進行希臘/拉丁歷史分析。在法律 AI 商業化方面,Norm Ai 宣布完成 1.2 億美元的 C 輪融資,估值達 12 億美元,並描述了一個涵蓋軟體和 AI 原生律師事務所的全棧「代理法律」設置。
熱門推文(依參與度):Claude 存取/產品發布:Claude Cowork 在行動和網頁上的推出,以及 Fable 5 存取權限延長至 7 月 12 日,是技術相關產品公告中參與度最高的。
開源開發者計畫:@ClaudeDevs 為開源維護者提供 6 個月的 Claude Max 20x 服務,引起了巨大反響,可能對開源生態系統中的工具採用產生影響。Meta 媒體生成:Muse Image 的發布和其在 Arena 排名第二,是最大的多模態產品新聞。
推理可靠性:Liquid AI 的 Antidoom 發布是當天信號最強的訓練技術貼文。可解釋性:38 個開源模型之間 J-lens 的跨模型普遍性,是 J-space 討論最強的技術後續。
騰訊發布新的開源模型 Hy3:騰訊在 Hugging Face 上發布了非預覽版的 Hy3 開源模型系列,這是一個擁有 2950 億總參數、210 億活躍參數的 MoE 模型,現已改為 Apache 2.0 授權,而非之前限制性的社群授權。
該貼文強調,先前的授權據報導排除了在韓國、英國和歐盟等地區的使用。熱門評論指出,與 HY3-Preview 相比,該模型在基準測試中有所提升,並認為這可能與高階本地/家用推理設置相關。評論者認為 Apache 2.0 的重新授權是最重要的改變,特別是考慮到騰訊最近的翻譯模型也採用 Apache 授權。人們對報導的基準測試改進是否能轉化為實際應用價值持謹慎樂觀態度。


