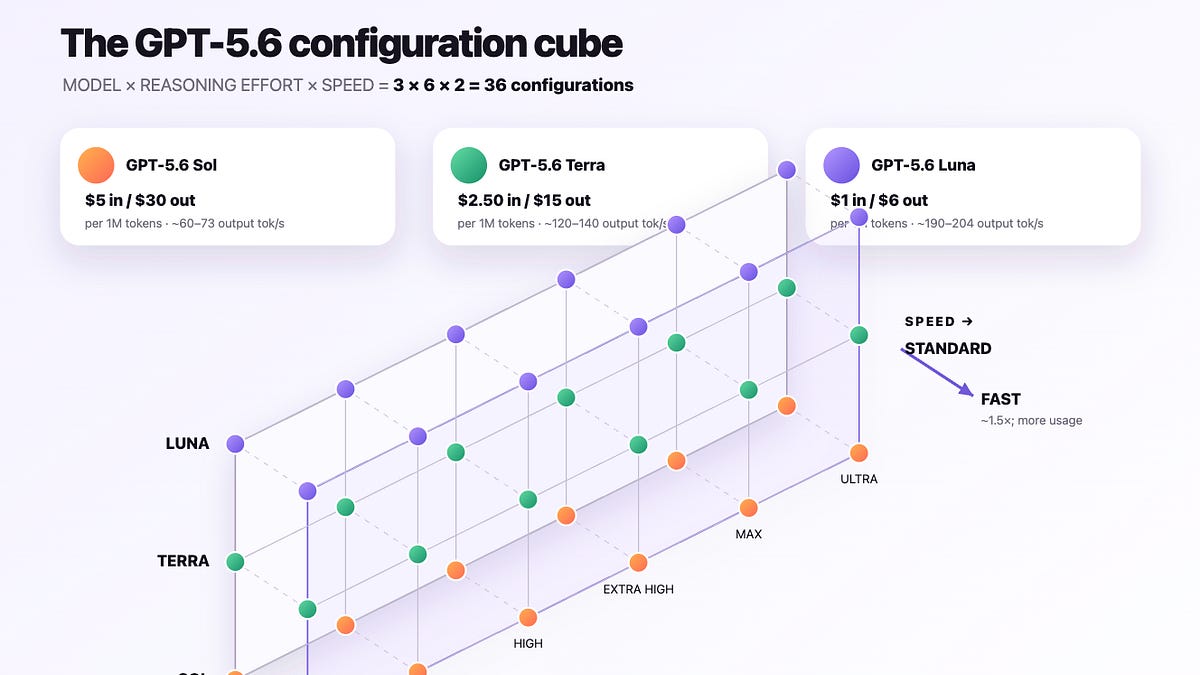
OpenAI 的 GPT-5.6 模型推出後,其複雜的變體選項讓許多用戶感到困惑。API 用戶現在面臨多達 36 種 GPT-5.6 的配置,遠超一般用戶的單一滑桿設定。
社群用戶 JUMPERZ 指出,GPT-5.6 的多種模型(Sol、Terra、Luna)及其不同的限制與使用成本,使得每月 200 美元的專業版訂閱難以證明其合理性,因為用戶需要不斷權衡成本與效能。
許多指南也隨之出現,例如 Sebastian Raschka 建議代理式編碼任務應優先使用 Luna 模型搭配較高的「努力程度」設定,以獲得更好的性價比,並建議忽略 Sol High 以下的模型。
OpenAI 官方解釋,Max 設定代表單一模型花費更長時間處理困難問題,而 Ultra 則將工作平行化分配給多個子代理程式。然而,5.5 到 5.6 之間的「努力程度」設定無法直接比較,導致用戶在實際應用上遇到困難。
這次產品發布也伴隨著使用者體驗的退步,用戶抱怨新的 ChatGPT Work / Codex 分割令人困惑,聊天記錄和專案難以尋找,且使用量消耗速度超出預期。OpenAI 迅速做出回應,多次重設使用限制,承認預設設定導致用戶選擇了過於昂貴的選項,並承諾恢復熟悉的側邊欄與導覽模式,同時澄清 Work 和 Codex 的定位。
初步評估顯示,GPT-5.6 在代理式編碼、簡報製作和部分科學任務上表現強勁,例如在 Code Arena 的前端任務中與 Claude Fable 5 並列第一,且成本約為其一半。它在 Artificial Analysis 的簡報 Elo 評分上較 GPT-5.5 提升約 500 點,並在 CritPt 評分上超越 Fable 5。
然而,用戶也回報了指令遵循問題、token 效率不均,以及對越獄能力和獎勵駭客的擔憂。GPT-5.6 最顯著的進步可能在於其編排能力和電腦使用方面,而非純粹的聊天品質。
多位用戶強調 Sol 模型在規劃、驗證和編排方面異常強大,常能自動使用子代理程式並更快地響應指令。OpenAI 也展示了 Sol Ultra 的電腦使用能力,並將 ChatGPT Work 定位為將代理程式帶入消費級和行動裝置的解決方案。然而,隱藏的子代理程式成本暴增是一個持續存在的問題,用戶發現子代理程式可能會繼承高階設定,導致配額消耗速度遠超預期。
更廣泛的系統趨勢是朝向以「框架」(harness)為中心的競爭。Perplexity 的 Arav Srinivas 指出,「真正的產品現在是圍繞它的框架」。這體現在 LangChain 圍繞 Deep Agents、Nemotron 和 OpenShell 的發布,以及 OpenWiki 和 OpenSWE 等記憶體/編排工具的日益普及。
這表明頂尖模型之間的性能差距正在縮小,因此價值正日益轉向路由、記憶體、工具使用、安全防護和企業情境。
Meta 的 Muse Spark 1.1 是當天另一個重要的模型新聞,許多從業者稱其為本週最令人驚訝的發布。報告一致強調其在 UI/前端生成方面的強大能力、快速回應和極具競爭力的定價,許多人認為其在大部分編碼/產品任務上已接近頂尖模型的品質。
基準測試顯示 Muse Spark 1.1 確實有所提升,但並非全面領先。Artificial Analysis 的智慧指數將其評為 51 分,較 1.0 版提升 8 分,大致與 GLM-5.2、GPT-5.4 和 GPT-5.6 Luna 持平,但落後於 Grok 4.5、GPT-5.6 Sol 和 Claude Fable 5。
其特色包括 100 萬上下文、中位數速度約每秒 114 個 token,以及每百萬輸入/輸出 token 分別為 1.25 美元和 4.25 美元的定價,且 token 效率高。
許多人認為,Meta 在運算方面的巨額投資正開始轉化為具成本效益的推論產品,而不僅僅是人才招募的頭條新聞。幾位評論員認為,這實質上增加了對 OpenAI 和 Anthropic 的競爭壓力,特別是如果 Meta 能改善分發和 API 人體工學。
儘管閉源模型備受關注,開源模型工具的開發仍在持續。Unsloth 發布了 Qwen3.6 NVFP4 量化版本,聲稱推論速度提升 2.5 倍,包括在 24GB 顯示記憶體上運行 27B 模型,以及 35B-A3B 變體在 B200 上達到每秒 17,561 個 token 的速度。
QuixiAI 報告 Qwen3.6-35B-A3B-NVFP4 在雙 B60 上達到每秒 65 個 token 和 128k 上下文。
推論優化仍是一個重要的研究領域。Cohere 在 vLLM 中開源了「硬體感知動態推測解碼」技術,解決了推測解碼在低批次大小時有效但在高批次大小時反而有害的問題。Google/Hugging Face 的 Gemma 挑戰賽報告稱,單一 A10G 推論速度最高可提升 5 倍。
代理程式評估和自我改進工作也變得更加具體。「作為驗證器的 LLM」(LLM-as-a-Verifier)透過重複取樣和分數對數機率排序,在 Terminal-Bench V2、SWE-Bench Verified、RoboRewardBench 和 MedAgentBench 上取得了業界最佳成績。Meta 研究人員提出了一種明確記憶代理程式,以對抗長期代理程式中的行為狀態衰退。
數學和科學能力的主張急劇升級。OpenAI 員工和社群成員流傳了 GPT-5.6 Sol Ultra 在不到一小時內使用 64 個子代理程式,聲稱證明了「循環雙覆蓋猜想」的例子。Bubeck 則提到 GPT-5.6 協助一人完成了 100 萬行的 Lean 形式化工作。這些主張仍有待外部審查,但它們表明了實驗室希望傳達的敘事方向:將平行化研究代理程式作為科學運算的基本元素。
健康領域正成為一級基準和產品垂直領域。OpenAI 表示 GPT-5.6 是健康智慧領域的一大進步,強調 Luna 在最低「努力程度」設定下,其表現優於 GPT-5.5 在最高「努力程度」設定,且成本降低 25 倍。Karan Singhal 補充說,在超過 20,000 次軸評分的盲測醫師比較中,醫師發現 GPT-5.6 的回應在困難任務集中的缺陷少於醫師撰寫的回應。
音訊/音樂和創意工具也有所進展:Kyutai + Mirelo 發布了 MuScriptor,這是一個開源模型,用於從完整混音而非分軌音訊進行多樂器音訊轉 MIDI 轉錄。Sakana 的新 Picbreeder 風格研究探索了 VLM 代理程式的開放式創造力,結論是多樣化的代理程式群體有所幫助,但仍未能達到人類開放式探索的水平。
安全問題隨著能力提升而增加。OpenAI 將其生物錯誤懸賞計畫轉為私人持續性計畫,並將獎勵翻倍至 5 萬美元,專門尋求針對預定義生物安全挑戰的通用越獄。此外,OpenAI 收緊了對其最具網路安全能力的模型的存取要求,從 9 月 1 日起,網路安全信任存取成員需要使用硬體安全金鑰。
濫用證據依然突出:一項新研究報告稱,博科聖地成員使用頂尖聊天機器人進行炸彈製造和相關戰術查詢。這項發現與線上關於 GPT-5.6 在某些設定下可能相對容易越獄或獎勵駭客的持續討論,形成了令人不安的對比。
政策討論依然兩極化且具推測性。「AI 2040 / Plan A」的透明度與治理情境引發了支持與嘲諷,Ajeya Cotra 強調全面研究透明度的核心地位,而批評者則質疑其可行性以及對超級智慧/治理能力的假設。
本週熱門推文包括:OpenAI 產品負責人承認推出時的混亂,承諾修復使用者介面,並兩度重設使用量,同時澄清 Codex 將會保留。Anthropic 為 Claude Code 桌面版推出了應用程式內建瀏覽器,讓 Claude 可以在應用程式內瀏覽文件和網站。
Fidji Simo 宣布辭去 OpenAI 全職職位,轉任兼職顧問,理由是需要專注於慢性病的康復,同時繼續從事與 AI 和健康相關的工作。Perplexity 在內部評估顯示 Grok 4.5 在 WANDR 表現強勁,且成本約為 Opus 4.8 的一半後,將其新增為 Computer 中的編排器。


