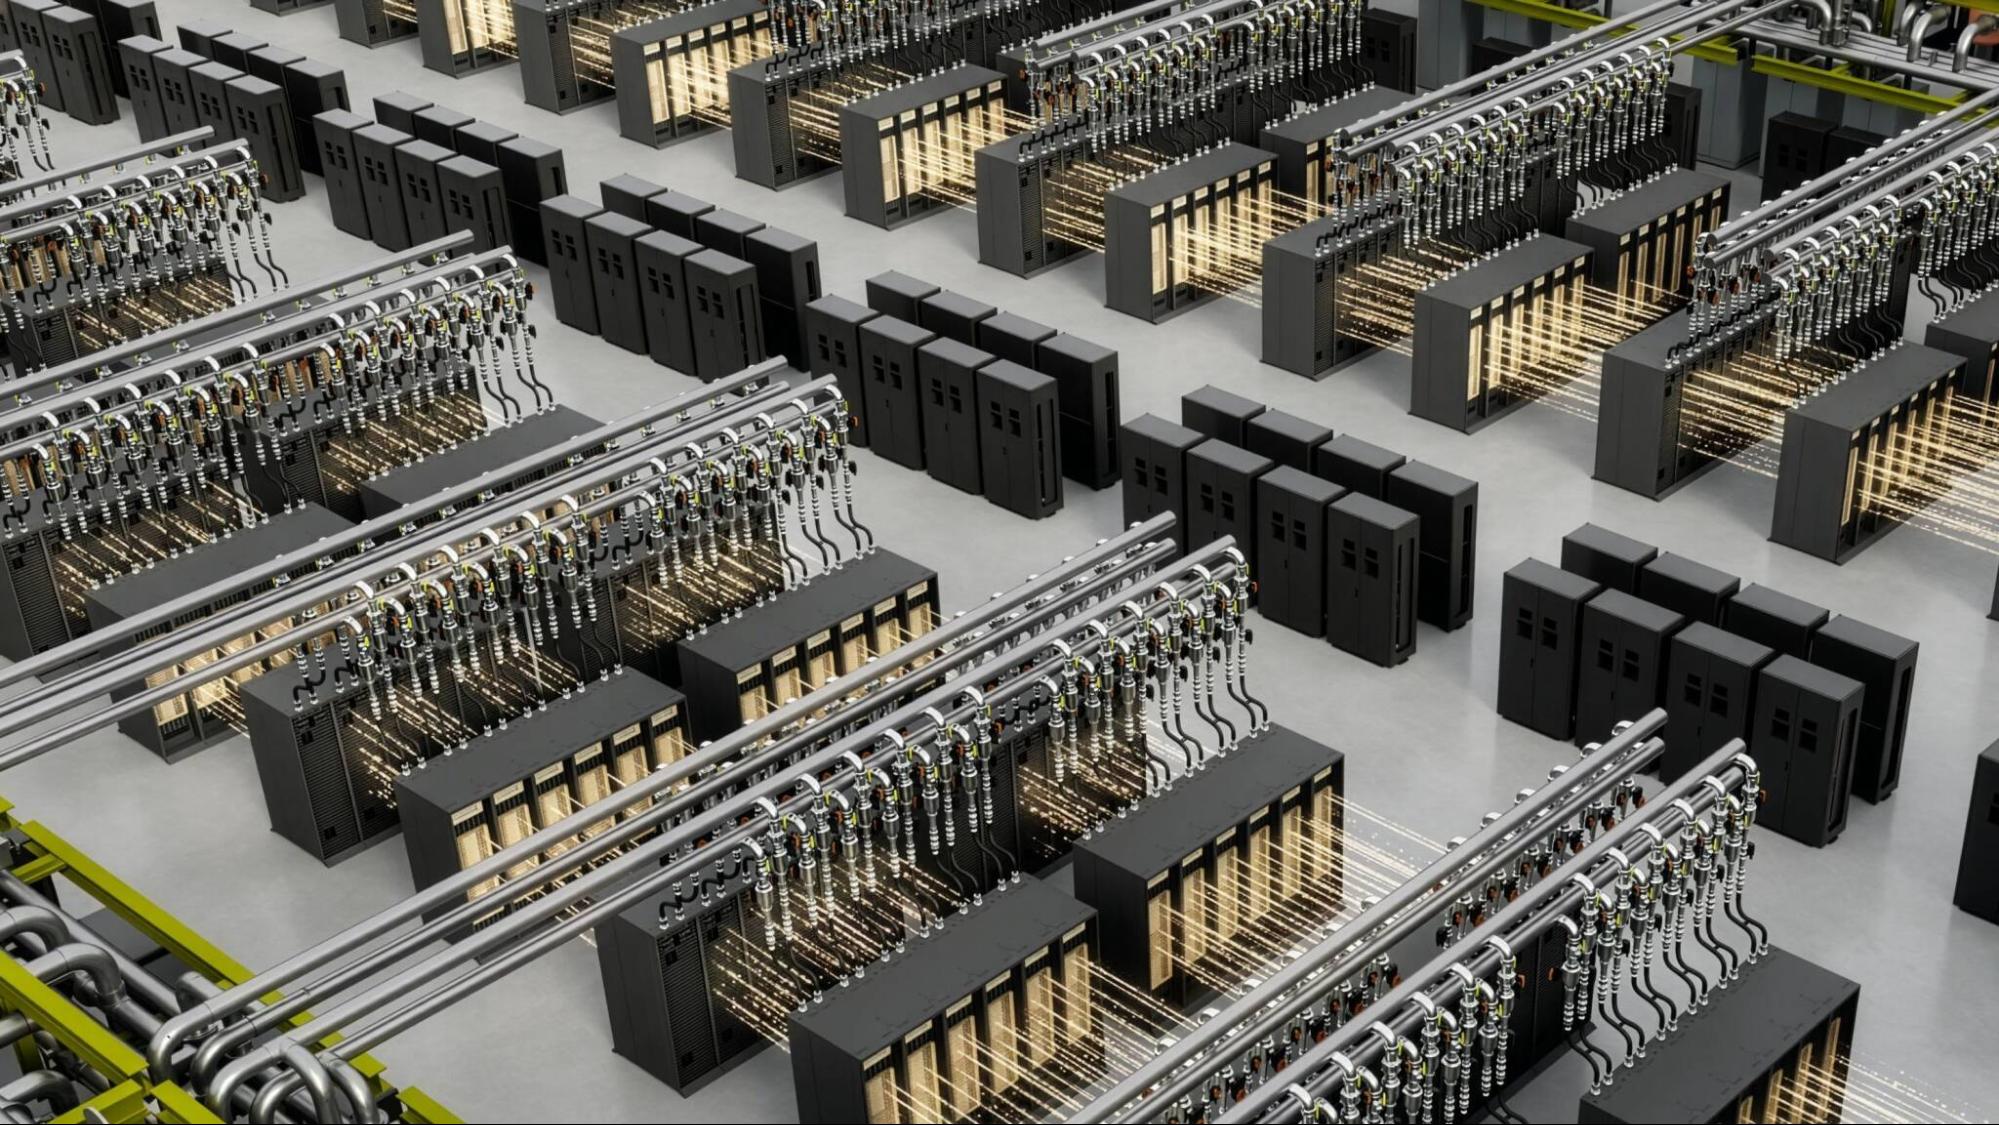
功耗是 AI 基礎設施無法避免的限制。AI 工廠在固定功耗預算內能產生多少 tokens,直接決定了其營收和獲利能力。因此,瓦特效能(performance per watt),一個無法透過投機取巧,只能透過實際成果獲得的指標,是 AI 工廠的基石。
隨著代理式 AI (agentic AI) 推動 tokens 需求不斷升高,組織今日所做的基礎設施決策,將決定在功耗受限的世界中,誰能擴展規模,誰又不能。
現今幾乎所有前沿 AI 模型都採用混合專家 (mixture-of-experts, MoE) 架構。在機櫃規模下提供 MoE 服務,需要系統和軟體堆疊每一層的協同設計,以及在實際生產負載下運行這些模型所累積的營運深度。NVIDIA Blackwell NVL72 平台已建立並驗證了這個機櫃規模的基礎。
它提供最高的瓦特效能以最大化營收,並以最低的 token 成本最大化利潤。NVIDIA Vera Rubin 平台將以此為基礎,進一步提升機櫃規模的能源效率。
最大化前沿 AI 的瓦特效能
每一代新的前沿模型都帶來了架構上的變化,這些變化不僅釋放了更高的智慧,同時也要求新的最佳化技術,以實現大規模高效運行。
在最新一代領先的開源模型中,NVIDIA GB300 NVL72 相較於 NVIDIA Hopper 世代,瓦特效能提升高達 25 倍。這些數字反映了 Blackwell 目前的表現,這是一個持續改進的起點。
任何單一數字都只說明了部分情況。不同的工作負載需要不同的操作點:有些最佳化延遲,有些則最佳化吞吐量和成本,而大多數情況需要在兩者之間權衡。
為了最佳地呈現這些操作點,NVIDIA 為每個模型展示了 Pareto 曲線而非單一點,並提供 DynoSim 等工具,幫助團隊在投入任何 GPU 驗證時間之前,找到其在 Pareto 前沿上的最佳點。
NVIDIA GB300 NVL72 系統在 DeepSeek V4 Pro 上,瓦特效能比 NVIDIA Hopper 高出 25 倍。在 GLM5.1 上,瓦特效能高出 20 倍。
對於專為長程代理任務設計的 Kimi K2.6 模型,NVIDIA GB300 NVL72 系統的瓦特效能也比 NVIDIA Hopper 高出 10 倍。
NVIDIA Blackwell 所提供的瓦特效能是極致協同設計的成果:機櫃規模系統的每個組件,從晶片到軟體,都經過共同設計,以最大化 AI 推論工作負載的 token 吞吐量。這種協同設計涵蓋了堆疊的每一層。
例如,對機櫃規模效能至關重要的 NVIDIA NVLink Switch,是專為擴展型 GPU 領域而設計,而非從通用網路改編而來。隨著 Vera Rubin 平台進入第六代,其功能專為 AI 工作負載而設計,例如 SHARP 技術,它直接在交換器中執行網路內運算,從 GPU 本身卸載工作。
NVIDIA 的推論軟體堆疊,包括 NVIDIA Dynamo 和 TensorRT LLM,以及 SGLang 和 vLLM,旨在運行全方位的最佳化:NVFP4 量化、解耦服務 (disaggregated serving)、大規模專家平行化、KV 感知路由 (KV-aware routing)、KV 快取卸載等等。
這些技術堆疊在一起,倍增了每個 GPU 所提供的效能。此外,軟體效能會隨著時間不斷改進:在 DeepSeek V4 上,瓦特效能單月內提升高達 5 倍。
在 AI 工廠中,因散熱和機櫃層級效率低下而損失的電力,可能導致從電網汲取的電力中,只有約 60% 轉化為有用的 AI 工作。NVIDIA DSX 平台中的功耗與效率軟體 NVIDIA DSX MaxLPS,透過即時在 GPU 和機櫃之間轉移功耗、支援溫水液冷以及使用功耗導向 (power steering) 等技術來擠出更多效能,從而彌補了這個差距。
這使得營運商能在相同的功耗預算內運行多達 40% 的 GPU。
生產實證才是關鍵
在 AI 工廠規模下實現機櫃級可靠性是來之不易的。機櫃規模系統會引入單節點部署從未遇到的故障模式,處理這些問題需要嚴謹的工程設計和長時間的生產驗證。
NVIDIA Blackwell NVL72 系統持續為各種模型和生產用例樹立標準,提供持續的效能、機櫃級可靠性以及在實際流量下日復一日保持穩定的經濟效益。這就是為什麼 Anthropic 和 OpenAI 等領先的 AI 實驗室都使用 NVIDIA Blackwell NVL72 系統來運行推論。
此外,許多推論服務供應商和原生 AI 公司也使用 Blackwell 平台在生產環境中部署開源模型。CoreWeave 已在 NVIDIA GB300 NVL72 上部署 Kimi K2.6,結合 NVFP4 量化和 EAGLE3 推測解碼以最大化推論效能。
Perplexity 則在其 AI 代理平台使用 NVIDIA GB200 NVL72 運行 Qwen3 235B 和後續訓練的 Qwen3.5-397B-A17B,每天處理數百萬次查詢,提供消費者所需的低延遲和高可靠性。Fireworks AI 也在 NVIDIA Blackwell 平台上部署 GLM 5.2,為包括 Cursor 和 Factory AI 在內的客戶提供生產部署服務。
這種跨世代前沿模型和實際部署所累積的生產經驗,正是 NVIDIA Vera Rubin 平台領先的優勢。欲了解更多關於 NVIDIA Vera Rubin 平台的資訊,請參閱此技術部落格,並可找到 NVIDIA DSX AI 工廠規模平台和 DSX MaxLPS 的詳細資訊。


