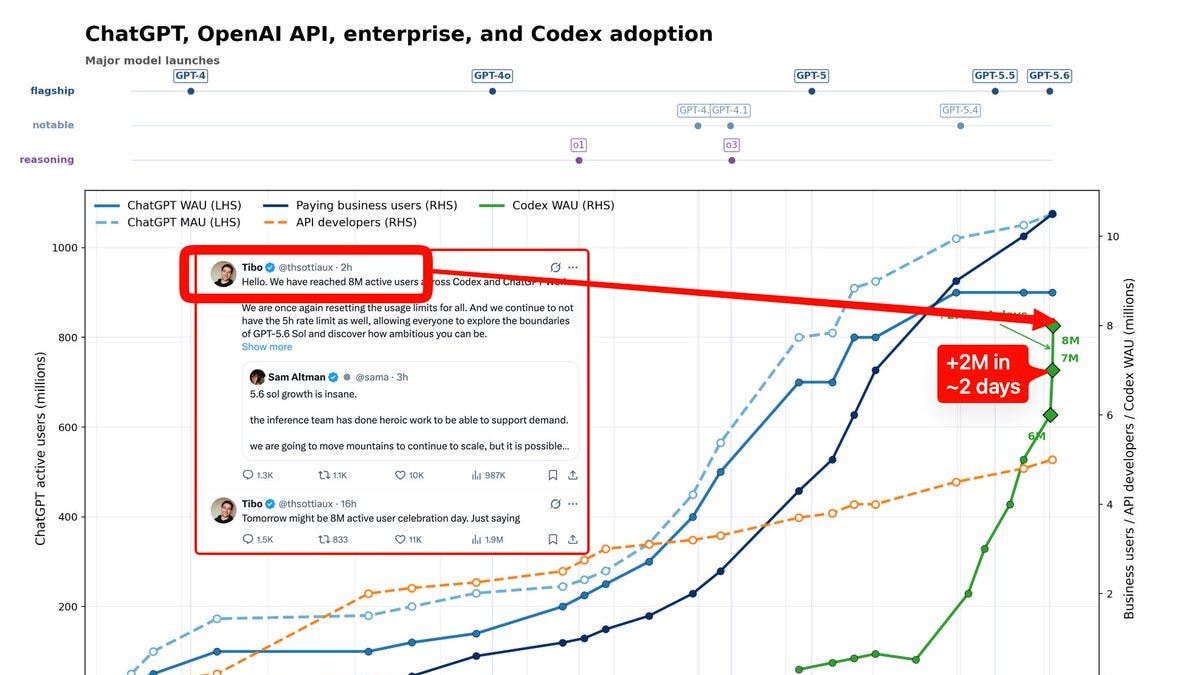
昨天頭條新聞的內容變得更加真實,Superapp 的使用量自上次報導以來又增加了 100 萬用戶。swyx 提到,這次 GPT-5.6 的發布可能是 OpenAI 自 ChatGPT 以來最成功的模型。
Latent.Space 質疑 Codex 是否超越了 Claude Code 的使用量。Tibo 在 24.5 小時前宣布 Codex 擁有 600 萬活躍用戶,這意味著 Codex 的使用量在一天內激增了 100 萬。
Claude Code 上次聽到的用戶數是二月份的 200 萬,如果這個數據屬實,那將是一個非常重大的進展。更多分析將在文中提供。
在其他新聞方面,Richard MacManus 發布了他對 AIEWF26 的最終回顧。其中包括 Addy Osmani 精彩的主題演講,內容涵蓋了即使程式碼生成成本趨近於零,AI 工程師仍應持續做的事情。
這是 2026 年 7 月 13 日至 7 月 14 日的 AI 新聞。我們檢查了 12 個 Reddit 子版塊、544 個 Twitter 帳號,但沒有進一步的 Discord 資訊。AINews 的網站讓您可以搜尋所有過去的內容,提醒您,AINews 現在是 Latent Space 的一個專區,您可以選擇訂閱或取消電子郵件頻率。
OpenAI 的代理產品正經歷異常強勁的需求。@sama 表示 Codex 和 ChatGPT Work 的使用量在一週內增長了 2.5 倍,後來又補充說 GPT-5.6 Sol 的需求「瘋狂」,可能導致基礎設施跟不上而出現擴展問題。生態系統的反應是立竿見影的。
JetBrains 將 Codex 推薦為其代理,@theo 強調了 Codex 未被充分利用的「問題工具」,而 OpenAI 自己的團隊也展示了使用 GPT-5.6 從頭到尾建構的命令列評估工具。在產品方面,OpenAI 也進行了多次使用重置,並由 @reach_vb 和 @kimmonismus 等用戶放大。
代理品質和可觀察性正成為一流的差異化因素。多條推文都指出,單靠模型品質已不足夠。@swyx 警告說,過時的 agents.md 指令可能會像自我造成的提示注入一樣,導致長時間任務停滯數小時。
LangChain 為 Codex 增加了追蹤功能,後來擴展到 LangSmith 中的 Cursor、Copilot、Pi 和 OpenCode,公開了工具呼叫、子代理和 token 使用量。@Teknium 發布了 Hermes 更新,可以並行化任何工具呼叫子集,並在 Hermes Agent 中直接公開了預存重置。
@andykonwinski 精闢地指出,能夠將其價值編碼到評估和環境中的公司,可能會比那些僅依賴資金或原始規模的公司獲得更持久的優勢。
積極的壓縮技術正在將接近前沿的模型帶到消費級裝置上。PrismML 發布了基於 Qwen 3.6 27B 的 Bonsai 27B,有兩種緊湊型變體:三元 Bonsai 27B(5.9 GB / 1.71 有效位元)和 1 位元 Bonsai 27B(3.9 GB / 1.125 有效位元),兩者均採用 Apache 2.0 授權。
其聲稱的顯著之處不僅在於大小,還在於能夠在本地保留多模態、工具使用、長上下文代理工作流程。
一個演示展示了 Hermes 在 RTX 5090 上運行它,而 Locally AI 則強調了手機部署的可能性。同時,騰訊混元發布了 1 位元和 4 位元 Hy3,描述了一個 295B 旗艦級模型,可以透過啟用 MTP 的 llama.cpp 在單一 GPU 上運行。
量化和邊緣部署持續擴大開放模型的運行範圍。@danielhanchen 宣布在 Gemma-4 系列和包括 Qwen3.5-122B-A10B 和 GLM-4.7-Flash 在內的其他大型模型上實現 NVFP4 動態量化。@MiaAI_lab 的 DGX Spark 討論串描繪了實際的多節點本地部署,包括在兩台 DGX Sparks 上運行 100 萬上下文的 DeepSeek v4 Flash 和 MiMo-V2.5,以及在四台 DGX Sparks 上運行 GLM 5.2 NVFP4。
這些貼文的共同主題是,本地推論不再僅僅是一個玩具路徑。它正變得適用於嚴肅的代理工作流程,特別是當與低位元權重格式和優化過的代理框架結合使用時。
即時多模態互動正從「先看再回答」轉變為連續感知。OpenMOSS 發布了 MOSS-VL-Realtime,這是一個 11B 視覺語言模型家族,採用 Apache 2.0 授權,具有 256K 上下文,專為連續視訊串流設計。其關鍵系統特性是它可以在生成答案的同時持續觀看,隨著場景變化修改或中斷答案,並在證據不足時保持沉默。
@Open_MOSS 的技術討論串強調了其交叉注意力架構、用於統一時間空間定位的 XRoPE,以及跨離線/串流/即時設定的統一模板。
長視訊理解越來越被視為主動證據搜尋,而非被動的影格攝取。@ZhihuFrontier 的一份詳細摘要描述了 OmniAgent,它基於 Qwen2.5-Omni-7B,使用觀察-思考-行動循環來僅請求其所需的影格/音訊。在 LVBench 上,OmniAgent-7B 據報導得分 50.5,擊敗了 Qwen2.5-VL-72B 的 47.3,同時僅消耗約 203 影格,而後者為 768 影格。
其訓練方法也值得注意:被動的 SFT 損害了性能,而 5.8 萬條代理軌跡和透過 TAURA 進行的熵加權強化學習則改善了性能。這裡更大的研究模式與 Andrew Carr 的觀點一致:運動是一種根本上新穎的資料類型,需要專門的收集、基礎設施和模型處理,而不是將其簡化為帶有時間的圖像。
開放世界模型正逐步邁向互動式、更長期的模擬。@RekaAILabs 概述了全能世界模型背後的資料堆疊,強調了數 PB 的視訊資料、六個管道階段,以及當模型同時生成和理解視訊時,資料品質改進所帶來的雙倍回報。@omarsar0 將 LingBot-World 2.0 總結為首批聲稱能實現小時級、720p/60fps 互動式生成的開放版本之一,儘管仍缺乏長期記憶。
在應用方面,PixVerse Game 被強調為正在追求即時互動式視訊回應這個更困難的問題,而非預設的遊戲式片段。
Perplexity 開源了 WANDR,這是一個用於廣泛而深入的代理研究的基準測試。@perplexity_ai 將 WANDR 描述為一個包含 500 個任務的基準測試,這些任務來自去識別化的生產研究任務,需要跨多個難度層級的 170,495 條有來源支持的記錄。WANDR 不僅根據靜態黃金集進行評分,還會重新擷取引用的頁面並根據基礎證據檢查主張,這更符合動態網路研究。
@AravSrinivas 將其視為 Perplexity Computer 深度廣泛研究框架背後的內部基準測試,而 @denisyarats 則強調了其作為從生產追蹤合成的強化學習環境的額外作用。
評估設計正變得更具對抗性和更真實。Agent Arena 強調了在匹配最佳靜態配置準確性的同時,將系統成本降低 89% 的工作,認為完整的系統配置優於單獨的 LLM 路由。與此相關,Google DeepMind 關於模型路由的研究認為,路由器的判斷標準不應僅限於準確性/成本,還應包括專家之間的行為差異以及在釋義下的穩定性;否則路由可能在功能上毫無意義。
@HamelHusain 的自動化評估貼文也得出了類似的結論:這些系統可以發現人類錯過的問題,但仍缺乏足夠的領域品味和回饋循環來取代專家。
基準測試正從一次性 SWE 任務擴展到退化和搜尋的真實性。mini-swe-agent 標誌著其一週年,現在為多個軟體基準測試提供支援;SlopCodeBench 被引用來衡量代理如何在連續任務中侵蝕程式碼庫,而不僅僅是解決一個孤立的問題。這將基準測試的範圍從「它能否解決一個任務?」擴大到「它能否避免隨著時間推移使儲存庫變得更糟?」。
Sakana AI 將集體智慧從軟體推向了實體自我修復系統。Sakana 在多個貼文中介紹了發表在《自然通訊》上的「智慧蜂窩磚」。該系統由許多相同的立方體組成,每個立方體運行一個小型神經網路,僅與物理鄰居通信,卻能夠推斷出整體形狀並檢測損壞,而無需集中控制。
一個後續細節尤其值得注意:這些單元能夠以 95% 的準確度檢測六個空間方向上缺失的鄰居並重新生長目標結構;在模擬中,該方法擴展到 18,000 多個立方體。
實體自主性也以更小的形式出現。@alextoussss 發布了一個引人注目的自主微型無人機擊落飛蛾的演示,這被視為邁向蚊子根除的一步。另外,@fchollet 強調了 Airtap,它將 SMS 轉變為行動應用程式的無頭代理執行層,使用文字作為控制平面,僅在身份驗證時進行干預。
這些是自主性光譜的不同兩端,但都指向了人類指定目標而系統處理實體或半實體執行的介面。
OpenAI 的需求激增和產品拉力:@sama 關於 GPT-5.6 Sol 定價/效率、Codex/Work 使用量增長 2.5 倍以及「5.6 Sol 增長瘋狂」是這組數據中最具影響力的營運商信號。
治理和實驗室政治:@BlackHC 關於 DeepMind 五角大廈合約和廢棄保障措施的討論串,以及 Carole Cadwalladr 對其的放大,引起了極高的參與度。同時,Demis Hassabis 的 AGI 治理提案,得到了 @mustafasuleyman 和 @sama 的認可,是一個主要的政策討論節點。
值得注意的開放模型發布:Bonsai 27B 因其 27B 規模、手機級佔用空間和 Apache 2.0 授權的結合,成為時間軸上技術實質最強的開放模型發布。


