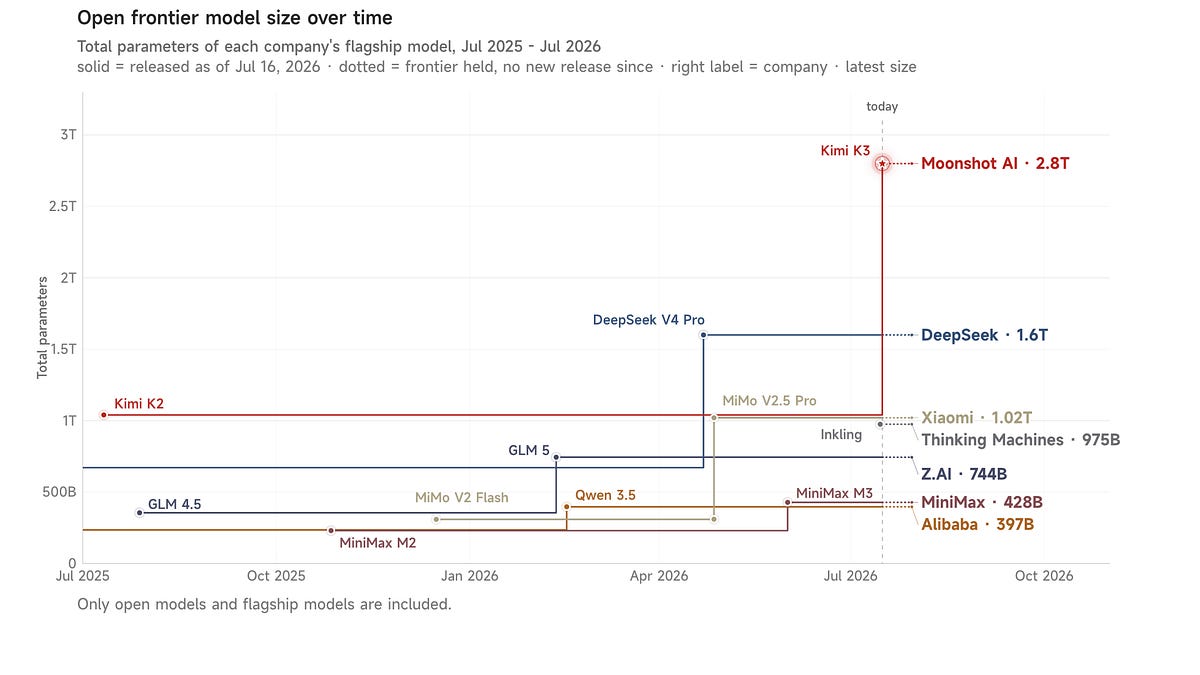
最近 Z.ai GLM 獲得了太多關注,現在是 Kimi K3 反擊的時候了!要理解這次開源模型發布的規模並不容易,幸好月之暗面(Moonshot AI)為我們做了總結。他們完全由 Kimi K3 編輯的宣傳影片非常值得一看。
根據 Artificial Analysis 的智慧指數,Kimi K3 獲得 57 分,其智慧程度可與 Opus 4.8 和 GPT-5.5 媲美,但仍落後於 Fable 5 和 GPT-5.6 Sol。月之暗面已表示計劃發布這個 2.8 兆參數模型的權重,這將使其成為領先的開源模型。
這是 2026 年 7 月 15 日至 7 月 16 日的 AI 新聞。我們查閱了 12 個 Reddit 子版塊、544 個 Twitter 帳號,但沒有進一步的 Discord 資訊。AINews 網站允許您搜尋所有過往的期刊。提醒您,AINews 現已成為 Latent Space 的一個專區,您可以選擇訂閱或取消電子郵件頻率。
月之暗面發布 Kimi K3 作為一個前沿級別的開源權重模型,官方聲稱其性能接近頂級閉源模型,並超越了之前的開源競爭者。
月之暗面正式推出 Kimi K3,稱其為「開放前沿智慧」,擁有 2.8 兆總參數、100 萬上下文視窗、原生多模態輸入、Kimi Delta Attention (KDA) 和 Attention Residuals 技術。該模型已在 Kimi.com、Kimi Work、Kimi Code 和 API 上線,並承諾於 2026 年 7 月 27 日前開源其權重。
月之暗面還強調了其產品定位,包括長週期代理式編碼和自我演化工作流程,以及「視覺迴圈」(vision in the loop)的編碼/遊戲建構工作流程,可在程式碼和螢幕截圖之間迭代。
在正式發布之前,多個帳號已流傳了 K3 擁有 2.8 兆參數的洩露或應用程式來源細節,並稱如果權重如期發布,這將是史上最大的開源權重模型。官方的 Kimi 部落格隨後上線,並被廣泛分享為主要的技術來源。
月之暗面自己的措辭承認了一項限制:儘管 K3 整體上極具競爭力,但在使用者體驗方面,與 Claude Fable 5 和 GPT-5.6 Sol 相比仍存在「明顯差距」。
Arena 宣布 Kimi K3 已進入 Agent Arena,以及 Text、Vision、Document 和 Frontend Code Arena,後續將進行社群評估。Arena 隨後報告了一項重要的早期結果:Kimi K3 以 1679 分在 Frontend Code Arena 中排名第一,超越了 Claude Fable 5,從 K2.6 的第 18 名躍升至第 1 名,並在七個前端領域中的六個領域排名第一,遊戲領域排名第二。
Arena 後來補充說,K3 在 Frontend Code Arena 中的配對勝率為 76%,而 Fable 5 為 63%,GPT-5.6 Sol 為 58%。在 Text Arena 中,K3 以 1486 分排名第九,從第 38 名大幅躍升,並在創意寫作、編碼和指令遵循方面進入前十名,在多個職業細分領域排名第一。
Artificial Analysis 發布了一項獨立評估,將 K3 在 AA 智慧指數上評為 57 分,稱其可與 Opus 4.8 和 GPT-5.5 媲美,但整體仍落後於 Fable 5 和 GPT-5.6 Sol。AA 還報告 K3 在 GDPval v2 上獲得 1668 Elo 分數,在 AutomationBench-AA 上以 53% 排名第一,並在 AA-Briefcase 上獲得 1547 Elo 分數。
其每項任務成本為 0.94 美元,在完整的智慧指數運行中,輸出 token 數量比 K2.6 減少約 21%。
這次發布立即引發了工程師和模型觀察者的強烈反響,他們將 K3 視為一個可與早期 DeepSeek 時刻相媲美的開源模型里程碑。
官方規格:2.8 兆總參數、100 萬上下文視窗、原生多模態輸入(文字 + 圖像)、文字輸出,並將於 7 月 27 日前開源權重。K3 使用 Kimi Delta Attention (KDA) 技術,月之暗面表示這可以在百萬級上下文視窗中實現高達 6.3 倍的解碼速度。
它還使用了 Attention Residuals (AttnRes),據稱能以不到 2% 的額外成本,提供約 25% 的訓練效率提升。
社群讀者在部落格中強調了額外的架構細節:LatentMoE / Stable LatentMoE,896 個專家中啟用了 16 個,這意味著激活率低於 2%。更多社群從部落格/報告討論中提取的細節包括:per-head Muon、QB 負載平衡 / 分位數負載平衡,以及一種名為 SiTU (Sigmoid Tanh Unit) 的新型激活函數。
一位工程師指出,該架構因結合了 KDA + LatentMoE + AttnRes,並將規模擴大到先前 Kimi 模型的兩倍以上而引人注目。KDA 的孵化週期很長:據報導,設計始於 2025 年 1 月,耗時約 1.5 年才達到前沿規模。
K3 的定價據報導為每 100 萬輸入 token 3 美元,每 100 萬輸出 token 15 美元,快取輸入則享 90% 折扣,降至每 100 萬 token 0.30 美元。幾位發文者將此定價與 Sonnet 5 進行了比較,其中一些人指出 Sonnet 在八月底前暫時更便宜,之後價格將更趨於一致。
根據 80% 輸入 / 20% 輸出的混合估計,K3 的成本為每 100 萬 token 5.40 美元,而 Opus 4.8 為 9 美元,GPT-5.5 為 10 美元。Artificial Analysis 估計,K3 每項智慧指數任務的平均成本為 0.94 美元,而 GPT-5.6 Sol 為 1.04 美元,Opus 4.8 為 1.80 美元。
早期即時服務觀察顯示,透過 OpenRouter 上的 Moonshot API,K3 的速度約為每秒 28 個 token,另一位觀察者則看到每秒 26 個 token。他們稱其比 Opus 慢,並推測可能是預測解碼(speculative decoding)尚未啟用。據報導,月之暗面的部落格建議在配備 64 個以上加速器的超級節點配置上部署,以獲得最佳推論效率。
vLLM 表示,月之暗面直接向 vLLM 貢獻了 KDA 前綴快取(prefix caching)的實作,並在官方發布當天就提供了支援。月之暗面對 KDA 的貢獻被認為很重要,因為 KDA 打破了傳統前綴快取背後的假設,因此需要上游運行時的變更。
月之暗面的官方基準測試訊息,經他人總結,將 K3 定位為在所有測試模型中僅次於 Claude Fable 5 和 GPT-5.6 Sol,並領先於 Claude Opus 4.8。一個被引用的數字是:在 GDPval-AA v2 上獲得 1687 分,高於 Opus 4.8,但落後於 GPT-5.6 Sol 的 1747.8 分。
Artificial Analysis 的獨立數據顯示:AA 智慧指數:57 分;GDPval v2 Elo:1668 分;AutomationBench-AA:53%,排名第一;AA-Briefcase Elo:1547 分。AA-Omniscience 方面,分數提升 18,準確度從 K2.6 的 33% 提升至 46%,但幻覺率卻從 39% 惡化至 51%。
AA 還報告說,K3 在整個智慧指數運行中消耗了 1.32 億個輸出 token,而 K2.6 消耗了 1.66 億個,這意味著在獲得 13 個指數點的同時,輸出減少了 21%。
Arena 的前端結果尤其突出,因為它是一個基於人類偏好的配對競技場,而不僅僅是靜態基準測試,K3 的前端排名第一成為主要發布頭條之一。社群貼文也強調了在核心優化任務上的強勁表現,一些人表示 K3 在某些核心/程式碼生成設定中與 Fable 持平或超越。
ProgramBench 作者 Ofir Press 提出了一項基準測試的注意事項,他表示 Kimi 使用了一種他們不推薦的指標:平均實作百分比,而不是計算完全可運行的程式,這可能會誇大其有用性。
直接來源的事實與聲明:Kimi K3 由月之暗面正式發布。官方披露的規格包括 2.8 兆參數、100 萬上下文視窗、原生多模態輸入、KDA、AttnRes,並將於 7 月 27 日前開源權重。Artificial Analysis 獨立評估 K3 在智慧指數上獲得 57 分,並提供詳細的任務、成本、token 和基準數據。
Arena 獨立將 K3 評為 Frontend Code Arena 第一名,隨後報告其配對勝率為 76%。vLLM 確認月之暗面為 KDA 前綴快取貢獻了運行時支援。
觀點與解讀:「DeepSeek 時刻」、「中美 AI 競賽的開始」和「一切都改變了」是觀察者的編輯解讀,而非既定事實。關於 K3 在 14 個基準測試中「擊敗 GPT-5.6 Sol 11 個」和「擊敗 Fable 6 個」的說法,是社群的綜合摘要,應視為取決於基準測試集和確切方法。
關於這意味著 Dario/Anthropic 的利潤壓力、地緣政治轉捩點或近期超級智慧的斷言,都屬於推測性評論。幾項「蒸餾」的暗示被明確地視為玩笑或猜測,而非證據。
強烈支持者:許多工程師稱 K3 是一個真正的前沿開源模型,特別是因為它似乎比 Opus 4.8 更好,定價接近 Sonnet,並計劃開源權重。支持者強調,這不再只是「對開源有益」,而是與頂級閉源模型具有競爭力。一些人認為這次發布證明開源模型現在距離前沿僅數週或數月之遙。另一些人則認為這大大提高了未來 AGI 級系統開源的可能性。
支持但技術上謹慎者:Artificial Analysis 提出了更為保守的觀點:K3 可與 Opus 4.8 和 GPT-5.5 媲美,但在整體智慧方面仍落後於 Fable 5 和 GPT-5.6 Sol。Simon Willison 形容 K3 意義重大,但也引導讀者關注細微的注意事項和基準測試的警告,而非簡單的排行榜炒作。
Ethan Mollick 的實際體驗是:這是一個非常好的開源權重模型,但還不是 Sol Max 或 Fable。一位使用者表示 K3 的智慧很強,但速度慢,有時過度檢查,並且在品味/美學方面仍落後於 Claude。
批評與懷疑者:Bindu Reddy 警告說,除非在隱藏/未受污染的評估(如 LiveBench)上得到驗證,否則 K3 的基準測試結果可能被誇大,並認為如果模型「思考時間過長」,實際成本可能不那麼有利。ProgramBench 的維護者反對月之暗面的指標選擇,稱其可能會相對於完全可運行的程式,誇大部分正確的性能。
Artificial Analysis 也指出了一個真正的弱點:儘管準確度有所提高,但 AA-Omniscience 上的幻覺率卻出現了退步。多位使用者指出,K3 目前似乎思考很多,保留了冗長的推理歷史,可能需要比簡單的聊天優先 API 更仔細的支援。
一些懷疑集中在經濟和部署能力上:2.8 兆的開源權重令人印象深刻,但實際的自我託管可能仍僅限於資金充足的團隊。
政治與戰略解讀:大量推文將 K3 視為中國實驗室不再遠遠落後、美國領先地位正在縮小的證據。另一些人則反駁說,即使原始能力接近,K3 在可用性/產品化方面似乎仍落後於最頂尖的西方模型。一些人認為,開源的中國模型透過壓縮利潤和商品化能力,對美國實驗室構成了經濟壓力。另一些人則認為,不可避免的下一步將是在工具、產品和部署系統上展開更多競爭,而不僅僅是原始模型權重。
為何這在技術上很重要:K3 不僅因其原始規模而引人注目,更因為它將非標準的注意力堆疊(KDA + AttnRes + 稀疏 MoE)擴展到前沿級別模型。這次發布也是一個系統故事:長上下文服務、前綴快取和 KDA 運行時支援。


