LLM 0.32a0 版:重大向後相容重構
我剛發布了 LLM 0.32a0,這是我的 LLM Python 函式庫與命令列工具的 alpha 版本,用於存取大型語言模型(LLM),其中包含我長期以來一直努力實現的一些具影響力的變革。
LLM 的先前版本以提示詞和回應來建模世界。向模型發送文字提示詞,然後獲得文字回應。
```python
import llm
model = llm.get_model("gpt-5.5")
response = model.prompt("Capital of France?")
print(response.text())
```
這在我於 2023 年 4 月開始開發這個函式庫時是合理的。從那時起,許多事情都發生了變化!
LLM 透過其外掛系統,對數千種不同模型提供抽象層。最初的抽象化,文字輸入返回文字輸出,已無法再代表我所需的一切。
隨著時間的推移,LLM 本身增加了附件功能,以處理圖像、音訊和視訊輸入,然後是支援輸出結構化 JSON 的綱要,接著是執行工具呼叫的工具功能。同時,大型語言模型不斷演進,增加了推理支援以及返回圖像和各種其他有趣功能的能力。
LLM 需要演進,以更好地處理當今前沿模型可以處理的各種輸入和輸出類型。
0.32a0 alpha 版本有兩個關鍵變革:模型輸入可以表示為訊息序列,而模型回應可以由不同類型的部分串流組成。
提示詞作為訊息序列
大型語言模型接受文字作為輸入,但自從 ChatGPT 展示了雙向對話式介面的價值以來,最常見的提示詞方式就是將輸入視為一系列對話回合。
第一個回合可能看起來像這樣:
```
user: Capital of France?
assistant:
```
(然後模型會填寫助理的回覆。)
但隨後的每個回合都需要重播到該點為止的整個對話,就像劇本一樣:
```
user: Capital of France?
assistant: Paris
user: Germany?
assistant:
```
主要供應商的大多數 JSON API 都遵循這種模式。以下是使用 OpenAI 聊天補全 API 的範例,該 API 已被其他供應商廣泛模仿:
```shell
curl https://api.openai.com/v1/chat/completions \
-H "Authorization: Bearer $OPENAI_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "gpt-5.5",
"messages": [
{
"role": "user",
"content": "Capital of France?"
},
{
"role": "assistant",
"content": "Paris"
},
{
"role": "user",
"content": "Germany?"
}
]
}'
```
在 0.32 版本之前,LLM 將這些建模為對話:
```python
model = llm.get_model("gpt-5.5")
conversation = model.conversation()
r1 = conversation.prompt("Capital of France?")
print(r1.text())
Outputs "Paris"
r2 = conversation.prompt("Germany?")
print(r2.text())
Outputs "Berlin"
```
如果您是從頭開始與模型建立對話,這會有效,但它無法提供從一開始就輸入先前對話的方法。這使得建立 OpenAI 聊天補全 API 模擬等任務比應有的難度更高。
llm 命令列工具透過自訂機制使用 SQLite 儲存和還原對話來解決這個問題,但這從未成為 LLM API 的穩定部分,而且在許多情況下,您可能希望使用 Python 函式庫而不必承諾將 SQLite 作為儲存層。
新的 alpha 版本現在支援此功能:
```python
import llm
from llm import user, assistant
model = llm.get_model("gpt-5.5")
response = model.prompt(messages=[
user("Capital of France?"),
assistant("Paris"),
user("Germany?"),
])
print(response.text())
```
llm.user() 和 llm.assistant() 函式是新的建構函式,設計用於 messages=[] 陣列中。
先前的 prompt= 選項仍然有效,但 LLM 會在幕後將其升級為單一項目的訊息陣列。
您現在也可以回覆回應,作為建立對話的替代方案:
```python
response2 = response.reply("How about Hungary?")
print(response2) # Default __str__() calls .text()
```
串流部分
alpha 版本中的另一個主要新介面涉及從提示詞串流回傳結果。
以前,LLM 支援像這樣串流:
```python
response = model.prompt("Generate an SVG of a pelican riding a bicycle")
for chunk in response:
print(chunk, end="")
```
或者這個非同步變體:
```python
import asyncio
import llm
model = llm.get_async_model("gpt-5.5")
response = model.prompt("Generate an SVG of a pelican riding a bicycle")
async def run():
async for chunk in response:
print(chunk, end="", flush=True)
asyncio.run(run())
```
當今許多模型會返回混合類型的內容。針對 Claude 執行的提示詞可能會返回推理輸出、然後是文字、然後是工具呼叫的 JSON 請求、然後是更多文字內容。
有些模型甚至可以在伺服器端執行工具,例如 OpenAI 的程式碼解釋器工具或 Anthropic 的網路搜尋。這意味著模型的結果可以結合文字、工具呼叫、工具輸出和其他格式。
多模態輸出模型也開始出現,它們可以將圖像甚至音訊片段混合到串流回應中。
新的 LLM alpha 版本將這些建模為帶有類型的訊息部分串流。以下是作為 Python API 消費者時的樣子:
```python
import asyncio
import llm
model = llm.get_model("gpt-5.5")
prompt = "invent 3 cool dogs, first talk about your motivations"
def describe_dog(name: str, bio: str) -> str:
"""Record the name and biography of a hypothetical dog."""
return f"{name}: {bio}"
def sync_example():
response = model.prompt(
prompt,
tools=[describe_dog],
)
for event in response.stream_events():
if event.type == "text":
print(event.chunk, end="", flush=True)
elif event.type == "tool_call_name":
print(f"\n Tool call: {event.chunk}(", end="", flush=True)
elif event.type == "tool_call_args":
print(event.chunk, end="", flush=True)
async def async_example():
model = llm.get_async_model("gpt-5.5")
response = model.prompt(
prompt,
tools=[describe_dog],
)
async for event in response.astream_events():
if event.type == "text":
print(event.chunk, end="", flush=True)
elif event.type == "tool_call_name":
print(f"\n Tool call: {event.chunk}(", end="", flush=True)
elif event.type == "tool_call_args":
print(event.chunk, end="", flush=True)
sync_example()
asyncio.run(async_example())
```
範例輸出(僅來自第一個同步範例):
> 我的動機:創造三隻令人難忘的酷狗,具有獨特的「酷」風格,一隻電影風、一隻冒險風、一隻迷人混亂風,讓每隻狗都感覺牠們可以成為自己故事的主角。
>
> 工具呼叫:describe_dog({"name": "Nova Jetpaw", "bio": "一隻時尚的銀灰色惠比特犬,戴著迷你飛行員護目鏡,喜歡沿著月光海灘衝刺。Nova 無所畏懼、優雅,據說為了好玩而跑贏無人機。"}
>
> 工具呼叫:describe_dog({"name": "Mochi Thunderbark", "bio": "一隻毛茸茸的柯基犬,戴著戲劇性的黑金頭巾,擁有搖滾明星般的自信。Mochi 矮小、吵鬧、忠誠,並領導著一個完全由松鼠組成的社區「安全巡邏隊」。"}
>
> 工具呼叫:describe_dog({"name": "Atlas Snowfang", "bio": "一隻巨大的白色哈士奇,有著冰藍色的眼睛和一個裝滿零食的背包。Atlas 沉穩、英勇,並且總能知道回家的路,即使在暴風雪、濃霧或令人困惑的露營旅行中也是如此。"}
在回應結束時,您可以呼叫 response.execute_tool_calls() 來實際執行所請求的函式,或者發送 response.reply() 以呼叫這些工具並將其返回值發送回模型:
```python
print(response.reply("Tell me about the dogs"))
```
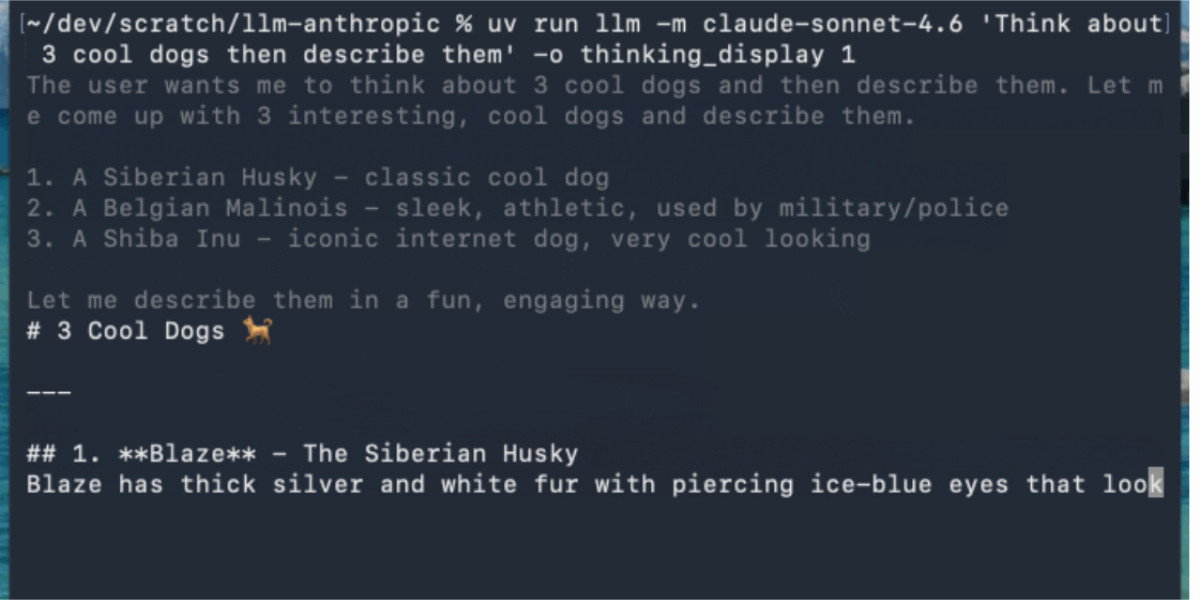
這種串流不同 token 類型的新機制意味著命令列工具現在可以用與最終回應中的文字不同的顏色顯示「思考」文字。思考文字會輸出到標準錯誤輸出(stderr),因此不會影響管道到其他工具的結果。
這個範例使用 Claude Sonnet 4.6(搭配更新了串流事件版本的 llm-anthropic 外掛),因為 Anthropic 的模型會將其推理文字作為回應的一部分返回:
```shell
llm -m claude-sonnet-4.6 'Think about 3 cool dogs then describe them' \
-o thinking_display 1
```
您可以使用新的 -R/--no-reasoning 旗標來抑制推理 token 的輸出。令人驚訝的是,這最終成為此版本中唯一面向命令列的變更。
序列化和反序列化回應的機制
如前所述,LLM 目前用於將對話儲存到 SQLite 的程式碼相當不靈活。我在 0.32a0 中增加了一種新機制,應該能為 Python API 使用者提供一種自行替代的方法:
```python
serializable = response.to_dict()
serializable 是一個 JSON 格式的字典
將其儲存到任何您喜歡的地方,然後還原它:
response = Response.from_dict(serializable)
```
這個函式返回的字典實際上是在新的 llm/serialization.py 模組中定義的 TypedDict。
接下來是什麼?
我將其作為 alpha 版本發布,以便我可以升級各種外掛並在實際環境中測試新設計幾天。我預計穩定的 0.32 版本將與此 alpha 版本非常相似,除非 alpha 測試揭示了我將所有這些組合在一起的方式存在一些設計缺陷。
還剩下一個大型任務:我希望重新設計 SQLite 記錄系統,以更好地捕捉這個新抽象層返回的更細粒度細節。
理想情況下,我希望將其建模為圖形,以最好地支援像 OpenAI 風格的聊天補全 API 這樣的情況,其中相同的對話不斷擴展,然後在每個提示詞中重複。我希望能夠儲存這些對話而不會在資料庫中重複它們。
我尚未決定這應該是 0.32 版本的功能,還是應該保留到 0.33 版本。


