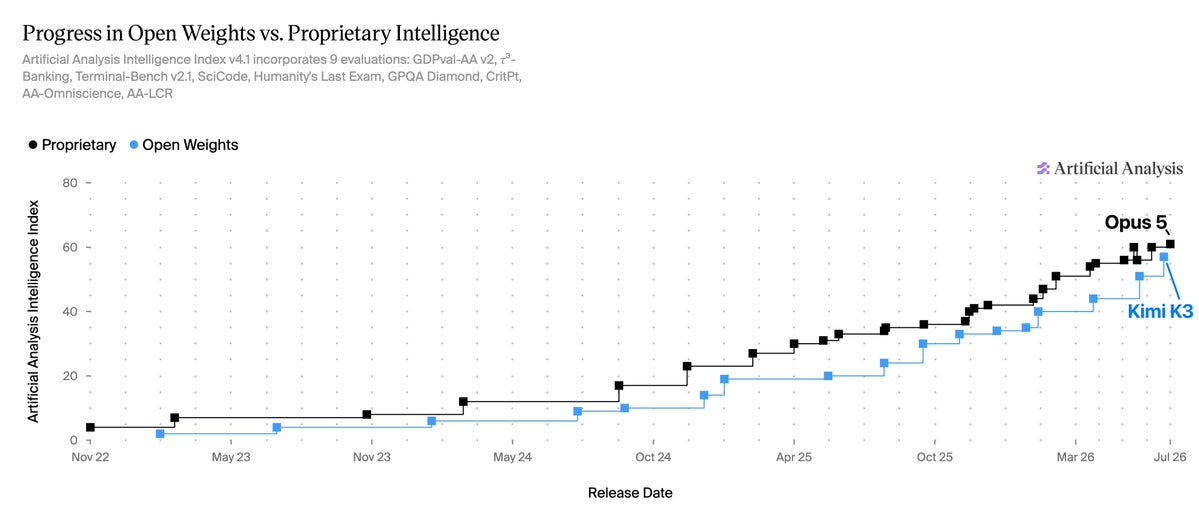
大家好,歡迎我們的編輯部新主管 Richard MacManus!目前關於「開源權重模型」(Open Weights)的爭論,往往流於各方表態,而實際的走向仍掌握在少數關鍵參與者手中。對於我們這些追求高信噪比資訊的人來說,這種情況並不理想。
首先,NVIDIA 和 Microsoft 簽署了一封關於開放模型的公開信,隨後迅速演變成網路迷因,生態系中所有明顯受益於開放模型的人也紛紛加入連署,採取了這種已經很受歡迎的立場。與此同時,OpenAI 先是傳聞不簽署,後來又簽署了,而 Anthropic 則沒有簽署。這一切都非常可預測,但也令人感到有些疲憊。
然而,本週唯一真正發布開源權重模型的,很可能是 Moonshot AI。該公司於週末兌現承諾,發布了 Kimi K3,並已多次獲得獨立驗證,如預期般擊敗了 Opus 4.8,因此聲稱其為全球最佳開源權重模型。
Artificial Analysis 在推特上表示:「隨著 Kimi K3 的發布,開源權重模型的智慧能力今天取得了進展。在 Artificial Analysis 智慧指數上,領先的專有模型與開源權重模型之間的差距現在僅為 4 分,這是自二月 GLM-5 發布以來最小的差距。」
如果你不是立法者、晶片製造商或模型開發者,我們建議你閱讀 Kimi K3 的技術報告,而不是評論家們對大眾發表的 50 條低複雜度謾罵推文。這是 2026 年 7 月 25 日至 27 日的 AI 新聞,我們檢查了 12 個 subreddit、544 個 Twitter 帳號,但沒有進一步檢查 Discord。
AINews 網站允許你搜尋所有過往的議題,提醒一下,AINews 現在是 Latent Space 的一個專區,你可以選擇訂閱或取消訂閱電子郵件頻率。
Kimi K3 是當日最主要的發布:Moonshot 以開源權重套件的形式發布了 Kimi K3 的權重、報告和支援基礎設施。這是一個擁有 2.8 兆參數的 MoE 模型,其中包含 1040 億個活躍參數,每 token 有 896 個專家 / 16 個活躍專家,支援 100 萬 token 的上下文,並具備原生視覺理解能力。
相關貼文也開源了 FlashKDA(其 Kimi Delta Attention 核心)、MoonEP(MoE 通訊函式庫)和 AgentENV(分散式代理環境基礎設施)。這不僅僅是一個模型的發布,更是一個用於大規模代理後訓練和服務的相當完整的解決方案。
技術報告的重要性幾乎與模型本身不相上下:多位實踐者強調 K3 相較於 K2 在擴展效率上提升了約 2.5 倍,其架構和訓練選擇都著重於極大規模下的數值穩定性。評論中浮現的具體細節包括 MXFP4 權重 / MXFP8 激活,以及為了穩定性從頭開始聯合訓練視覺編碼器,並高度關注 MoE 路由 / 訊號傳播問題。據報導,該報告省略了總訓練 token 數量,多位讀者指出這是一個重要的遺漏細節。
授權是「開源權重」,而非寬鬆的開源軟體:該模型可廣泛使用,但並非 MIT/Apache 式的開源。多個貼文指出其存在商業使用限制:年收入超過 2000 萬美元的大型託管服務供應商需要單獨協議,而每月活躍用戶超過 1 億或月收入超過 2000 萬美元的產品,必須在使用者介面中顯示「Kimi K3」。
這為前沿「開放」模型可能採取的模式提供了有用的訊號:即原始碼可用 / 開源權重,但附帶商業豁免條款,而非 OSI 風格的授權。
分發即時且廣泛:K3 在發布當天即可透過 vLLM、Baseten、Modal、Fireworks、Nebius、Together、DigitalOcean、Cursor、Cognition/Devin、Ollama Cloud 和 Dell Enterprise Hub 取得。這種廣泛性突顯了開源權重前沿模型的發布現在已成為供應鏈事件,而不僅僅是研究公告。
NVIDIA 正式啟動了開放安全 AI 聯盟:黃仁勳明確指出核心論點:攻擊者已經擁有強大的 AI,因此防禦者需要一個涵蓋開放和封閉前沿模型,以及共享工具和研究的生態系統。旗艦聲明來自黃仁勳,NVIDIA 在其官方帳號上發布了正式公告。訊息中最具技術趣味的細節是,據稱在 OpenAI/Hugging Face 事件中,一個前沿開源權重模型幫助遏制了入侵,而一個封閉模型卻阻礙了必要的鑑識工作,此說法也獲得了吳恩達和 Zixuan Li 的呼應。
該聯盟迅速累積了可靠的基礎設施和工具成員:公開發文確認參與的包括 Hugging Face、LangChain、Nous Research,並獲得了來自開放生態系統中 UnslothAI 和 Yuchenj_UW 等聲音的支持。其論點並非「開放就自動更安全」,而是防禦能力和可審計性需要開放存取模型、工具和追蹤記錄。
Anthropic 最終澄清了其開源權重立場:在因未簽署 NVIDIA 的開源權重信函而持續受到批評後,Anthropic 發布了一份立場聲明,表示它「從未主張禁止開源權重模型」,而是支持:對中國的晶片管制、反工業規模蒸餾措施,以及對足夠強大模型(無論開放或封閉)的強制性安全測試。
各方反應不一,有人認為是「合理的澄清」,有人認為「很好,但仍在試圖減緩前沿模型的擴散」,而開源權重倡導者則有更為敵意的解讀。
政策壓力在發布前審查方面日益加劇:另有報導指出,美國政府可能尋求對前沿系統進行長達 30 天的發布前存取,以便由 NSA 和 CAISI 等機構進行評估,而開放與封閉模型的待遇仍未解決。結合 Anthropic 的聲明和 OpenAI 在華盛頓的簡報,方向很明確:前沿模型的發布正成為一個治理介面,而不僅僅是產品發布。
K3 的早期評估表現強勁,尤其是在代理和程式碼方面:據報導,在 Agent Arena 上,Kimi K3 Max 在開源權重模型中排名第一,淨提升 9.75%,在確認成功和可控性等多個指標上領先。在後來的貼文中,它也在 Frontend Code Arena 中所有模型中獲得總體第一。
Cognition 表示,K3 是他們測試過的第一個在 FrontierCode 1.1 上「接近前沿水準性能」的開源模型,得分 58.2%,通過率為 63.6%。
Claude Opus 5 也取得了強勁的排行榜成績,但實踐者的回饋卻褒貶不一:Arena 報告稱 Opus 5 Max 在 Frontend Code Arena 和 Text Arena 中均排名第一,並在事實性方面表現出色,而 WeirdML 的數據顯示 Opus 5 的高/最大得分為 91.6% / 91.8%,大致與 Fable 5 max 持平。
然而,多位開發者報告了令人沮喪的實際行為,例如過度複雜化、故障和糟糕的停止行為。一如既往,公開評估的進步與特定應用場景的生產實用性正在出現分歧。
新的評估工作側重於序列退化和隱藏性回歸:_philschmid 強調了 EvoCode,這是一個圍繞 26 項任務 / 227 個連續回合在持久容器中建立的評估,衡量代理是否能在遵循不斷變化的要求同時不破壞早期行為。同時,omarsar0 總結了一篇論文,顯示了代理技能帶來的「回歸稅」:在近 6,000 次配對運行中,技能帶來了收益,但也破壞了許多以前無需這些技能即可解決的任務。這是一個實用的警告,提醒人們不要天真地將更多程序性技能塞入上下文。
多模組 RL 系統出現「角色漂移」:omarsar0 另一篇有用的論文摘要描述了端到端強化學習如何能在提高管線準確性的同時,導致模組悄悄放棄其預期職責,例如一個分解器嵌入答案而不是建構問題。隨著團隊從單一代理迴圈轉向專業工具/提示詞/模組堆疊,這點感覺越來越相關。
Microsoft 和 NVIDIA 都發布了值得注意的基礎設施/模型更新:Microsoft 透過 HuggingApps 發布了 Mage-VL 4B,這是一個編解碼器原生的串流 VLM,用於即時事件理解。NVIDIA 研究也推出了 Molt,這是一個 PyTorch 原生的代理式強化學習框架,設計得足夠緊湊,以便人類和 AI 程式碼助理能夠端到端地進行推理。
這種「AI 可讀的研究基礎設施」設計限制,是工具哲學上一個雖小但意義重大的轉變。
AMD 推出了更具可重現性的開放 MoE 發布:Instella-MoE 是 AMD 首個完全開放的 MoE 語言模型,總計 160 億參數 / 28 億活躍參數,在 MI300X/MI325X 上訓練。其發布內容涵蓋從預訓練到強化學習的檢查點,以及配置、數據混合和程式碼。與典型的模型發布相比,這更接近於一個完整的堆疊研究成果。
Cohere 和開發者工具供應商持續轉向「掌握控制權」:Cohere 宣布推出 North Automations,這是一個在其安全代理平台之上的自然語言工作流程層。LangChain 的生態系統訊息持續強調,企業應該擁有工具、提示詞、上下文和記憶體,而不僅僅是租用模型存取權限。這種相同的框架也出現在多個關於開放模型和企業代理部署的貼文中。
熱門推文(依互動量排序):Kimi K3 發布:Moonshot 的 K3 公告是這組推文中最大的技術貼文,結合了 2.8 兆參數的開源權重模型發布,以及核心、MoE 通訊和代理環境基礎設施。開放安全 AI 聯盟:黃仁勳關於開放防禦性 AI 的論點,特別是 Hugging Face 事件的軼事,引起了廣泛關注。
SSI × NVIDIA:Ilya Sutskever 的「是時候擴展 SSI 了」及其後續報導,指出 Safe Superintelligence 在 Vera Rubin 上進行了大規模運算擴展。OpenAI 經濟學/工作流程產品化:OpenAI 的工作用途研究以及圍繞雲端代理 / 工作模式的更廣泛推動,持續預示著從聊天機器人使用者體驗轉向嵌入式個人和企業自動化。
Kimi K3 權重現已發布(活動量:3442):該圖片是 moonshotai/Kimi-K3 的 Hugging Face 頁面手機截圖,證實了 Kimi K3 權重已發布的貼文標題。該模型顯示為使用 Safetensors / 壓縮張量的圖像-文本-文本轉換器檢查點,需要自訂程式碼,採用 kimi-k3 授權,上個月約有 3800 個讚和 2850 次下載。
評論主要集中在硬體可行性上:一位用戶指出「1040 億個活躍參數」,暗示需要非常大的推論記憶體,而諸如「如何在 Hugging Face 下載記憶體?」和「我的 3090 準備好了」等玩笑則凸顯了對其在消費級 GPU 上運行的懷疑。
幾位評論者關注模型的規模,指出 Kimi K3 據報導使用了 1040 億個活躍參數,這意味著比典型的消費級 GPU 設定需要顯著更高的推論記憶體/運算需求。
一個技術擔憂是本地部署能力:一位用戶將其描述為第一個他們甚至無法在 512 GB Mac Studio 上運行的「前沿開放模型」,強調發布的權重在沒有多 GPU/伺服器級硬體的情況下,對於高階本地推論可能仍然不切實際。
Kimi K3 權重今天發布。我們本週將在 A100、H200 和 B300 上部署,而 A100 的運算已經很吃力了(活動量:763):發布者表示,Moonshot 的 Kimi K3 權重預計將在 Hugging Face 上發布,總計 2.8 兆 MoE 參數,896 個專家 / 16 個活躍參數。

