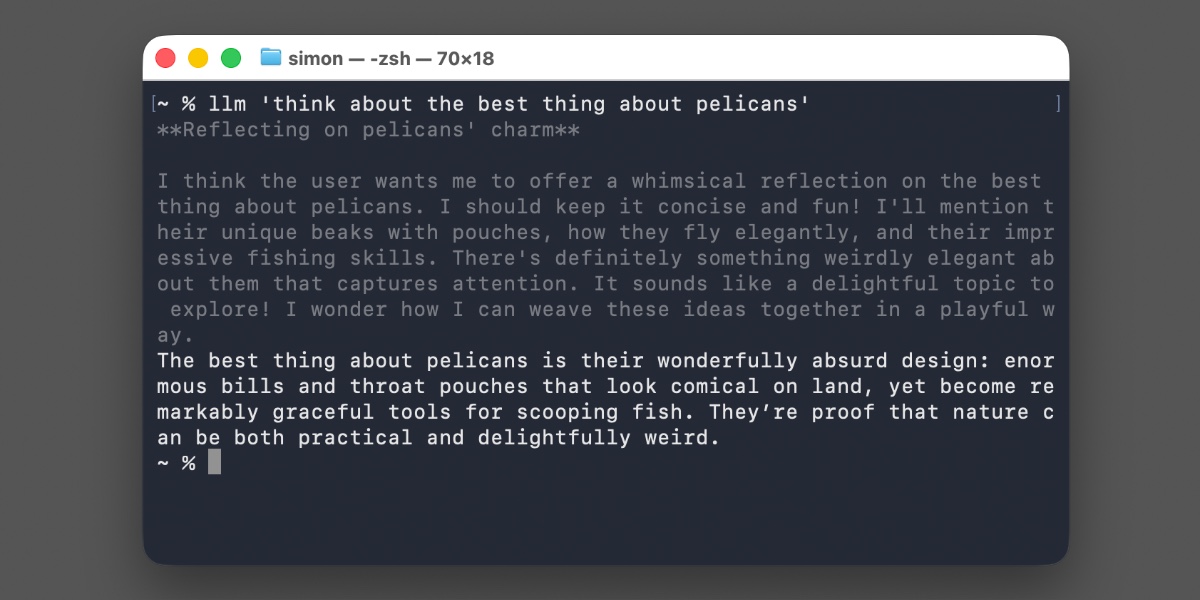
今天早上我發布了 LLM 0.32 版,這是該專案自首次推出以來最重要的新版本。新版本支援可見的推理追蹤、伺服器端供應商工具、重新設計的內容定址 SQLite 日誌、新模型,以及由 OpenAI Responses API 啟用的新功能。同時,我也發布了 llm-anthropic 插件的新版本,該版本本身也進行了大幅更新。
\n\n對推理模型執行 LLM 時,現在會將其推理追蹤顯示到標準錯誤輸出,讓您可以看到模型「思考」的過程。這些資訊不會包含在標準輸出中,因此不會干擾您將輸出導向其他工具。若要關閉此功能,請新增 -R 或 --hide-reasoning 參數。
\n\nLLM 現在原生支援 GPT-5.6 模型家族,而 llm "prompt" 指令預設使用的模型,也已改為經濟實惠但功能強大的 GPT-5.6 Luna。此外,LLM 呼叫現在可以使用來自不同供應商的伺服器端工具。\n\nOpenAI 提供了一個程式碼執行環境作為伺服器端工具;LLM 現在可以執行利用此功能的提示詞,例如:llm --tool CodeInterpreter 'Show current python and SQLite versions'。
OpenAI 也新增了 WebSearch 工具。\n\nllm-anthropic 插件新增了 WebSearch、WebFetch、CodeExecution 和 AnthropicMCP 等工具,其用法如下:llm -m claude-sonnet-5 -T 'AnthropicMCP("https://datasette.simonwillison.net/-/mcp")' 'how many rows in the blog_blogmark table?'。
這使得 Anthropic 能夠在與其 API 的單次請求/回應互動中,對我新的 datasette-mcp 插件執行 MCP 呼叫。\n\n新的 llm openai endpoint 指令提供了一個工具,可以一行程式碼對任何與 OpenAI 相容的端點執行提示詞。
這些呼叫不會被記錄,使其成為對任何支援 LLM API 通用語言的服務執行一次性提示詞的便捷工具。\n\n以下是我如何使用它來對本機 LM Studio API 中運行的 Gemma 4 12B 執行提示詞,透過 uvx(無需安裝 LLM)並結合 llm-tools-quickjs 工具插件:uvx --with llm-tools-quickjs llm openai endpoint http://localhost:1234/v1 -m google/gemma-4-12b -T QuickJS 'Use QuickJS to multiply 3434 * 2434' --td。
\n\nLLM 的 Python API 以前要求您先建立一個對話,然後一次傳送一條訊息。這是一種對 LLM 本質的抽象,因為每個請求都攜帶著之前所有訊息的完整歷史。這種抽象在某些更進階的應用中開始造成阻礙,因此新版本引入了 model.prompt(messages=[]) 參數,其用法如下:\n\nimport llm\nfrom llm import user, assistant, system\n\nmodel = llm.get_model("gpt-5.6-luna")\n\nresponse = model.prompt(messages=[\n system("You are a helpful pirate."),\n user("What is the capital of France?"),\n assistant("Paris, matey."),\n user("And Germany?"),\n])\nprint(response.text())\n\nLLM 以前從每個提示詞返回一個可迭代的字串序列。
當模型只返回字串回應時,這運作良好,但未能預測模型將演變出的奇特形式。如今,許多模型會返回推理文本、輸出字串、工具呼叫,甚至圖像附件的混合內容。透過 LLM 0.32,您可以改用以下方式處理:\n\nfor event in model.prompt("Explain cats").stream_events():\n if event.type == "reasoning":\n print(f"[thinking] {event.chunk}", end="", flush=True)\n elif event.type == "text":\n print(event.chunk, end="", flush=True)\n else:\n print(f"Other event: {event}")\n\n結合這些功能,我們終於可以提供一個穩健的半標準 OpenAI 聊天補全 API 實作,我已將其作為 llm-chat-completions-server 插件發布。
您可以透過 llm install llm-chat-completions-server 安裝,並使用 llm chat-completions-server --port 9000 啟動伺服器。現在,您可以使用新的 llm openai endpoint 指令,透過該伺服器對 LLM 執行提示詞,例如:llm openai endpoint http://127.0.0.1:9000/v1 'hello' -m gpt-5.4-mini。
\n\n這類 API 面臨的更大挑戰是日誌記錄。如果我們要支援每次請求都附加訊息序列的模式,理想情況下,我們應該避免為每個回合記錄所有重複的 JSON。解決方案是新的內容定址訊息儲存,其設計靈感來自 Git。您可以在文件中查看其新架構,而 llm logs 和 llm logs --json 指令都已升級,可將該格式轉換回易於使用的內容。
\n\n此版本還有更多內容。0.32 版的發布說明相當全面,而 0.32rc2、0.32rc、0.32a3、0.32a2 和 0.32a0 的說明應該能補足任何遺漏。現有的 LLM 插件應能繼續運作,但提供額外模型的插件需要升級到 0.32 版,才能完全參與新的串流事件系統。
文件中提供了使用結構化訊息和串流事件實作插件的指南。\n\n我也更新了一些自己的插件:llm-anthropic 0.26 版新增了對 Claude 5 系列模型的支援,以及 WebSearch、WebFetch、CodeExecution 和 AnthropicMCP 等伺服器端工具。
llm-gemini、llm-openrouter 和 llm-mistral 也即將發布新版本。\n\n此版本中許多底層工具的變更,都是由 Datasette Agent 的需求所驅動。當我開始開發 LLM 時,「代理(agent)」這個詞的定義非常模糊,所以我拒絕使用它。
直到 2025 年 9 月,我才接受「LLM 代理會循環執行工具以達成目標」這個定義已足夠明確,讓我不再完全迴避這個詞。\n\n工具鏈現在可以暫停以等待人工審核,並從儲存的訊息歷史中恢復執行,這兩項都是 Datasette Agent 所需的功能。
從今天的 LLM 來看,它在我眼中已經越來越像一個代理框架了。\n\n擁有一個 CLI 工具,能夠以一行指令混合搭配來自不同來源、不同模型的工具,並且包含一個強大的 Python 函式庫,足以建構 Datasette Agent 和 llm-coding-agent 等系統,這真是太棒了。
或許 LLM 的下一個版本會將「代理」的概念融入核心函式庫中。我仍在思考那會是什麼樣子。


