編輯註:我很高興歡迎 Shlok 加入我們的客座文章陣容!您可能從他對領先 AI 實驗室記憶系統的精彩探索中認識他(作為外部人士,內部觀點請參閱我們與 OpenAI 的 Akshay Nathan 的播客,這已是今年最受歡迎的節目之一)。
我們自 2023 年的 Plugins、2024 年的 Devday 和 2025 年的 Codex 以來,一直報導 OpenAI 向全人類部署代理人的研究與發展,而現在 2026 年的 ChatGPT Work 似乎是這漫長旅程的倒數第二個階段。讓我們深入探討吧!
7 月 9 日,OpenAI 發布了 ChatGPT Work,這是一款針對知識工作的代理人產品。無論從哪個角度來看,這都是一次繁忙的發布:它推出了橫跨十四種配置的三個新模型,整合了 ChatGPT 和 Codex 桌面應用程式,並以迄今為止最易於使用的方式將雲端代理人帶入主流。
據報導,推出三週後,Work(連同 Codex)的用戶數已突破 1,000 萬。
編輯註:ChatGPT 預計在六月突破 10 億月活躍用戶(MAU),本月則將突破 10 億週活躍用戶(WAU)。
目前,ChatGPT 內部將 Chat 和 Work 作為獨立模式並存,但 Greg Brockman 已證實它們將在年底前合併。因此,Work 不僅僅是針對進階用戶的利基產品,更是預示了 ChatGPT 數十億週活躍用戶未來將如何使用這個應用程式。這也是 OpenAI 內外人士對其如此興奮的原因,也值得我們深入探討。
Work 目前的形式需要一些解讀。它是 ChatGPT(以聊天形式)、Codex 應用程式、Codex 框架、原始雲端代理人 Codex、ChatGPT 代理人、Atlas、OpenClaw 等多種產品的融合。
圍繞它的產品線令人困惑。而且網頁版和行動版與桌面版有所不同(除非您在雲端模式下運行它?!)。
因此,我過去幾天一直在嘗試解讀它:Work 是什麼,它在 OpenAI 產品線中的定位,其設計中許多有趣的選擇,其底層的張力,以及我認為它將走向何方。
以下大部分內容來自 Codex 和我在 Work 內部摸索的結果,我已在文中連結了這些對話,以便您查看每個說法的來源。
其核心功能:它是一個用於知識工作的代理人。您可以將它連接到您已在使用的各種工作平台,Slack、電子郵件、Drive、行事曆、CRM、專案追蹤器以及數百個其他外掛程式。
它會從所有這些平台中收集上下文,以產生完成的工作成果。
它運行在 Codex 框架上,因此繼承了相同的模型、子代理人、瀏覽器使用功能,以及長時間處理任務的能力。
其使用者介面移除了會洩漏您正在與程式碼代理人對話的證據(例如 Git 控制、差異追蹤)。
它存在於雲端電腦中。具體來說,是一個強大且隔離的微型虛擬機(microVM):專業版帳戶獲得 8 個 CPU、20GB 記憶體和 64GB 磁碟;Plus 版則獲得 14GB 記憶體。
除了虛擬機之外,Work 還獲得一個受管理的 Chrome 服務,代理人透過工具呼叫來操作。
它能產生各種成果。包括在互動式檢視器中呈現的試算表、文件和簡報,以及 Sites:它能建立、透過 URL 分享並保持更新的託管式網路應用程式和儀表板。
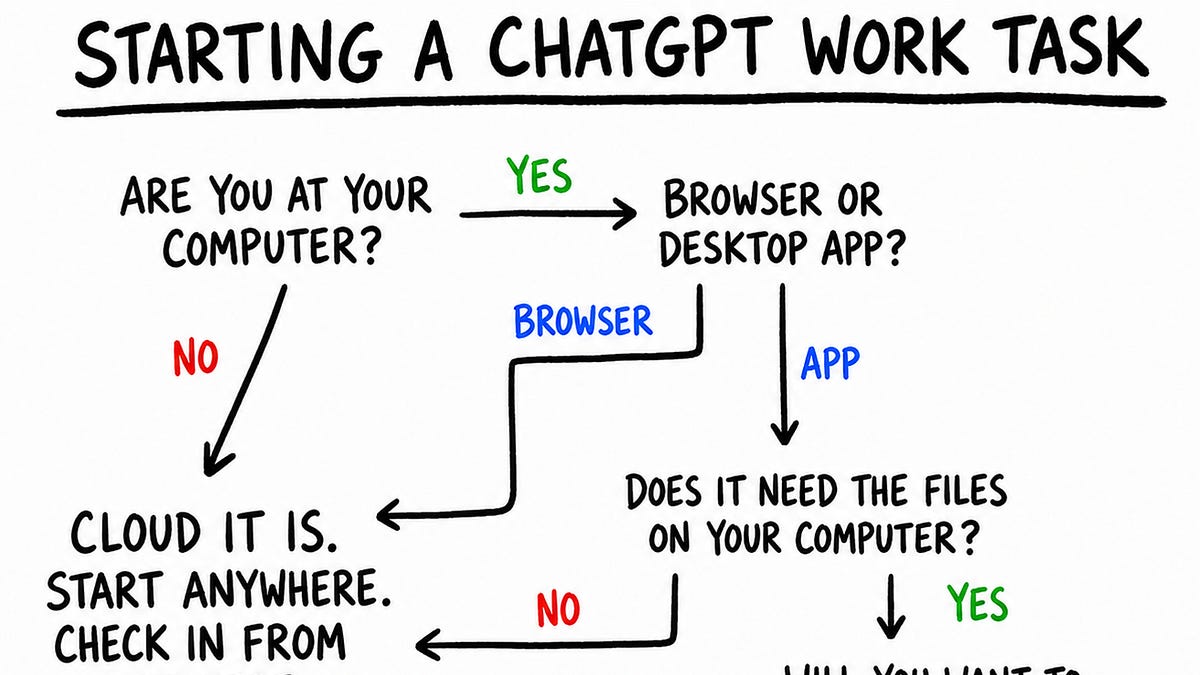
在 Work 中,每個新的對話都稱為一個任務。在網頁版和行動版上,Work 運行在雲端。
您可以在網頁上啟動一個任務,在手機上的 ChatGPT 應用程式中追蹤進度並給予指示,然後在筆記型電腦上查看結果(可能是報告或試算表)。
桌面應用程式上的 Work 略有不同,分為兩種模式:雲端模式和本機模式。
在雲端模式下,任務運行在與網頁版和行動版相同的雲端電腦上,並在三者之間同步。
在本機模式下,代理人直接在您的機器上工作,跨越您的檔案和應用程式,並具有完整的電腦使用權限。這些任務不會出現在網頁版或行動版上,目前也無法將本機任務移動到雲端。
這使得本機模式本質上就是 Codex,只是移除了會嚇跑非開發人員的程式碼相關使用者介面痕跡。
在桌面版上,每個新的 Work 任務都可以在您的電腦上本機運行或在雲端運行。
但接下來事情就變得有點混亂了。OpenAI 確實發布了一種將 Codex 任務轉交給遠端環境的方式。儘管在我撰寫本文時這對我不起作用,但我假設它最終會實現,並且他們會將相同的功能帶到 Work 中。
本文的其餘部分,Work = 雲端模式下的 Work。
OpenClaw 與聊天機器人感覺不同的主要原因之一是代理人擁有自己的電腦。您可以讓它在始終開啟的筆記型電腦或 VPS 上運行,讓它建立目錄、安裝軟體、維護資料庫,並在對話和子代理人之間重複使用所有這些功能。
它的狀態不僅存在於聊天歷史、Markdown 檔案或專用記憶體系統中,而是存在於整個電腦中。
Work 的雲端電腦也是持久的。但它並非運行在一個永遠開啟的虛擬機中,而是將其工作空間同步到持久儲存,並在需要時恢復到隔離的微型虛擬機上。
因此,底層機器可以改變,但工作狀態會延續。然而,與 OpenClaw 相比,代理人對這台電腦的主權要小得多。
每個 Work 任務(執行緒)都會在 /workspace/scratch 下獲得一個工作目錄,代理人在其中擁有普通電腦的自由:它可以建立資料夾、安裝依賴項、編寫腳本、維護資料庫,並使用普通的 Linux 命令搜尋所有內容。
當我要求它為 Acme 製作簡報時,它可以在目錄中建立 clients/acme 資料夾,複製原始資料,透過程式碼執行一些分析,並建立圖表和投影片,所有這些都作為檔案存在。
當我在同一個執行緒中追蹤時,它會返回該工作狀態並可以繼續編輯它。
但是,當一個任務需要來自其他執行緒的上下文時,它不會將它們的工作目錄視為可以自由導航的共享工作空間。它反而依賴於 ChatGPT 產品層。
預設情況下,每個新的執行緒都會收到最近任務和已處理檔案的壓縮摘要。摘要可能看起來像這樣:
20260731T15:55 準備 Acme 試點計畫:||||將附加筆記轉化為一份 Acme 試點的一頁計畫,包含目標、截止日期和後續步驟。<<檔案名稱=”acme_notes.txt”>>
原始對話記錄不會儲存在電腦上供代理人瀏覽。當任務需要來自先前執行緒的上下文時,代理人會呼叫「個人上下文」(Personal Context),這是一個專用工具,透過獨立管理的服務查詢 Chat 和 Work 的歷史記錄,並返回相關的摘錄。
檔案遵循相同的模式。ChatGPT 的「圖書館」(Library)是所有檔案和成果的中央用戶端儲存庫。用戶上傳的檔案會自動存入;代理人建立的檔案則在用戶要求或代理人判斷值得保留時儲存。
代理人還可以在「圖書館」中建立目錄以保持其組織性。與對話一樣,「圖書館」也不存在於電腦上,只能透過專用工具存取。
因此,上傳的檔案存在於兩個地方:執行緒內的工作副本和「圖書館」中的標準項目。有趣的是,兩者不同步。
如果執行緒 A 上傳了一個檔案,而執行緒 B 隨後更改了「圖書館」版本,執行緒 A 在恢復時仍會讀取其現在已過時的本機副本。
當明確指示時,一個任務中的代理人可以導航到其他任務的暫存目錄,尋找檔案並修改它們。但它不會自行這樣做,而且這些目錄名稱不透明,沒有清晰的對話映射,也沒有明確的保留合約。
記憶體也由外部管理。正如我之前所寫,ChatGPT 的核心記憶體原語是運行中的、合成的用戶個人資料。
產品會非同步地維護它,並在任務開始時提供給 Work。代理人可以從中進行推理,但無法修改它或建立其他任務預設載入的 OpenClaw 風格 Markdown 檔案。
ChatGPT 的「專案」(Projects)功能也延續到 Work 中。「專案」將相關對話、常規指令和來源(用戶上傳的檔案)分組。
專案內的新任務會在其目錄中接收其指令、相關對話的摘要以及來源的本機副本。但「專案」本身不像在 Codex 中那樣以目錄形式存在於電腦上。它也是產品維護的一個抽象概念。
簡而言之,代理人在單一任務中擁有廣泛的自由,但跨任務的連續性是透過一個有主見的 ChatGPT 產品層實現的,而不是電腦本身。為什麼要這樣劃分?我猜有幾個原因:
Work 建立在現有的 ChatGPT 原語(對話、圖書館、個人上下文、記憶體)之上。如果將所有這些功能移除並在電腦內部重建,將意味著重構一個已經服務數十億用戶的技術堆疊。
這種分離是一種安全防護措施。OpenClaw 式的對單一環境(包含所有檔案、對話和記憶體)的無限制存取對用戶來說是不安全的。
它讓 OpenAI 能夠保持對產品的控制:用戶在使用者介面中看到什麼、如何管理上下文,以及共享、跨裝置同步和檔案版本控制如何運作。如果代理人可以隨意更改環境,所有這些都將更難以實現。
Work 今天所缺乏的是一個元層代理人,它在個別任務和專案之上運作並在它們之間進行協調。(有些人已經這樣使用 Codex 了。)
或許這將會到來,以及許多其他功能。Work 仍處於早期階段,其架構在幾週後可能會大不相同。
今天的 AI 產品仍然是被動的。在模型能夠提供幫助之前,您必須注意到有事情需要完成,收集相關上下文,並將所有這些轉化為提示詞。
代理人可以從那裡做得非常出色,但最初的代理行為仍然是您的。主動性,即代理人自行找出如何提供幫助,是個人 AI 的聖杯之一。
Work 提供了這方面的一個早期預覽。當您開啟一個新的 Work 對話時,除了撰寫器之外,您還會收到根據您自己的上下文生成的個人化任務建議。
其中一個建議是為我即將到來的通話做準備。當我選擇它時,Work 注入了一個預先編寫的提示詞。
它非同步地根據我的上下文進行推理:注意到行事曆事件,推斷準備會有幫助,從行事曆和 Gmail 中提取資料,並根據我記憶中的興趣和偏好構建了一個任務。當我發送提示詞後,它便開始工作,結果是一份很棒的會議簡報,一份我甚至不知道自己需要的簡報!
今天,Work 邁出了可靠的第一步:它建議任務。但在我執行它們之前,什麼都不會發生。
為了實現真正的主動性,它必須在沒有我參與的情況下,完成它預測我想要完成的任務。那個未來似乎不遠了。
自動化功能讓 Work 可以在未來某個時間或按重複排程運行任務,而無需用戶手動提示。它們是 ChatGPT 對提醒和排程任務(cron jobs)的抽象。
OpenAI 在 2025 年 1 月將它們作為「排程任務」(Scheduled Tasks)推出。Work 建立在相同的排程器上,但使其更具代理人特性:每次運行都可以使用代理人的上下文和工具來完成任務。
它們分為兩種。獨立的排程任務每次運行都從保存的提示詞開始,並為結果開啟一個新的任務。它適用於獨立的工作:一次性提醒、每日簡報、每週求職、例行電子郵件掃描。
現有對話中的排程任務,由「心跳」(heartbeat)觸發,會喚醒該任務並保持其上下文完整。它適用於監控長時間運行的操作、輪詢連接服務或以短間隔恢復審查循環等用例。
在撰寫本文時,「心跳」功能在桌面應用程式中有效,但在網頁版 Work 中尚未公開。
兩種自動化都可以設定為一次性或重複執行。其觸發條件可以是精確時間、模糊的時間範圍(例如「早上」),或是代理人監控的條件。
您可以在兩個地方管理自動化。在對話內部,您可以要求 Work 建立一個自動化、檢查現有的自動化、更改其指令或頻率,或暫停和恢復它們。
「排程」頁面則將所有這些功能呈現在使用者介面中:每個任務的下一次運行和最近結果,以及建立、編輯、暫停或刪除它們的控制項。
「排程」頁面還增加了另一個主動性元素:ChatGPT 會為您建議客製化的自動化。有些,例如「每日簡報」,是通用的;o


