我們在《客製化 ASIC 論點》中提到 Taalas 值得關注,並在《推論拐點》中預測一切將垂直發展。儘管我們的 Baseten 節目對蝕刻 LLM(不只是客製化 ASIC)提出了一些懷疑論點,但顯然 AMD 執行長 Lisa Su 目前持不同意見。
Taalas Inc. 宣布已同意加入 AMD。Taalas 成立的宗旨是從底層重新思考 AI 推論,其硬體設計以模型為核心,而非反其道而行。這項創新造就了全球最快、最具成本效益的推論晶片。
AMD 宣布收購專注於 AI 推論晶片的 Taalas 公司,顯示其對客製化 ASIC 的重視。同時,Meta 的 Muse Spark 1.2 模型在多項基準測試中表現卓越,並在 STEM 奧林匹亞競賽中獲得金牌級成績。OpenAI 則整合了 ChatGPT 的付費模型,擴大免費服務,並推出 Agent Plugins,推動 AI 代理基礎設施的發展。
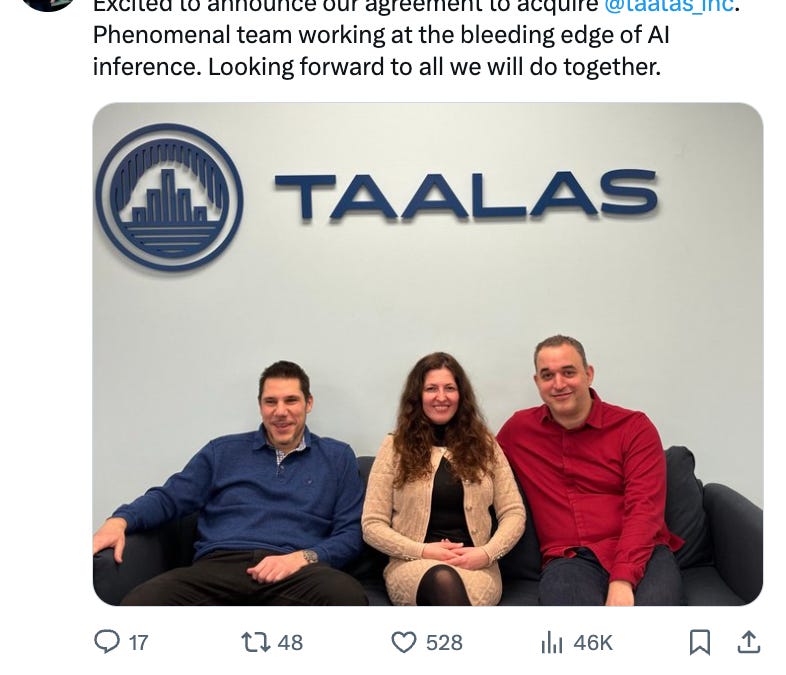
我們在《客製化 ASIC 論點》中提到 Taalas 值得關注,並在《推論拐點》中預測一切將垂直發展。儘管我們的 Baseten 節目對蝕刻 LLM(不只是客製化 ASIC)提出了一些懷疑論點,但顯然 AMD 執行長 Lisa Su 目前持不同意見。
Taalas Inc. 宣布已同意加入 AMD。Taalas 成立的宗旨是從底層重新思考 AI 推論,其硬體設計以模型為核心,而非反其道而行。這項創新造就了全球最快、最具成本效益的推論晶片。
Meta 的 Muse Spark 1.2 模型迅速從「榜上無名」躍升至前沿等級。在 Vals Index 上,Muse Spark 1.2 以每次測試 0.69 美元的價格進入前五名,據稱比 Kimi 便宜三倍,比 Fable、Opus 和 5.6 Sol 便宜十倍以上。
Vals 隨後表示,它也成為第一個在 Finance Agent v2 上得分超過 60% 的模型,每次測試費用為 0.77 美元,而之前的冠軍 Opus 5 則為 5.12 美元,速度更是兩倍。Artificial Analysis 的 v4.1.1 更新也指出,Muse Spark 1.2 在評分更新後獲得了最大的分數提升之一。
Meta 還聲稱其「純粹推理」能力異常強大。Meta 表示,其內部訓練的 Muse Spark 系列模型在五項 STEM 奧林匹亞競賽中取得了金牌級表現,包括在 APhO 和 IPhO 中獲得完美的理論分數,以及在 IMO、IChO 和 RMM 中獲得金牌級表現;其中三項是在現場比賽條件下提交並獲得官方評分的。
Meta 強調沒有使用任何工具,包括搜尋、程式碼或計算機,並將部分進步歸因於多代理協調與平行推理。這項聲明立即引發了關於「LLM vs 輔助系統 vs 神經符號」的持續爭論,批評者和支持者對此設定有不同的解讀。
更廣泛的啟示是:工程師越來越將代理協調、TTC 和評估協議視為一流的產品功能。Muse 的故事不再是「一個模型獲勝」,而是「模型品質 + 協調 + 定價 + 服務能力」共同決定了採用率。這種觀點體現在將 Meta 目前的速度與 Google 進行有利比較,並強調更大的「Watermelon」模型仍在預期中的反應。
OpenAI 將「即時」和「思考」模式整合為一個付費聊天模型。該公司宣布,GPT-5.6 Sol 現在為 ChatGPT 的 Plus/Pro 用戶提供即時和深度推理功能,並新增一個推理努力程度滑桿,讓用戶選擇速度或全面性。OpenAI 表示,更新後的 Sol 在涵蓋金融、醫學和法律的高風險評估中,比 GPT-5.5 Instant 減少了 68% 的事實錯誤回應。
多位 OpenAI 員工將此變革視為一個可用性里程碑:單一模型、單一聊天介面、可調整的努力程度。
免費方案的經濟策略變得更具侵略性。OpenAI 表示,從明天起,免費和 Go 用戶將可無限次使用 GPT-5.6 Luna 進行文字聊天,並新增一個「思考」按鈕以處理更困難的問題。這被廣泛解讀為一項重大的消費者推廣舉措。ARC Prize 在 GPT-5.6 Luna 降價 80% 後重新測試,報告顯示其能力不變但成本大幅降低:在 ARC-AGI-2 上以每次任務 0.18 美元獲得 59.6% 的分數,在 ARC-AGI-1 上以每次任務 0.07 美元獲得 90.7% 的分數。
開發者介面也隨之擴展。OpenAI 推出了 Agent Plugins,這是一個與 AWS、Cursor、GitHub、Vercel 等合作建立的開放標準,用於以共享格式捆綁代理技能和 MCP 伺服器配置,並支援 Codex、ChatGPT、Cursor、GitHub Copilot、Kiro 和 Code 等平台。
OpenAI 還推出了 Codex Security Review 的研究預覽版,旨在直接在 GitHub PR 上進行儲存庫上下文感知安全審查。
謠言監測:一則未經證實但被廣泛傳播的洩露消息稱,「Astra」(被描述為 OpenAI 自 GPT-4.5 以來最大的新預訓練模型,內部代號為 mewfour)可能在下週推出。該謠言廣泛流傳,但在來源資料中沒有得到證實。
Cloudflare 在當天進行了更實質性的基礎設施推動。在「代理週」期間,該公司重點介紹了 Kitesurf,這是一個完全在 Workers 上運行的無狀態瀏覽器,專為代理使用案例設計,在這些案例中,完整的 Chromium 會顯得過度。
其技術優勢在於:將腳本/DOM 與渲染分離,僅在需要時才惰性實例化渲染器 worker,並相對於標準瀏覽器自動化大幅降低 CPU/記憶體開銷。Cloudflare 還推動了 WebMCP、AI 搜尋升級、儀表板級別的 AI Readiness/AEO 工具,以及一篇關於 MCP 重寫的無狀態核心如何更好地適應 Workers 等商品化網路基礎設施的部落格文章。
MCP 正從新奇事物轉變為基本要求。除了 Cloudflare,Weaviate 還在與 REST API 相同的埠上添加了一個內建的 /v1/mcp 端點,提供集合檢查、租戶列表、混合搜尋和物件更新工具,無需單獨的 MCP 服務,並具備 RBAC 和獨立的 MCP/寫入權限開關。OpenAI 的 Agent Plugins 推出和 Cursor 對其的支援也推動了 MCP 相容外掛程式的打包。
業界的爭論已從「輔助系統重要嗎?」轉變為「智慧存在於何處?」。François Chollet 認為,一個在推論時協調多個神經呼叫的大型輔助系統,從定義上來說就是神經符號系統,並且目前的系統通常是「符號三明治」,而非端到端的神經程式。其他人則反駁說,儘管輔助系統決定了能力,但模型仍然是智慧/泛化的核心來源。
這現在是一個實際的工程問題,而非哲學問題:路由、協調、工具架構和評估輔助系統顯然正在改變結果。
多代理模式正在產品化。有幾個跡象顯示團隊正在採用類似蜂群的工作流程:臨時基於執行緒的代理協調、Gemini 代理的自我命名和協作、Hugging Face/Gemma 實驗中 149 個協作代理以及一項新的開放數學證明協作工作。Cognition 也大量依賴雲端代理作為持久的工程能力。
推論路由正成為競爭優勢。Cursor 將其 Router 描述為每週訓練數百萬次產品內互動,以分類和路由請求,從而降低延遲和成本,同時明確承認沒有單一模型能主導所有任務類型:Grok 4.5 用於日常任務,GPT-5.6 Sol 用於規劃/程式碼庫理解,Opus 5 用於執行繁重的工作,Fable 5 用於偵錯/視覺實作。
開放模型的可用性持續擴展到各個平台。Baseten 成為 Kimi K3、DeepSeek V4 Flash 和 GLM-5.2 的官方 Hugging Face 推論供應商;Perplexity Computer 將 GPT-5.6 Terra 設為子代理的預設模型,Luna 則用於排程自動化;GitHub Copilot 開始推出由 Fireworks 託管的 Kimi K3,但因 GitHub Actions 事件而暫停,同時公布了定價:每百萬輸入 3 美元,每百萬輸出 15 美元,每百萬快取輸入 0.30 美元。
成本/效能最佳化仍然非常重要。Unsloth 表示,DSpark 使 DeepSeek-V4-Flash-0731 GGUF 在本地運行速度提高 1.4 至 2 倍,且準確度不變,在某些設定下可達到每秒 120 個 token。關於 DeepSeek 經濟效益的獨立評論指出,即使是大量的總服務量,以目前的定價來看,總 token 收入仍然相對溫和。
vLLM 及相關生態系公司持續圍繞生產規模的開放服務進行定位。vLLM 推廣了經過驗證的 Kimi K3 服務配方和會議計畫,而 Inferact/vLLM 的訊息則強調了 50 萬以上的 GPU 和零日開放模型生產基礎設施。
Google DeepMind 開源了一個具高影響力的天氣模型。WeatherNext 2 發表於《自然》期刊,據稱能為熱帶氣旋預報提供大約額外一天的提前期,這被描述為一次性實現了約十年的預報進展,並將隨程式碼和模型權重一同發布。在實際操作中,DeepMind 表示該系統現在每場風暴能產生 1,000 個機率預測,並在颶風 Melissa 期間提前 5 天以 80% 的信心預測了五級颶風登陸。
基準測試持續專注於領域推理而非通用問答。Elicit 推出了 BioDecisionBench,這是一個從 26 個複雜生命科學推理失敗案例中衍生出來的基準測試,涵蓋 40 種任務變體,重點關注系統是否能捕捉藥物開發決策中的混淆因子、敏感性問題、替代終點和相關錯誤。
Epoch AI 推出了一個新的「遊戲謎題」基準測試,使用一款未公開的遊戲來探測在可能超出分佈範圍的設定中的推理能力;目前 Opus 5 以 59% 的分數領先。
實體 AI 資料集獲得了顯著的開放發布。RekaDaily-10k 包含了 10,312 小時未經編排的第一人稱家庭錄影,其中約 1,670 小時為原生 4K 畫質,這些資料是在美國、拉丁美洲、亞洲和非洲收集的,並以 Apache 2.0 許可證發布。Reka 將其視為實體 AI 所需的「真實世界的混亂」,而非合成或精心安排的資料。
可解釋性和使用者與模型互動方面也取得了具體進展。Transluce 報告在測試的 24 個模型中有 21 個出現了「使用者感知」效應,即模型行為會根據感知到的使用者身份而改變;對於 Claude 而言,最強烈的變化集中在 AI 安全研究人員周圍。在可解釋性方面,Goodfire 強調使用 Silico 來探測人類動作模型和 VLM 中的表徵。
在社群媒體上,有貼文聲稱 Qwen 3.8 Max 在 Artificial Analysis 代理指數上超越了 Claude Opus 5,該基準測試專注於 GDPval-AA v2 和 𝜏³-Banking 代理評估。然而,有評論者反駁此說法,指出截圖顯示 Claude Opus 5 以 59.2 分領先 Qwen 3.8 Max 的 58.4 分。
另有評論者分享實務經驗,認為 Qwen 在 PHP 方面比 Fable 表現優異,但也有人認為從小規模 Qwen 模型分數推斷其整體表現是過於樂觀。
覺得值得一看?分享給朋友。
以上為 AI 自動翻譯導讀。原文版權歸 Latent Space 所有, 建議透過「閱讀原文」前往原始網站,以取得最完整資訊並支持原作者。
43 個來源、每 2 小時更新,太多看不完。電子報每週挑最值得看的幾則,附上 Max 的看法。