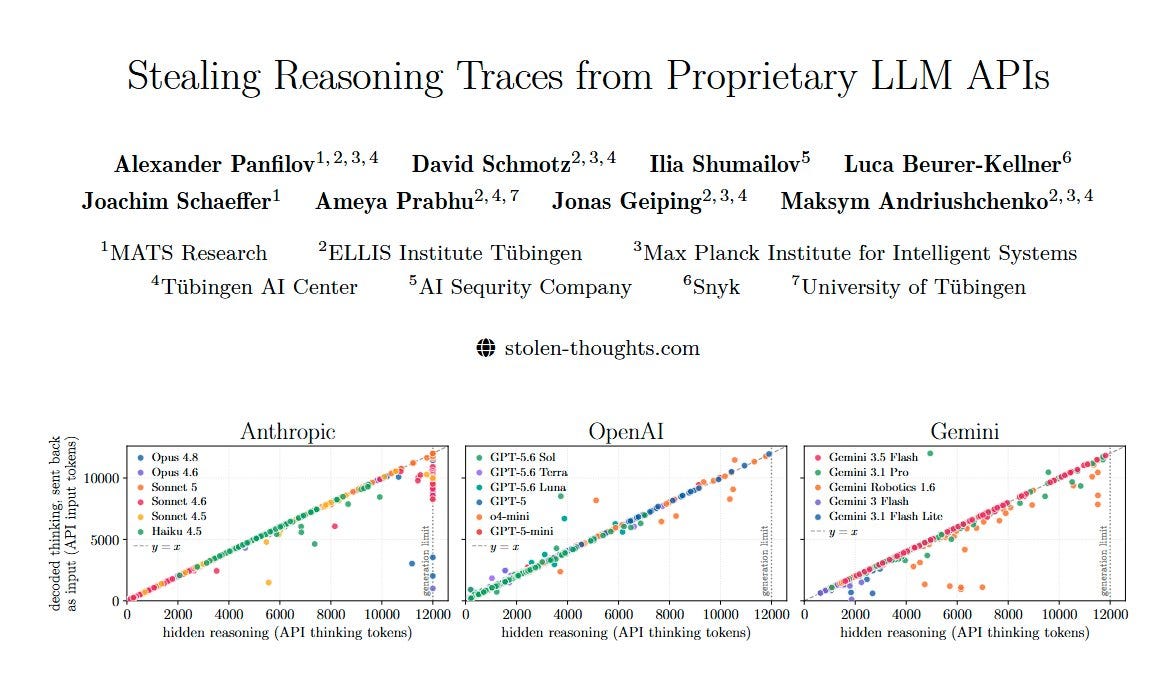
很少有論文能成為當日頭條新聞。由於國內外可理解的原因,人們對「對齊、安全和思維鏈監控」的解釋性文氏圖重新產生興趣,因此今天的論文發布時機恰到好處。
Alexander Panfilov在社群媒體上宣布:「我們終於可以談論這件事了:我們發現了一種利用所有頂尖AI公司API漏洞的方法,可以提取模型隱藏的推理過程。」他進一步指出:「我們驗證了,對於我們查詢的大多數提示詞,我們提取的推理token數量與API計費的思考token數量完全一對一匹配。」
自從o1發布以來,頂尖實驗室的推理模型一直透過加密簽章來隱藏其軌跡,以防模型蒸餾。Matthew Green在五月時負責任地報告了第一個漏洞,他詳細說明了其運作方式,並找出如何利用延遲測量間接重放和側通道攻擊這些軌跡。
今天的論文則證明,這些加密的「思考」可以被解碼並移植到不同的模型、會話或使用者,進而顯著提升開源模型的性能。
更令人擔憂的是,論文指出:「此外,如果您曾在線上分享包含加密推理區塊的Claude Code/Codex會話,這些區塊可能會被解碼,進而洩露您的個人資料。」研究人員進行了約7,000個公開軌跡的初步掃描,發現了62個獨特的API金鑰、33個電子郵件地址、33個密碼以及其他敏感資料。其中有64項敏感資料僅出現在推理區塊內部,而未在可見的會話中顯示。
作者們也詳細說明了對齊問題,例如思維鏈(CoT)摘要器隱藏答案、難以理解的推理、作弊考量以及網站攻擊等。論文中大致描述了這種技術:首先,從API回應中獲取一個合法的加密/簽章推理區塊。
接著,將該區塊重放到同一供應商的較弱模型,可能是在不同的帳戶或會話中,作為助理或模型的輪次,並提示或預填較弱模型來轉錄附帶的推理。最後,重複取樣,捨棄拒絕的回應,並可選擇性地協調多個嘈雜的轉錄結果。
論文提供了針對不同模型的具體範本,並帶有一些細微差異。對於Claude,是將簽章的思考區塊重放到Haiku 4.5,然後跟隨一個助理預填,例如<thinking-copy>。
對於GPT,則是將encrypted_content推理項目多次注入到偽造的對話中,並取樣多達50個輸出;它還描述了如何使用分塊連續繞過約50個token的逐字輸出閾值。對於Gemini,則是將thought_signature附加到模型輪次中,並帶有<thought>預填,然後使用重複取樣和協調。
這篇論文是負責任地披露的,其中一些漏洞已經修復,但類似的攻擊似乎仍然可能發生。Can Bölük指出,其實可以禁用模型的「思考」功能,改為提供一個「deep_think」工具,模型仍會以內部CoT推理格式調用它,這對修復漏洞來說是個挑戰。
Alexander Panfilov再次強調,他們發現了利用頂尖AI公司API漏洞來提取隱藏推理的方法,並確認提取的token數量與計費的思考token數量一對一匹配。這項關於推理軌跡暴露、CoT隱私和浮水印的討論,揭示了頂尖API的漏洞,允許提取「加密」的隱藏推理。
後續報告指出,對約7,000個公開軌跡的掃描發現,解碼後的區塊中包含62個API金鑰、33個電子郵件地址、33個密碼及其他敏感資料。Jonas Geiping強調了公開分享軌跡的即時隱私風險和操作安全影響,並提到調查期間曾遇到洩露的Hugging Face生產金鑰。
多個貼文也指出,當解碼後的CoT變得簡潔、碎片化、多語言或類似「神經語言」時,監控會變得非常困難。一個實際的推論是:即使實驗室隱藏推理,工具介面仍可能重新暴露它;Can Bölük提到,禁用明確思考功能但提供deep_think工具,仍可能導致內部格式的CoT輸出。
從技術層面來看,討論分為「嚴重的隱私/安全問題」和「非可擴展的蒸餾途徑」兩種觀點。Vipul Ved認為,這種攻擊並不意味著可以大規模竊取思維鏈用於模型訓練,他將加密視為無狀態分散式推理協定優化,而非堅不可摧的保密屏障。
然而,這次事件仍突顯了幾個重點:公開分享軌跡存在風險;隱藏的CoT並非可靠的監控介面;實驗室可能需要更強大的沙盒、遙測和工具介面保障。同時,另一個討論串則在歐盟式合規壓力下,辯論AI文字浮水印的問題。
Trq212表示,實驗室正在增加浮水印和文字檢測API;批評者質疑這是否會使輸出膨脹或損害程式碼/文件的簡潔性。其他人則認為,熵預算足夠大,簽章可以很微妙,特別是對於較長的輸出。
NVIDIA推出了Nemotron 3.5 Lightning,這是一個30B的MoE模型,擁有約3B的活躍參數,專為全時運作的代理工作負載設計。NVIDIA及其生態系統強調其高達4倍的吞吐量、1M的上下文長度、開放且可客製化的發布套件,並支援在Hugging Face上獲取權重、資料和配方。
Artificial Analysis提供了最詳細的第三方摘要:總參數31.6B,活躍參數3.6B,採用OpenMDW-1.1許可證,支援NVFP4和BF16權重,預發布端點測試中位數服務速度接近670 token/秒,其智慧指數得分為24,大致與gpt-oss-120b相當,但體積更小、速度更快。
對於其規模而言,代理性能表現尤為強勁:GDPval-AA v2 Elo得分824,Terminal-Bench v2.1得分24%,兩者都比Nemotron 3 Nano有顯著提升。
Lightning模型迅速在各個平台發布,包括Together AI、Ollama、Baseten、vLLM和Perplexity API等。一種常見模式是將成本較低的執行模型與更強大的規劃器結合:Kimmonismus將Lightning視為NVIDIA的「本地代理工作力」,透過路由來補充大型規劃模型。
Harvey報告指出,在Legal Agent Bench上進行後訓練後,Lightning在保留任務上的表現從0%提升到8.3%,在該設定中超越了Opus 4.6和Nemotron 3 Ultra,同時將平均輸出從90k token減少到37k token。總體而言,這次發布強化了當前開源模型的趨勢:更小、更快的模型,專為高頻率工具使用而優化,而非追求通用聊天聲譽。
UnslothAI推出了Unsloth Desktop,這是一款開源桌面應用程式,可在Mac、Windows和Linux上本地運行和訓練模型,支援MLX、GGUF、擴散圖像/影片、音訊、CPU和多GPU設定,以及與OpenAI相容的API。
其顯著的系統角度在於超越「本地聊天UI」的雄心:包括工具調用、沙盒程式碼執行、私人搜尋、RAG、MCP、匯出等功能,並聲稱訓練速度快2倍,VRAM使用減少70%。
多位觀察家將其定位為一個更端到端的本地AI操作環境,而不僅僅是LM Studio的競爭對手。開源/本地生態系統也迅速支援Meta Muse Glimmer 30B和Nemotron。
Mervenoyann強調了llama.cpp和Transformers中對Muse Glimmer的DFlash草稿支援,聲稱以少量記憶體成本實現2-4倍的生成速度提升,並將很快提供簡單的llama服務指令。在模型分析方面,Rasbt對Glimmer進行了有用的架構分析:這是一個密集的30B多模態推理模型,具有混合局部/全局注意力、極致的KV快取效率(估計約52 KiB/token BF16),其設計更接近Gemma系列模式而非MoE競爭對手。
OpenAI最終也推出了Linux桌面支援:OpenAI宣布ChatGPT桌面應用程式的Linux預覽版,支援Ubuntu 24.04/26.04、Debian 13、Fedora 43/44,並提供x64和ARM64套件。對於現有的代理使用者來說更重要的是,桌面應用程式現在可以將其他代理的專案、聊天、技能和外掛程式匯入/同步到ChatGPT Work和Codex中,並包含自動更新。
這似乎是為了減少切換摩擦,並使Codex/桌面成為整合中心,而非一個新的獨立系統。
Grok Bot的推出比單純的模型發布更具產品意義:xAI推出了Grok Bot,將其定位為擁有自己雲端電腦的AI隊友,可以登入工具並執行持續性工作。早期使用者發現的有趣細節是產品/營運導向的,而非以模型為中心:這些機器人可以監控Slack討論串和GitHub Actions,重複執行排程任務,建立/管理其他機器人,並跨連結的雲端環境工作。
Kimmonismus指出,這似乎與Cursor的分發和定價緊密相關,暗示了一個「虛擬同事」的產品類別,其中持久上下文、登入環境和代理間委託比原始基準測試的提升更為重要。
評估正轉向長週期、確定性、領域真實的任務:LlamaIndex推出了ExtractBench,這是一個針對企業文件提取的確定性基準測試,涵蓋370份文件、4,869頁和67種文件類型。其最具操作性的結果是,商業VLM在超過50頁的文件上可以保持高精確度,但召回率會降至35%以下,主要透過靜默的行/列表截斷。
他們還在LlamaParse中引入了「Agentic Plus」提取層級,聲稱價值準確度達到95.6%,成本不到最接近競爭對手的三分之一。Artificial Analysis發布了AA-AnalystAgent,這是一個針對試算表/文件量化分析的代理基準測試,使用pass^5可靠性指標評估80項任務。
Claude Opus 5以54%領先,其次是GPT-5.5的50%和Claude Fable 5的49%;Kimi K3是頂級開源權重模型,得分39%。這兩項基準測試的共同主題都是強調可靠性和工作流程的正確性,而非單次任務的能力。
對基準測試的懷疑情緒正在上升:Hrishioa提出了一項深思熟慮的批評,認為許多現代評估是憑「感覺」而非精心設計的,導致評分錯誤、聚合不佳,甚至出現可利用的提示詞/沙盒。鑑於最近關於沙盒逃逸、出站網路存取和代理獎勵駭客的報告,這項批評更具說服力。
此外,微軟的研究因「提示時技能編譯」的結果而受到關注:Xidulu分享了在解碼時饋入先前的隱藏狀態以獲得免費收益的工作。Dair_ai總結了另一篇論文,該論文顯示從先前軌跡中提煉出的緊湊自然語言技能,可以在多個多步驟代理任務中,彌補非推理模式和推理模式之間55%至100%以上的差距,通常只需2.7至6倍更少的輸出token。
基礎設施、驗證和系統研究方面,可驗證推理正從理論走向產品化。


