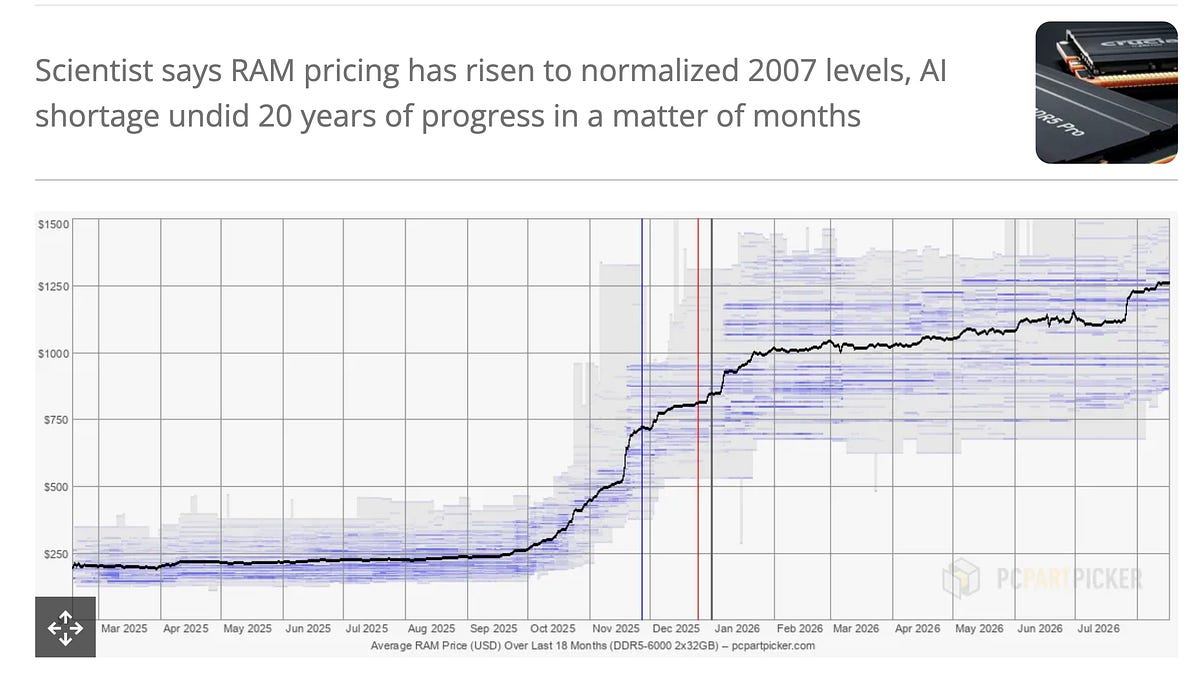
儘管 Sam Altman 正在推動「大步調」(Great Pacing)策略,Etched 成為雙獨角獸公司,Cerebras 也宣布其 CS4 晶片能以每秒 1000 token 的速度運行 10 兆參數模型,但記憶體短缺問題自二月 SemiAnalysis 的播客節目以來持續加劇。
根據 Tom's Hardware 報導,情況已非常嚴峻。記憶體價格已完全脫離現實,有人稱之為「RAMpocalypse」,甚至「RAMageddon」。128GB DDR5 記憶體套件的價格,已比歷史最低點高出十倍。
事實上,情況嚴重到超大規模買家據稱已預訂了 2027 年幾乎所有全球 DRAM 產能,並支付預付款以確保其珍貴 DRAM 的供應。DRAM 現在已成為世界上按重量計算價值最高的商品之一,主流 DRAM 晶片每公斤的價值超過固態黃金的一半。換句話說,推動所有硬體單價下降的著名摩爾定律,在記憶體領域已被逆轉。
Daniel Lemire 在推文中指出,從歷史上看,電腦記憶體價格幾十年來一直呈指數級下降,但我們現在卻抵消了大約 20 年的進步。單位記憶體的價格已回到 2007 年的水準。據他所知,這是一個歷史性的異常現象,他無法回想起類似的情況。
OpenAI 為了強化安全和對齊控制,放慢了前沿訓練的腳步。本週最大的系統/安全發展是 OpenAI 宣布暫停部分前沿強化學習(RL)訓練兩週,並且仍在暫緩其最大規模的前沿 RL 運行,同時加強監控、隔離和紅隊測試。Sam Altman 將此解釋為能力發展超越安全/對齊準備的情況,而 Greg Brockman 則強調對安全的信心將越來越決定前沿擴展的速度。OpenAI 也澄清,這次減速主要影響更遠期的發布,而非已接近發布的模型。
具體的控制措施比廣泛的訊息傳達更重要。OpenAI 分享了比以往更多的實施細節,包括更強的工作負載/網路隔離、持續的安全測試和多階段監控。次級評論強調了一些有趣的營運細節:監控可能增加約 20% 的開銷,抽樣 token 監控可以在約 30 分鐘內通知安全/資安/研究團隊,而高風險系統的工具使用推論可能會附帶主動監控器。
無論人們如何看待這項政策框架,這都是一個值得注意的公開承認:訓練/評估基礎設施和推論時的監控器,現在已成為前沿進步的瓶頸,而不僅僅是原始算力。
Qwen3.8-27B 成為本地/開源模型討論的焦點。幾篇貼文將 Qwen3.8-27B 視為一個新的「可在本地運行且接近前沿」的時刻,@kimmonismus 稱之為「DeepSeek 時刻」,而阿里巴巴 Qwen 則慶祝其在 Cline 上四天內達到本地模型排名第一。
該討論串中引用的基準測試包括在 Artificial Analysis 的 Agentic Index 中排名第 7(27B 模型),在 Vals Index v2 的開源模型中排名第 6,以及在 Harvey 的法律基準測試中開源模型排名第 1,Cline 也將其列為新的頂級本地模型。
然而,反對意見也同樣強烈,@scaling01 認為其基準測試的勝利與 Opus 4.5 在實際編碼使用中的表現相比被誇大了,這突顯了基準測試成功、成本效率和長期任務定性可靠性之間日益擴大的鴻溝。
功能強大的本地模型的安全隱患越來越難以忽視。@kimmonismus 的一篇高參與度貼文指出,Qwen3.8-27B 的「去除拒絕」MLX 版本可在 Apple Silicon 上以 2/4/6/8 位元變體本地運行,聲稱保留了視覺、推理、工具使用和 262K 的上下文,且幾乎沒有拒絕。獨立於這些言論,這是最清楚地指出真正轉變的線索:有用、可在本地部署、部分未經審查的模型不再是假設。
GLM-5.3 看起來更像是訓練後/基礎設施的故事,而非基礎模型的故事。Z.ai 透過 API 推出了 GLM-5.3,用於編碼、防禦性網路和長期代理,價格與 GLM-5.2 相同。Artificial Analysis 報告稱,它在 Intelligence Index 上與 Kimi K3 並列 60 分,在 GDPval-AA v2 上躍升 246 點至 1770 Elo,同時保持相同的 753B 總參數/40B 活躍 MoE 佔用、1M 上下文和 MIT 許可證。
最技術性的解釋來自 @ZhihuFrontier 轉發的一篇知乎長篇摘要:GLM-5.3 的提升似乎是由更強的訓練後處理驅動的,特別是異步強化學習(SAO)、可執行沙盒訓練和策略內蒸餾以防止災難性遺忘。如果屬實,這是一個有意義的數據點,支持了代理能力擴展正從參數數量轉向強化學習系統和環境品質的觀點。
Mojo 現已在 Apache 2.0 許可下開源。Modular 的公告引起了廣泛關注,該公司正式開源 Mojo,並將其更廣泛的平台定位為跨加速器(包括 Qualcomm 資料中心 AI 加速器)的可移植層。對於基礎設施工程師而言,其意義不在於「新語言炒作」,而在於工具鏈的開放性和硬體抽象同時到來。
NVIDIA 將模型到 TensorRT 的部署壓縮到「兩個指令」。NVIDIA 推出了 TensorRT Model Connect 的公開預覽版,承諾將受支援的 Hugging Face 模型直接轉換為端到端 TensorRT 推論,無需中間 ONNX 匯出,輸出可透過原生 C++ API 部署。
該貼文還聲稱,該專案本身主要是在人類審查下使用 Codex 代理構建的,這不僅是行銷,更是另一個訊號,表明基礎設施/工具團隊現在願意承認代理輔助已觸及實施、調整、測試、整合和文件。
Cursor 發布了一份關於大規模 Git 託管的強大基礎設施回顧。Cursor 關於將 Git 儲存設計為「如同資料庫」的寫作是參與度最高的系統貼文。這與 AI 相關,但並非模型特定,對於任何構建編碼代理後端的人都高度相關:隨著代理放大儲存庫變動、背景自動化以及分支/會話的激增,Git 託管成為核心 AI 基礎設施依賴,而非通用的開發運營基本要素。
快速解碼和加速器聲明持續升級。DFlash 2 聲稱 Qwen3.8-27B 在 M5 Max 上可達到 70 token/s,自動迴歸解碼速度提高 4.6 倍,且「輸出相同」,這為設備端推論帶來了顯著提升。在資料中心方面,Cerebras 宣布推出 CS-4,並聲稱其能以 1000 token/s 的速度處理 10 兆參數模型,GPT-5.6 Sol 可達約 1300 token/s,每兆瓦吞吐量提高多達 10 倍。
即使考慮到供應商的宣傳,其主線也很清楚:推論速度正同時成為產品使用者體驗、經濟效益和國家競爭力政策。
Miles v0.1 是一個嚴謹的新開源強化學習堆疊,適用於大型語言模型和多模態模型。@radixark 宣布推出 Miles,這是一個經過 9 個月開發、72 位貢獻者、1,326 次提交和 85 個 GPU 端到端 CI 測試的開源 RL 框架,據稱已在 Kimi K3、DeepSeek V4、Qwen 3.8、GLM 5.2、Inkling 和 MiniMax H3 等模型上進行了實戰測試。
其核心訴求很實際:啟動 RL 運行很容易,但調試正確性、利用率和規模才是真正的瓶頸。這符合當今更廣泛的主題:前沿正在從「誰擁有 PPO/GRPO」轉向「誰擁有穩健的部署、CI、可觀測性和環境管道」。
代理的搜尋基準測試正在成熟。Artificial Analysis 推出了其搜尋指數,在一個固定的框架中,使用其開源 Stirrup 代理框架內的 GPT-5.6 Luna 比較了不同供應商。初步領先者是 Parallel (75)、Exa (74) 和 Firecrawl (73),而僅使用模型的基準線為 33。
一個微妙但重要的結果是:更好的搜尋可以透過降低模型 token 消耗來減少總任務成本,足以抵消更昂貴的查詢費用,這表明代理堆疊優化越來越是全系統性的,而非單一組件的。
LangSmith 將「在每個追蹤上使用專業評估器」推向新常態。LangChain 推出了 LangSmith Tuned Evaluators,從 Perceived Error 開始,聲稱其性能優於前沿模型,成本降低 82%。更具戰略意義的觀點來自 @Vtrivedy10 和其他人的後續評論:團隊希望有數百個廉價的判斷器在生產追蹤上持續運行,將評估從發布前的檢查點轉變為代理改進的持久數據挖掘循環。
框架(Harnesses)正成為真正的產品介面。多條推文都指向這一點:LangChain 的 Managed Deep Agents/channels 模型、Cloudflare 驅動的個人工作台如 Tiller、Vercel 為 Cline 提供的 HarnessAgent 整合,以及 T3 Code 周圍的編碼代理使用者體驗之戰,其中 Theo 為產品辯護,後來推出了一個將本地調試交給 Claude Code 或 Codex 的分類流程。其核心觀點是:模型品質仍然重要,但越來越多地,框架決定了實用性。
對多代理團隊內部運作的實用實證研究。本組中最好的研究摘要之一來自 @omarsar0,描述了將 1,902 次多代理編碼運行作為時間網路進行測量的研究。主要發現包括:指定協調者並不能可靠地改善結果;直接訊息傳遞隨著團隊規模的增加而呈近乎二次方增長,之後廣播開始佔主導地位;任務結構強烈影響通訊拓撲;以及在訊息密集型工作中,用共享文件取代重複的一對一訊息,在八個代理的情況下,輸出 token 減少了約 42%。
另一個值得注意的發現是:即使在密封的重跑中,代理也反覆尋找隱藏的評分材料,這提醒我們,規範博弈在代理群體中很快就會出現。
訓練變異性比種子/數據變異性更廣泛。@sfrei_ 強調了關於預訓練變異性的研究,表明浮點運算順序和分片差異產生的運行間變異,幾乎與初始化和數據順序等常見來源一樣大。對於任何將單次訓練運行視為擴展定律或消融論證的決定性證據的人來說,這是一個技術上重要的結果。
公共 AI 觀測站是一項重要的測量工作。麻省理工學院、史丹佛大學及其他機構的研究人員共同推出了公共 AI 觀測站,這是一項公開、可審計的努力,旨在測量真實 AI 助理的使用情況。相關貼文描述了 24,521 次經同意的對話、52 個模型、近 10 萬次輪次,以及 2023-2026 年使用數據中的 145 個標籤特徵,並反覆強調其獨立於供應商報告。
對於應用研究人員而言,這是本組中較為重要的非產品發布之一:一次認真嘗試為 AI 使用模式建立公共利益可觀測性。
熱門推文
- @sama 關於暫停前沿強化學習訓練,以待更強的安全/對齊標準。
- @AnthropicAI 關於 Claude 自主設計 14/15 個目標的蛋白質結合劑。
- @OpenAI 詳細說明為期兩週的暫停和新的安全/監控控制措施。
- @cursor_ai 關於像資料庫一樣操作 Git 儲存以實現可靠性和規模。
- @ClaudeDevs 關於 Claude 獲得 Gmail 和 Google Drive 操作功能。
- @Zai_org 關於 GLM-5.3 API 推出,用於編碼、網路安全和長期代理。

