不到一個月前,我們才在節目中介紹了 Poolside 的模型工廠,並採訪了 Eiso Kant。現在看來,NVIDIA 執行長黃仁勳也對 Poolside 青睞有加,從投資者轉變為授權其技術並聘用 109 名員工。
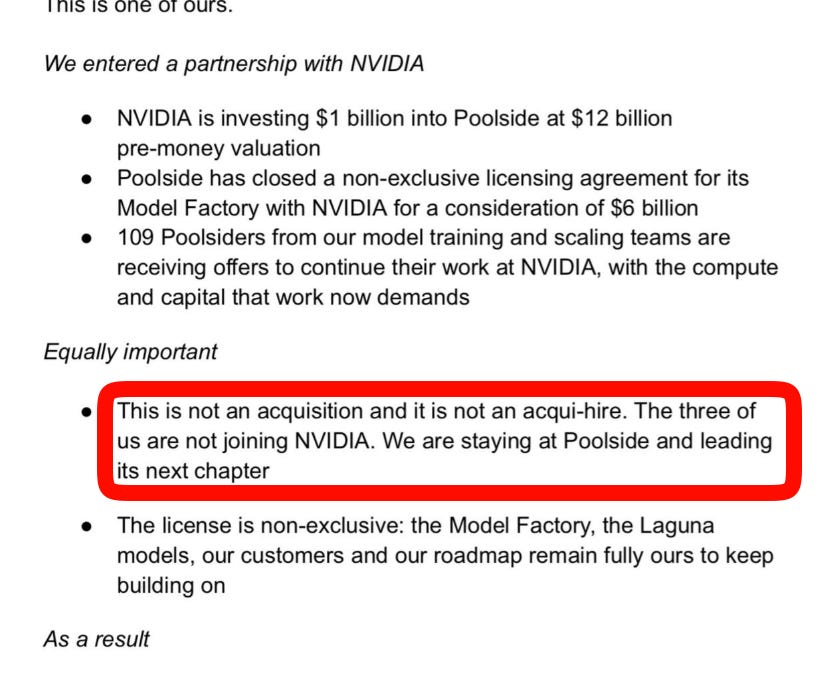
根據 Eric Newcomer 取得的投資者信函,Poolside AI 這家人工智慧模型建構新創公司,已與 NVIDIA 達成一項非獨家授權協議,價值 60 億美元。NVIDIA 還將以 120 億美元的投前估值,向 Poolside 投資 10 億美元。
除非情況發生重大變化,這項交易幾乎涵蓋了 Poolside 絕大多數的技術員工。Eiso Kant 曾表示,他們公司在應用研究和工程領域積極招募各種職位,從模型訓練到評估及後訓練架構。他強調,在 Poolside,個人能產生巨大的影響力,因為不到 70 人就建構了這個模型,而工程師和研究人員總共不到 115 人就完成了這項工作。
Poolside 創辦人表示,這既不是「收購」也不是「人才收購」。過去我們將 Windsurf-Google、Character-Google、Scale-Meta 和 Instacart-OpenAI 等交易稱為「高階主管挖角」,因為通常是高階主管離開,員工獲得豐厚報酬,但公司仍保留。
然而,這次是首次出現反向操作:員工被挖角,創辦人卻留下。這意味著創辦人正將公司極力轉型,並為投資者和員工提供極為優渥的條件,讓他們能繼續原有使命或參與新的轉型。
Poolside 創辦人指出,過去三年半,他們在資本需求急劇增加的競爭中方向正確。去年底,他們有六週時間籌集 20 億美元,以支付一月上線的 40,000 顆 GB300 晶片叢集,但未能及時完成,因此失去了該叢集。
他們也意識到,即使擁有 10,000 到 20,000 顆 GB300 晶片,他們也能產出一個能與當前頂尖模型匹敵的優秀模型。然而,明年頂尖模型的規模將需要遠超一個數量級的更大叢集。為此,目前的限制不僅是資金,還有實體資料中心空間和已簽約的運算資源。
為了達到當前模型配方的頂尖水準,所需的運算能力正呈垂直增長,隨著世界在「遞迴式自我改進」軸線上加速發展,這一點將會更加明顯。為此,於 2026 年 1 月分拆出的 Poolside Infrastructure Company (PIC) 也展現了其雄心壯志。
eliebakouch 預測新的 Poolside 將會「非常徹底地轉向基礎設施,不再進行模型訓練」。他指出,作為一個獨立實體,Poolside Infrastructure Company (PIC) 仍在德州建造一個 1.2GW 的資料中心,並在兩個月前和三天前分別任命了新的執行長和財務長。
eliebakouch 對此感到震驚,他理解 NVIDIA 購買了 Poolside 的「模型工廠」部分,許多員工(研究人員?)也收到了 NVIDIA 的工作邀約。創辦人留在 Poolside 則很不尋常,他好奇他們是否會轉型為新的雲端/運算服務供應商。
我們也感到困惑,創辦人表示他們「尚未準備好分享更新後的願景」。但由於所有相關方都獲得了豐厚的報酬,我們很期待看到原始 Poolside 分化出的三個不同方向將如何發展。他們留下的唯一線索是:
「我們堅信,所有具有經濟價值、科學趣味以及許多個人意義的事物,都將以 AI 為基礎。世界尚未達到這場轉型的 0.1%。」他們認為,人類級別的智慧能力將被開源模型完全商品化,而超級智慧則可能不會。
世界有兩種具有經濟價值的問題:一種是「智慧受限」的問題,可以透過擴大智慧來解決,例如軟體開發、會計、數學定理證明。另一種是「實驗受限」的問題,需要真實世界的實驗才能進步,單純增加智慧而沒有實驗結果將無法取得進展。
例如,即使我們召集十萬名世界上最聰明的人來解決癌症,如果沒有真實世界的實驗回饋循環,他們可能永遠無法成功。今天的模型收入來自程式碼編寫,很快將擴展到所有知識工作。
未來,能夠超越人類能力的公司將從科學發現中獲取收入,這些發現將建立在真實世界實驗所產生的數據護城河之上。他們謙遜地認為,AI 的最終價值不會來自第一種問題(那將成為低利潤的商品),而是來自第二種問題。AI 將成為世界上最有價值的科學發現引擎。
OpenAI 一次性推出了多項桌面和開發者功能。ChatGPT 在 Mac 上推出了 Apple Messages 外掛程式,讓使用者能從桌面應用程式搜尋、追蹤、起草和發送訊息。OpenAI 開發者也為 ChatGPT Sites 增加了協作編輯功能,團隊成員可以共享專案,由 Codex 管理 Git/CI。
此外,共享的唯讀對話連結和 PR 上下文共享功能,進一步將 ChatGPT/Codex 推向協作平台,而不僅僅是聊天介面。在 API 方面,GPT-Image-2 的透明背景功能現已開放預覽,可用於可重複使用的設計資產。
OpenAI 的桌面記憶體/工作流程功能持續在全球各地推出。OpenAI 開發者表示,電腦歷史記錄和跨應用程式記憶體功能現已在歐洲經濟區、英國和瑞士向專業版/商業版/企業版 Mac 用戶開放,錄製與回放功能也已上線。這些功能共同指向一種產品策略,即在裝置上捕捉使用者工作流程,並將重複操作轉化為可重複使用的技能。
Anthropic 使其代理平台更具可組合性和生產就緒性。Claude 開發者宣布,Claude 平台上的電腦使用、瀏覽器工具、Skills API 和 Files API 已全面上市。
Skills API 增加了版本化的可重複使用程序;Files API 現在支援過期控制、將速率限制提高五倍至每分鐘 500 次請求,以及每個組織 1 TB 的容量。Anthropic 還為 Claude Managed Agents 發布了一個 AG-UI 轉接器,將聊天執行緒映射到受管理的會話,並將文字、工具呼叫和思考過程串流到自訂使用者介面中。
AT&T 成為混合路由最清晰的公開案例研究。Hesamation 總結了 AT&T 內部 AI 部署的關鍵企業數據:40% 的員工 AI 使用量已路由至開源模型,目標是達到 60-70%。程式碼編寫成本下降了 56%,而品質僅下降 2%,每天處理 450 億個 token。
這支持了日益普遍的觀點,即頂尖的閉源模型仍保留用於最困難的任務,而「足夠好」的開源模型則滿足了企業大部分的需求。Amir 明確將此視為對 OpenAI/Anthropic 企業護城河的警示,而 Ollama 則歡迎 AT&T 擁抱開源模型。
閉源模型分發的價格壓力正在加劇。Eglyman 宣布透過 Router 購買 GPT-5.6 Sol 可享五折優惠,GitHub 和 VS Code 也為其用戶擴大了 GitHub Copilot 的臨時折扣。
同時,使用者情緒顯示供應限制正以使用上限而非品質下降的形式浮現。Bridgemindai 抱怨每月 200 美元的 OpenAI Pro 方案在一個重度使用 Codex 的日子裡就可能耗盡,而 Theo 則指出在達到規定上限後仍可繼續消耗大量 token。
這更廣泛的訊號表明:各實驗室仍在尋找高階模型存取與經濟可持續的代理式使用之間,正確的產品界線。
開源模型(Open-weight model)的採用和分發持續擴大。Ollama 表示 Kimi K3 已向超過一半的訂閱用戶推出,提供美國/歐盟託管且不保留數據。
在開源生態系統方面,Google 和 Osanseviero 強調 Gemma 下載量已突破 10 億次,而 Phil Schmid 則發布了一個 Awesome Gemma 儲存庫,彙集了各種變體、部署指南和微調配方。
Meta 的 Muse Spark 1.2 在多模態/代理評估中表現強勁。Meta AI 展示了涵蓋視覺程式碼編寫、機器人規劃和影音理解的示範,並預覽了 WildArtifactBench,這是一個使用人類/代理評審的勝率和 Elo 分數來評估實際多模態任務的內部基準。
第三方測量結果也相當有利:Arena 報告 Muse Spark 在 Agent Arena 中淨提升 2.1%,高於 v1.1 的 0.9%,尤其在 Bash Recovery 方面表現突出(+11.4%)。DesignArena 將 Muse Spark 1.2 評為「影片轉網站」第一名、「圖片轉 HTML」第二名和「圖片轉前端」第三名,並指出其位於價格偏好帕累托前沿。
智譜的 GLM-5.3 持續在代理/程式碼評估中嶄露頭角。AutoClawAIer 宣布將 GLM-5.3 整合到 Z.ai 的工作代理 AutoClaw 中。
更重要的是,Arena 表示 GLM-5.3 Max 改變了 Code Arena: WebDev 的帕累托前沿,預計在開源模型中排名第二,總體排名第八,得分 1597 分,成本為每百萬 token 3.65 美元。另外,Zixuan Li 重新提及 SAO(單次試驗非同步優化)作為 GLM-5.2/5.3 在強化學習中實現穩定非同步代理式強化學習的關鍵進展。
Gemini 3.7 Flash 持續累積「便宜又強大」的證據。Arcprize 報告稱,Gemini 3.7 Flash 在 ARC-AGI-2 任務中達到 84.6% 的準確率,每項任務成本 0.25 美元;在 ARC-AGI-1 任務中達到 95.5% 的準確率,每項任務成本 0.12 美元。
這使得 Gemini 3.7 Flash 在成本調整後的推理性能方面表現突出。Jonathan Jarvis 另外稱其在代理視覺任務方面表現出色。
OpenAI 的下一代預訓練堆疊正轉移到 Rubin 平台。Uday Ruddarraju 發文表示,OpenAI 的首批 NVIDIA Vera Rubin 機架已安裝並運行訓練堆疊,明確用於下一代頂尖模型的預訓練。GDB 稱這是 OpenAI 與 NVIDIA 合作的一個重要里程碑。
Cerebras 的 CS-4 因其在不縮小節點的情況下實現推論擴展而受到關注。Kimmonismus 總結這次發布,指出透過重新設計的供電和散熱,CS-4 在相同的 5 奈米晶圓、4 兆電晶體和 90 萬個 AI 核心上,性能幾乎翻倍。
報告的規格包括每個 WSE-3 Turbo 達到 250 PFLOPs,記憶體頻寬為 43.2 PB/s,以及一個三晶圓的 CS-4 機架可達 750 PFLOPs。對於實務工作者而言,值得注意的是:在 GPT-OSS-120B 上,每個使用者可達 4,400+ token/秒,比基於 GPU 的系統快上 30 倍。
代理執行時的人體工學正成為系統瓶頸。Theo 認為,對於代理工作負載,Linux 在性能上明顯優於 macOS,尤其是在檔案系統密集型操作方面。
Qdrant_engine 分享了一篇實用的語義快取文章,顯示其命中率達 57.1%,減少了 55.7% 的 token 使用量,命中延遲約 15 毫秒。MParakhin 推廣 gisting 作為一種未被充分利用的生產技術,指出其可將端到端延遲降低約 40%,吞吐量提高約 15%,並產生更好的結果,同時附上了一篇 Shopify 工程文章。
Chroma 推出了自我改進記憶體的研究預覽。Jeffrey Huber 宣布了 Foundation,這是 Chroma 針對代理記憶體的方法,其基礎是先前的代理會話。這項發布正值從「...」的廣泛轉變之中。

