為了大規模生成智慧,AI 工廠必須持續運作,其經濟效益取決於實際產出:每秒處理的 token 數、每瓦處理的 token 數、每個 token 的成本、利用率和正常運作時間。
這需要將 AI 基礎設施設計並建構成一個完整的工廠,而非僅僅是個別加速器的集合。
為滿足大規模 AI 運算需求,AI 工廠需要整合式的基礎設施,而非單一加速器。NVIDIA 推出 NVLink Fusion,讓客製化 XPU 能與 NVIDIA 領先的 AI 基礎設施無縫接軌,提升效能、加速產品上市並降低風險。此方案提供成熟的縱向擴展網路、平台韌性與標準化架構,協助超大規模資料中心業者與 AI 原生公司打造高效的半客製化 AI 工廠。
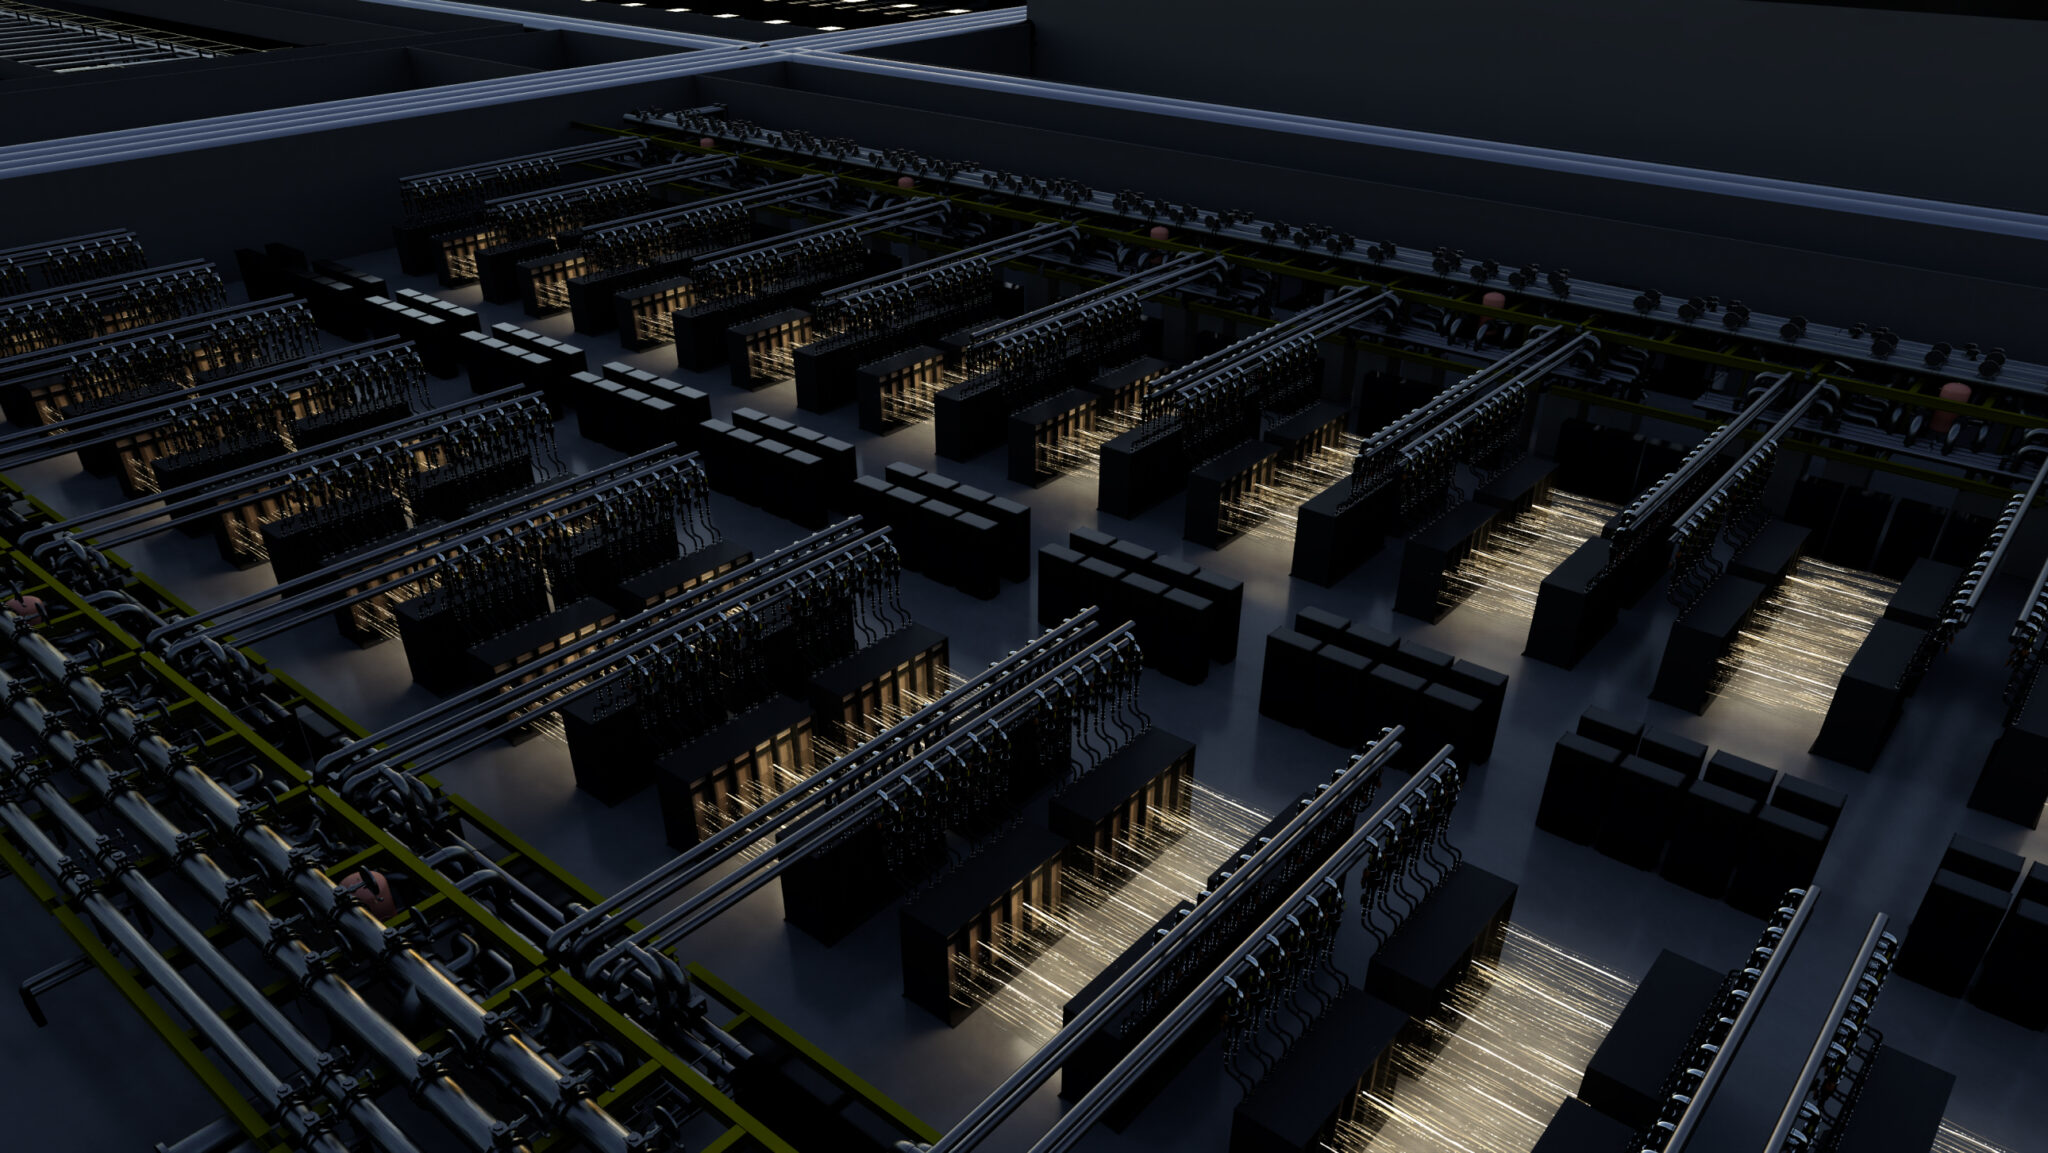
為了大規模生成智慧,AI 工廠必須持續運作,其經濟效益取決於實際產出:每秒處理的 token 數、每瓦處理的 token 數、每個 token 的成本、利用率和正常運作時間。
這需要將 AI 基礎設施設計並建構成一個完整的工廠,而非僅僅是個別加速器的集合。
超大規模資料中心業者和 AI 原生公司在建構客製化 XPU 時,不僅要考慮 XPU 設計,還需考量整個 AI 平台的設計與開發,包括縱向與橫向擴展網路、機櫃級架構、生產工廠軟體以及強大的供應商生態系。
在 AI 工廠規模下,這條路徑既複雜又昂貴,成為 XPU 快速上市的根本障礙。
打破這項限制的方法是將客製化 XPU 與經過驗證、成熟的基礎設施結合,讓開發者能將創新專注於最重要的領域,同時利用既有技術處理其餘部分。
NVLink Fusion 正是為此需求而生,它將 XPU 連接到 NVIDIA 世界領先的 AI 基礎設施,以提高效能、加速上市時間並降低半客製化 AI 工廠的風險。
透過快速縱向擴展釋放 XPU 效能
對於運行兆級參數模型、專家混合架構和代理式 AI 等現代工作負載,如果縱向擴展互連架構無法跟上,利用率就會下降,每個 token 的成本也會隨之上升。
縱向擴展網路解決方案必須在三個維度上表現出色:
實際效能:端到端網路效能、網路內運算和成熟的軟體整合。
工廠韌性:正常運作時間、持續的健康監測與遙測,以及在工廠持續運作時的元件級可維護性。
平台成熟度:透過使用具有大規模部署實績和已實現投資報酬率的成熟技術堆疊,降低營運風險。
舉例來說,NVLink Fusion 將 XPU 帶入 NVIDIA NVLink 的縱向擴展領域。第六代 NVLink 在 72 個 XPU 領域內提供領先的高頻寬、低延遲網路。XPU 到 XPU 傳輸的端到端延遲比基於現成乙太網路的替代解決方案低 3 倍,封包速率則高 10 倍。
對於端到端效能,NVIDIA GB300 NVL72 系統相較於未使用 NVL72 的配置,能提供顯著更高的吞吐量和更好的互動性。未來的 NVLink 路線圖配置將包含多達 1,152 個加速器和共同封裝光學元件的領域。
72 個 GPU 的 NVLink 縱向擴展領域使 GB300 NVL72 能夠比 NVIDIA B300 提供更高的單 GPU 吞吐量和互動性。此結果來自 NVIDIA 的 AI 推論效能基準測試頁面。
NVLink Fusion 還包括 NVIDIA NVLink-C2C,用於將 XPU 連接到 NVIDIA Vera CPU 或其他生態系 CPU,其能源效率比 PCIe 介面高達 6 倍,有助於消除代理式系統中控制與運算之間的障礙。
用於開發和部署的成熟堆疊與生態系
開發客製化 XPU 的團隊往往低估了將 XPU 創新轉化為資料中心部署所需付出的努力和複雜性。這包括:
整合高速 CPU 和縱向擴展介面
採購和驗證縱向擴展網路解決方案
設計運算和交換器托盤
設計和驗證機櫃架構,包括散熱和供電
整合安全和儲存
管理複雜的供應商生態系
理想的平台應提供所有這些功能,讓團隊能專注於目標創新,同時使用經過驗證的解決方案處理其餘部分。
NVLink Fusion 獲得一個專為快速開發、整合和部署而設計的生態系支援,涵蓋 ASIC 設計、CPU 以及 IP 和光學互連合作夥伴。
Intel 資料中心晶片工程副總裁兼總經理 Tim Wilson 表示:「NVLink Fusion 讓客戶能夠選擇最符合其工作負載需求的 CPU 架構、效能水準和軟體功能。」
NVLink Fusion 的採用者還可以使用 NVIDIA MGX 機櫃級架構以及用於 MGX 系統(例如 NVIDIA Vera Rubin NVL72)的相同供應鏈。製造合作夥伴負責設計和整合,而 MGX 供應商則提供機櫃、散熱、供電和新興 800 VDC 設計的建構模組。
QCT 和廣達電腦產品與解決方案負責人 Jack Luoh 表示:「透過 Vera Rubin [NVL72],我們正在實現製造線上系統建構的近乎 100% 自動化。如果 XPU 利用 NVLink Fusion,這些投資大部分都可以重複利用。」
透過基礎設施標準化管理風險
AI 工廠規劃不會等待晶片。電力採購、設施設計、散熱、機櫃佈局和網路架構早在最終加速器組合可用之前就已開始。鎖定單一晶片的資料中心可能會帶來排程風險。
不同的工作負載可能偏好不同的加速器,包括 XPU、GPU、CPU 和 LPU。GPU 系統可以與半客製化系統並行運作,用於訓練、後訓練、推論、檢索和服務。
MediaTek 企業資深副總裁兼資料中心與運算事業群總經理 Vince Hu 表示:「NVLink Fusion 計畫的價值在於……客戶可以部署他們的機櫃級解決方案與 NVIDIA GPU,然後他們可以將 XPU 的開發解耦並以不同的速度進行。」
NVLink Fusion 透過統一架構解決了這些挑戰。基於 XPU 和 GPU 的系統(例如 Vera Rubin NVL72)可以共用機櫃佔用空間、網路、散熱、供電和管理系統。營運商可以繼續進行建置,同時延後精確的晶片組合決策,然後隨著工作負載需求、晶片供應和業務優先順序的變化重新配置容量。
創意電子 (GUC) 董事長兼策略長莊理哲表示:「NVLink Fusion 允許超大規模資料中心業者或客製化 ASIC 設計師整合他們自己的客製化 CPU 或 XPU,並將 NVIDIA 技術與第三方製程橋接,以創建統一的機櫃級架構。」
作為工廠設計、驗證和營運
工廠建置成本高昂,錯誤可能導致昂貴的返工。基礎設施必須在施工開始前進行驗證。NVLink Fusion 與 NVIDIA DSX AI 工廠參考架構保持一致:共同設計建築、供電、散熱、運算和網路。NVIDIA Omniverse DSX AI 工廠藍圖提供數位分身和開放參考設計,適用於十億瓦級 AI 工廠,使合作夥伴能夠在部署前共同模擬設施和技術。
在機櫃層面,可維護性是效能的一部分。參考運算托盤採用 100% 液冷,沒有風扇、纜線或軟管,並允許在機櫃其餘部分保持運作的情況下移除托盤。NVLink 交換器托盤也採用液冷,並支援在維修期間持續運作。
Amazon 旗下 Annapurna Labs 資深硬體開發經理 CC Lee 表示:「透過 NVLink Fusion,我們可以使用經過驗證的 NVL72 機櫃設計來縮短上市時間,並且我們可以接觸到多個供應商,幫助我們為客戶提供更多產品。」
軟體完善了工廠。NVIDIA NCCL 用於分散式工作負載,NVIDIA Dynamo 和 NIXL 用於解耦,NVIDIA Mission Control 用於叢集管理、遙測和除錯,這些都有助於營運商將混合 AI 基礎設施作為一個協調系統來運行。
透過 NVLink Fusion,XPU 現在可以與世界級的 AI 平台結合,使超大規模資料中心業者和 AI 原生公司能夠建構統一的半客製化 AI 工廠,將眾多開發者的優勢整合到任何單一公司都無法獨自建構的基礎設施中。
覺得值得一看?分享給朋友。
以上為 AI 自動翻譯導讀。原文版權歸 NVIDIA Blog 所有, 建議透過「閱讀原文」前往原始網站,以取得最完整資訊並支持原作者。
43 個來源、每 2 小時更新,太多看不完。電子報每週挑最值得看的幾則,附上 Max 的看法。


