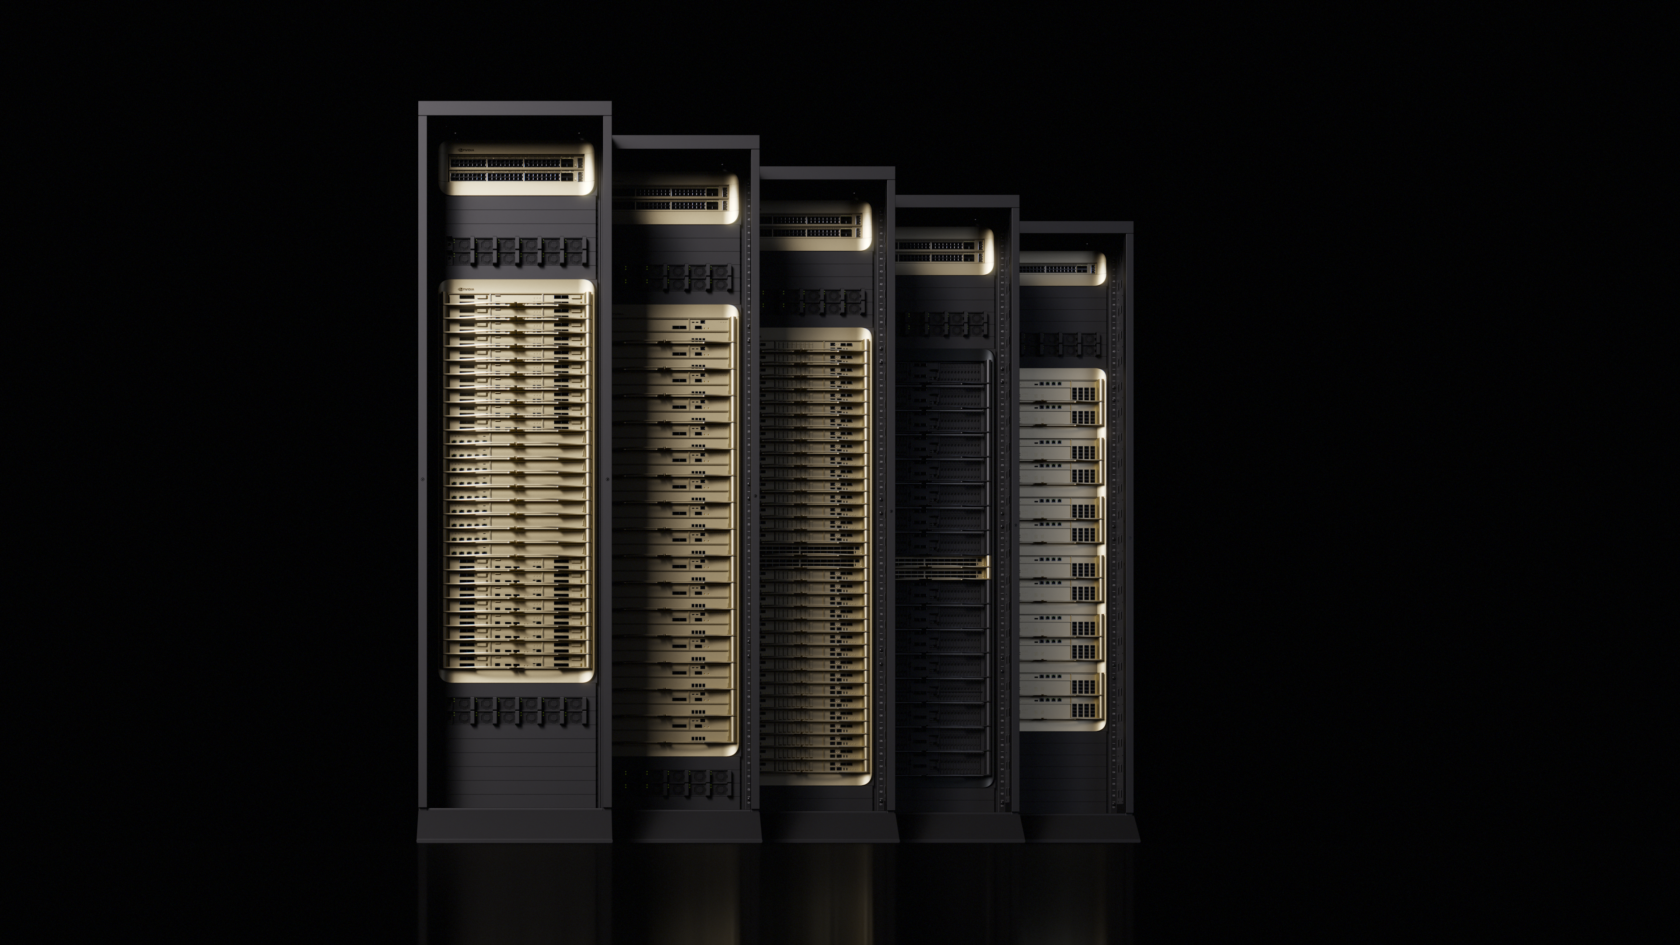
下一代 AI 推論的定義,將不再是單一突破性的晶片、網路或系統。它將取決於 AI 工廠的每個層面如何協同運作。因此,NVIDIA 正透過為 AI 代理系統提供快速 token 生成能力,來擴展其 Vera Rubin NVL72 平台。
NVIDIA 今天宣布,其 Vera Rubin 機架級系統中的 NVIDIA Groq 3 LPX 已全面量產。在 Artificial Analysis 針對開源 AI 代理模型 Gemma 4 31B 進行的基準測試中,Groq 3 LPX 在對 AI 代理系統至關重要的 10 萬 token 長上下文使用案例中,每秒可輸出 3,400 個 token,比最接近的替代平台快上四倍。
全球產業合作夥伴正積極採用 Vera Rubin 平台解決方案。SpaceXAI 宣布其下一代 AI 代理將由 NVIDIA Vera CPU 驅動。CoreWeave 已將 Spectrum-X Multiplane 投入生產,該技術透過多個平行交換器連接 NVIDIA Vera Rubin 機架,提供高頻寬、扁平且無損的 AI 網路。
Nebius 則是首家採用 NVIDIA Groq 3 LPX 的 AI 雲端服務商。
隨著 AI 從訓練轉向推理和代理應用,推論已成為新的前沿領域。AI 代理系統正在生成更多 token,處理顯著更大的上下文視窗,並日益與其他 AI 系統協作以解決複雜問題。這些工作負載需要一種新型的基礎設施,不僅要優化性能,還要以前所未有的規模優化吞吐量、回應速度和經濟效益。
本週在加州帕羅奧圖舉行的 Hot Chips 大會上,NVIDIA 展示了極致協同設計如何從端到端重塑 AI 工廠。透過將運算、網路和推論加速設計為統一系統,NVIDIA 正在協助客戶建立專為長上下文推論和多代理系統新興需求而設計的基礎設施。
極致協同設計優化性能是 NVIDIA 平台背後的指導原則。Vera Rubin 旨在加速 AI 代理在處理日益增長的長序列時的推論能力。NVIDIA Spectrum-X Ethernet 能在 AI 工廠中高效傳輸這些龐大的資料流,而 NVIDIA Groq 3 LPX 則專為超高速生成 token 而設計。
它們共同展示了 NVIDIA 如何將 AI 管線的每個階段,從上下文處理、通訊到生成,都作為單一整合的 AI 工廠架構的一部分進行優化。
NVIDIA Groq 3 LPX 帶來了全新的低延遲推論架構,旨在與最通用的 AI 工廠平台 Vera Rubin NVL72 協同運作。它協助企業和雲端服務供應商,為 AI 代理應用提供所需的低延遲、極致吞吐量和可擴展的經濟效益。突破性的性能並非來自於單獨優化個別元件,而是來自於堆疊中每一層的協同設計。
從網路和上下文處理到大規模推論,NVIDIA 的全端平台將 AI 工廠轉變為整合的智慧引擎,旨在將不斷增長的 token 量轉化為收益。
NVIDIA 合作夥伴採用 Vera Rubin 以實現最低 Token 成本。領先的 AI 雲端服務商 Nebius 率先採用 NVIDIA Groq 3 LPX,讓開發者能夠以領先的 token 生成速度,開發高回應性的 AI 代理應用程式。
將 NVIDIA Groq 3 LPX 加入 Nebius Token Factory 的 NVIDIA Vera Rubin NVL72 系統,將大幅提升推論性能。這讓開發者能夠大規模建構高度互動的 AI 代理、程式碼系統及其他即時 AI 體驗。
CoreWeave 正在生產環境中部署 Spectrum-X Multiplane,連接 NVIDIA Vera Rubin 機架,為其 AI 雲端基礎設施帶來進一步的突破。
SpaceXAI 採用 NVIDIA Vera CPU 支援 AI 代理。SpaceXAI 計劃圍繞 NVIDIA Vera Rubin 建立並擴展其未來的 AI 架構,範圍涵蓋地球上的資料中心乃至軌道衛星。該公司計劃部署 NVIDIA Vera CPU,以加速 AI 代理背後 CPU 密集型的工作,包括編排、工具使用、程式碼執行、資料處理和模擬。
SpaceXAI 的合作夥伴關係將 NVIDIA 的全端 AI 平台擴展至 SpaceXAI,結合了 Vera CPU、NVIDIA 加速運算、網路和軟體,以前所未有的規模推動 AI 進步。Vera Rubin 專為 AI 代理時代設計,提供領先的單核心性能、卓越的記憶體頻寬和負載下的可預測性能,協助 AI 代理更快完成任務,並充分利用寶貴的 GPU 基礎設施。
NVIDIA Groq 3 LPX 是一款互動式 AI 推論加速器,與 Vera Rubin NVL72 平台協同設計。它正協助 AI 工廠以最低延遲為 AI 代理工作負載提供 token。AI 代理正在帶來新的性能挑戰:解碼延遲。當 AI 代理進行推理、使用工具並與其他系統互動時,它們會一次生成一個 token 的回應,即使是微小的延遲也會在複雜的工作鏈中累積。
為了讓 AI 代理以使用者期望的速度運作,NVIDIA Groq 3 LPX 透過專門的 token 生成加速功能,擴展了 Vera Rubin NVL72 平台。
NVIDIA Rubin GPU 負責大規模上下文處理,而 LPX 則加速對延遲敏感的解碼工作負載。這帶來了更快、更可預測的 token 生成,協助 AI 工廠實現回應式推理、更流暢的 AI 代理互動和更高的基礎設施效率。Rubin GPU 和 LPU 協同設計,旨在消除速度與吞吐量之間的傳統權衡,協助 AI 供應商為下一代 AI 代理應用提供回應式、大規模的推論。
打造 Token 工廠。隨著產業從模型訓練轉向大規模提供智慧服務,基礎設施必須演變成 NVIDIA 所描述的「token 工廠」,能夠同時提供性能、吞吐量、智慧完整性和經濟效率。AI 代理系統日益與其他 AI 系統通訊、存取多個資料來源並維護大量上下文,這對快速推論產生了前所未有的需求。
NVIDIA Groq 3 LPX 正是為這些工作負載而設計。作為 Vera Rubin NVL72 的擴展,它即使在龐大的上下文視窗下也能實現超快速回應,同時協助服務供應商最大化吞吐量和基礎設施利用率。
推論的極致協同設計。與獨立加速器不同,NVIDIA Groq 3 LPX 透過極致協同設計結合了 GPU 和 LPU 的優勢。Rubin GPU 和 LPU 共同運算 AI 模型的每一層,為 AI 代理工作負載實現了新的推論性能水平。在大規模部署中,LPU 群組作為一個針對確定性推論優化的巨型處理器運作。
一個機架級的 NVIDIA Groq 3 LPX 部署可以包含 256 個透過晶片間直接連結連接的 LP30 加速器,為現代 AI 工廠打造了一個高效的推論引擎。
為 AI 代理時代而設計。隨著推理模型不斷增長,AI 代理工作流程生成越來越多的 token,支援它們所需的基礎設施也必須隨之演進。NVIDIA Groq 3 LPX 透過專為最大化回應速度、吞吐量和效率而設計的推論架構,擴展了 Vera Rubin NVL72 平台,助力下一代 AI 工廠。
這僅僅是個開始,當與 Vera Rubin NVL72 搭配使用時,將會有更多的優化、更多的模型和更高的性能,新的吞吐量和互動性水平即將到來。敬請期待。
NVIDIA Spectrum-X Multiplane 實現扁平、更具彈性的網路,支援大規模 AI 工廠。隨著 AI 工廠規模日益龐大,網路已成為性能的關鍵引擎。在 Hot Chips 大會上,NVIDIA 聚焦展示 Spectrum-X Multiplane,這是硬體加速 Spectrum-X Ethernet 架構的最新成果。
它使 Ethernet 能夠擴展到前所未有的規模,同時避免了增加網路層級所帶來的延遲、抖動和成本。
NVIDIA Spectrum-X Ethernet 被設計為一個端到端、針對 AI 優化的 Ethernet 平台,結合了 NVIDIA Spectrum-X Ethernet 交換器、SuperNIC 和軟體,以提高 AI 工廠和雲端中基於 Ethernet 的 AI 基礎設施的性能和效率。
該平台旨在提供比現成 Ethernet 高 1.6 倍的 AI 網路性能,同時在多租戶環境中提供一致、可預測的性能。
Multiplane 無需新增層級即可實現規模擴展。傳統上,將 AI 工廠擴展到超越當前最大叢集的規模,意味著要增加第三個網路層級。這會增加延遲、導致不可預測的減速,並提高佈線、光纖和電源的成本。Spectrum-X Multiplane 採用更簡單的方法:它將每個伺服器的網路連接分成幾個獨立的路徑,或稱「平面」,每個平面都運行自己的輕量級兩層網路。
結果是一個扁平、簡單的網路,可以擴展到 512,000 個 GPU,而無需增加第三層的成本和複雜性。
這一切都是自動發生的。NVIDIA ConnectX SuperNIC 內部的專用硬體引擎管理跨平面的流量,並在任何故障發生時立即重新路由,因此應用程式和軟體只會看到一個快速、可靠的連接。在八平面拓撲中,如果一個平面發生故障,網路仍能維持約 90% 的總頻寬,且硬體恢復速度比基於軟體的多平面負載平衡快 11 倍。這意味著 AI 工廠的輸出量提高了 1.6 倍。
透過極致協同設計打造。這種可靠性來自於 Vera Rubin NVL72 的極致協同設計,涵蓋了交換器晶片、SuperNIC 和軟體。基於 102.4Tb/s Spectrum-6 Ethernet ASIC 和 ConnectX-9 SuperNIC 的 Spectrum-X SN6000 系列交換器,支援每個 GPU 高達 1,600Gb/s,專為 Vera Rubin NVL72 AI 工廠而設計。
Spectrum-XGS Ethernet 將相同的協同設計擴展到資料中心,讓多個設施作為單一 AI 超級工廠運作,並將多站點 NCCL 集合加速 1.9 倍。
NVIDIA 推出由 BlueField-4 和 DOCA 驅動的 AI 代理工廠 Scale-In 基礎設施。NVIDIA 正在推出 NVIDIA Scale-In,這是 NVIDIA AI 網路的第五大支柱,也是一種新型的 AI 代理工廠加速網路基礎設施。
Scale-In 將專用加速功能擴展到保護、管理和營運 AI 工廠的基礎設施服務。由 NVIDIA BlueField-4 處理器和 NVIDIA DOCA 軟體平台驅動,並透過 NVIDIA Spectrum-X Ethernet 連接,NVIDIA Scale-In 將傳統的南北向存取網路轉變為統一的加速基礎設施領域。
雲端運算為資料中心帶來了軟體定義網路、可組合性和彈性,使用戶、應用程式、資料和服務能夠動態擴展。AI 代理代表著下一個平台轉變。AI 工廠將大規模加速運算與日益增長的使用者、應用程式和自主代理結合在一起,所有這些都持續與資料、儲存和服務互動。這改變了對實現 AI 的基礎設施的需求。網路、儲存、網路安全和營運現在必須與 AI 運算一起加速,將軟體定義的靈活性與專用硬體加速和全端協同設計相結合。
NVIDIA Scale-In 提供多租戶網路、高效能儲存存取、晶片內安全、彈性配置和即時可觀察性,同時保持基礎設施處理獨立於主機運算資源。透過將這些服務作為 AI 工廠的一部分進行加速和協同設計,Scale-In 協助安全、資料存取和營運與 AI 運算同步擴展。其結果是安全、高效且可管理的共享基礎設施,用於大規模部署和營運 AI 代理。
NVIDIA NVLink Fusion 連接 XPU


