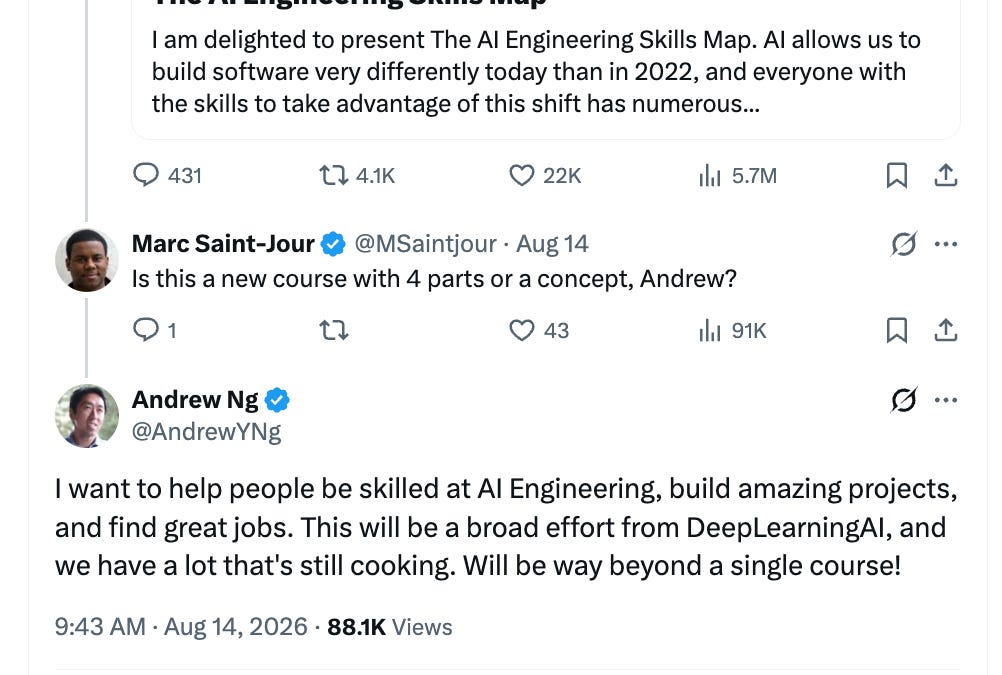
自從「AI 工程師崛起」一文發表以來,我們已經數不清 AI 普及達成了多少里程碑,但 Google Brain 和 Coursera 的共同創辦人吳恩達(Andrew Ng)重新啟動 DeepLearning.AI,並將重點放在 AI 工程上,這無疑是一個重要的里程碑。
這項轉變是透過「分析超過一萬份職位發布;對 AI 專家、招聘經理和招募人員進行數十次結構化訪談;透過問卷調查收集數據;並綜合其他線上數據」所完成的。
根據吳恩達的說法,以下是 AI 工程師最重要的四項技能:
你可以閱讀他的完整文章以獲取更多第一手資訊,但我們同意「AI 工程技能」廣泛適用於不只那些職稱為「AI 工程師」的人,這是一個富有洞察力的焦點。
以下是對這四項技能的評論:
建構與部署 AI 應用程式:「擅長建構和部署 AI 應用程式的人,理解 AI 的基本組成部分(例如 LLM、情境工程、RAG、代理工作流程、機器學習和深度學習),更重要的是,他們知道如何使用統計技術來衡量、引導和管理 AI 系統,使其行為更具可預測性。其中一項核心技能是知道如何推動嚴謹的評估和錯誤分析循環。」
沒錯,這部分最接近傳統的 MLE/MLOps 工作流程,從「零梯度」(即提示詞工程技術)到代理協調工程,再到微調及其他,一直到像 Harvey 等人現在正在做的,建構自己的代理實驗室。
軟體工程基礎:「理解軟體基礎知識能讓你辨識出哪些權衡取捨是存在的。這有助於在選擇軟體堆疊、設計系統架構、設計資料儲存、測試等方面做出更好的決策。它也能帶來比經驗不足的開發者更好的結果,那些開發者憑感覺編寫解決方案,卻不知道他們的程式碼代理正在做出哪些權衡,這些權衡通常很糟糕,因為他們不知道該給程式碼代理提供什麼情境。」
沒錯,這部分最接近傳統的 SWE 工作流程。LLM 獎勵專業知識,它們大大提升了高技能開發者的上限,遠超過提升低技能「憑感覺編碼者」的下限,儘管兩者都有所改進。
使用程式碼代理:「有效使用代理程式碼現在是每個開發者的關鍵技能。當你擁有這項技能時,你對代理程式的運作方式有良好的心智模型。你了解它們的限制以及如何克服這些限制,並能夠快速引導它們,知道何時介入以及何時放手,以建構穩健的軟體,而不會浪費過多的時間或 token。
你還需要知道如何使用清晰的規格(以及何時不需要這樣做)、協調多個協同工作的代理程式,並避免諸如代理程式搞砸你的生產資料庫等陷阱。由於代理程式碼發展迅速,熟練使用程式碼代理不僅意味著了解最前沿的實踐,還意味著有例行公事地嘗試新工具,並隨著最佳實踐的變化而改進你的工作流程。」
當我們在 2023 年首次談論 1000 倍 AI 工程師時,當時 Copilot 是唯一的選擇,這部分是最不明顯的,但顯然已在地平線上。程式碼在 2024-2026 年爆炸性增長,最終 Cursor 實現了 0 到 600 億美元的史詩級增長,Claude Code、Codex、Cognition、Cline 和其他不以 C 開頭的程式碼巨頭也隨之崛起。
在這裡保持靈活是一個優勢,就像警惕那些患有 LLM 精神病、過度追求 token 的人一樣。
塑造建構:「有效的 AI 工程需要具備產品意識,並理解業務情境和客戶目標,這樣你才能參與塑造和推動建構… 利用這個機會需要知道如何推動專案向前發展。例如,知道何時快速建構一個 MVP 以供用戶測試,以及何時放慢速度並花更長時間更仔細地建構。」
這或許是原始文章中唯一沒有預見到的 AI 工程部分;我們在 2024 年世界博覽會中增加了 AI 產品經理(AI PM)軌道,很快又增加了設計工程和其他 AI 工程相關領域,因為界線在兩個方向上都迅速模糊了。
總體而言,DeepLearning.AI 的重點更新非常棒。歡迎 Andrew 和他的團隊!
2026 年 8 月 22 日至 8 月 24 日的 AI 新聞。我們檢查了 12 個 subreddit、544 個 Twitter 帳號,沒有進一步檢查 Discord。AINews 的網站讓你可以搜尋所有過往的議題。提醒一下,AINews 現在是 Latent Space 的一個部分。你可以選擇訂閱/取消訂閱電子郵件頻率!
代理協調器、持久性代理和企業 MCP
協調器設計正成為主要的優化表面:幾篇文章都提出了代理品質越來越受協調器而非僅僅基礎模型影響的觀點。NVIDIA 的新評估工作認為,對代理「技能」的結構性檢查幾乎無法預測其有用性,掃描分數與判斷品質的 Spearman ρ 相關性僅為 0.14,並建議改為測量「技能提升」(Skill Lift):在相同條件下,有或沒有某項技能的情況下執行相同任務,並評估完成工作的差異(@omarsar0 的論文摘要)。
同時,一篇關於 Anthropic 風格協調器的立場文件指出,企業應該標準化使用單一可重複使用的程式碼代理協調器,而不是客製化的編排圖,聲稱協調器的選擇在企業工作中可能比模型的選擇更重要(@dair_ai 的摘要)。
持久性(Persistent)和自我修改代理正從概念轉向開源實作:@andykonwinski 推出了 Headlong,一個開源的「微型協調器」,用於持續思考而非僅按請求運作的持久性代理。該系統將軌跡儲存為 jsonl 檔案的 DAG,保持自我引導的內部循環運行,據報導在 48 分鐘內實現了無人值守的自我偵錯修復;權衡包括每小時 1-2 美元的背景思考成本和偶爾的自我造成的故障。
作為補充,@omarsar0 描述了 exo,一個用於遞歸自我改進的協調器架構,具有僅追加的事件日誌、可交換的執行器和支援快照/回滾的沙盒,明確設計讓代理可以重寫提示詞/工具/記憶體,而不會破壞持久性狀態。總體而言,這些文章表明下一波代理基礎設施的重點是持久性、分支、回滾和持續操作,而不僅僅是更好的提示詞。
MCP 正逐漸成熟為企業基礎設施:Anthropic 推出了針對 MCP 連接器的企業管理身份驗證,透過組織的身份提供者集中授權,因此終端用戶不再需要為 Asana、Atlassian、Canva、Datadog、Figma、Notion、Slack 和 Supabase 等連接器執行單獨的 OAuth(@ClaudeDevs 的公告)。
另外,MCP 路線圖強調即將支援帶有串流/伺服器推送的長時間運行工作負載、用於本地伺服器的 HTTP、用於大型目錄的漸進式發現,以及標準身份/委託權限(@_philschmid 的路線圖摘要)。這彌補了玩具演示和可審計企業部署之間的一個顯著差距。
模型發布、洩漏和競爭定位
Qwen3.8-27B 持續超越其尺寸級別:在 Code Arena: WebDev 中,Qwen3.8-27B 以 1595 分排名第九,是前十名中唯一一個此尺寸級別的模型,僅落後 Qwen3.8-Max 六個名次(@arena 的排行榜更新)。
它在消費產品、品牌/行銷和遊戲類別中也名列前茅。一個相關的開源衍生模型 Carnice-V3-27B 由 @kaiostephens 發布:一個基於 Qwen 的 27B Hermes 代理 SFT,旨在適用於消費級 GPU(3090+),並具有合併的 BF16 和 GGUF 變體。
關於未發布前沿模型的謠言週期加劇:多條推文提及了未發布系統的早期訪問或痕跡:據報導,標記為「claude-melon-eap」和「claude-marshmallow-eap」的 EAP 模型強調 3D/RL 風格的任務,並使用了許多思考 token(@Lentils80 的演示);@kimmonismus 收集了新 Claude 模型、Ox Alpha、Qwen 4 和已確認的 GPT Astra 的跡象;@eliebakouch 聲稱可以訪問一個仍在訓練中的模型,並有公開的 W&B 運行。
將大部分內容視為生態系統信號而非經過驗證的規格,但值得注意的是,現在大部分討論都圍繞著發布前訪問的不對稱性,而不是公開發布,這呼應了 @michael_nielsen 的警告,他指出控制對未發布模型的訪問正成為權力集中的來源。
OpenAI 和 Anthropic 的定位仍在變化:OpenAI 開發者宣布 GPT-5.6 在 Kiro 中可用,並聲稱在 Kiro 的規格驅動環境中,Terra 變體在 Terminal-Bench 2.1 任務中,每次成功任務的成本降低了約 82%(公告)。
OpenAI 還將 GPT-5.6 Sol API 定價降至每百萬輸入 token 4 美元,每百萬輸出 token 20 美元(@kimmonismus 的定價說明),Arena 更新顯示 Sol 和 Luna 正在改變成本/性能的 Pareto 前沿(@arena)。
在 Anthropic 方面,@tenobrus 指出,Opus 系列模型六個多月來沒有明確的升級,儘管外部測試人員報告新的 Claude 變體在中等推理方面表現更強(@kimmonismus)。
推論、基準測試和成本效益
工具延遲重疊正成為協調器級別的關鍵加速:@a1zhang 引入了推測性程式化工具呼叫(sPTC),它在程式碼生成期間預測安全的工具呼叫,並在環境副本中提前啟動它們,使執行與 token 生成重疊。目前報告的改進幅度不大,約 1.0-1.2 倍,但其機制很重要:它將優化從 token 級別的解碼技巧轉移到代理工作流程的管線化。
@lateinteraction 將其與 CPU 推測執行進行比較,強調如果大多數猜測是正確的,則丟棄的工作是可以接受的。
Token 計費和基準測試的衛生狀況仍然混亂:幾篇文章指出了誤導性的報告實踐。@bnjmn_marie 分享了一個 DeepSWE 運行,其中有 918.9M 輸入 token,並澄清其中許多是快取命中,而 @cHHillee 直言不諱地指出,在「token 使用量」中計算快取輸入 token 是「非常愚蠢的」。
在評估方面,@jmbollenbacher 警告說,當一個量化模型在基準測試中超越參考模型時,可能表明是對量化的過度擬合,而不是真正的改進;@xeophon 總結了更廣泛的教訓:修復評估可能比盲目追求高分更重要。
成本標準化的代理基準測試持續重塑模型選擇:Together AI 報告稱,在 100 美元的預算下,GLM-5.3 在 DeepSWE 上完成的工作量是 Fable 5 的 5 倍,大約解決了 17 個任務對比 3 個任務,儘管首次嘗試的性能相似(推文)。
@reach_vb 也報告稱 GPT-5.6 Sol Max 在 DeepSWE v1.1 上達到 72.7% 的成績,每個任務成本為 6.47 美元,而 Fable 5 Max 則為 69.7%,每個任務成本為 21.63 美元。Cline 還比較了 Ox Alpha 和 Fable 在實際錯誤修復上的表現,發現兩者都解決了問題,但 Ox 使用的輸出 token 大約少了 3 倍,這表明在重新驗證與根據第一個結論採取行動方面,其後訓練理念顯著不同(@cline 的比較)。
邊緣 AI 和推論系統
Liquid AI + Artificial Analysis 推出了嚴謹的邊緣裝置基準測試堆疊:@liquidai 發布了 Pipette,一個開源的邊緣裝置推論評估套件,測量模型 + 量化 + 運行時 + 裝置組合的品質、速度、延遲和記憶體,擁有超過 1 萬個經過驗證的結果,涵蓋 35 個模型類別、7 種量化、llama.cpp 運行時和四種裝置。
Artificial Analysis 將其與 iPhone 17 Pro 和 Galaxy S26 Ultra 上的獨立手機級智慧評估配對(完整討論串)。
手機級結果突顯了與雲端評估不同的 Pareto 前沿:在 8 GB 記憶體/16K 上下文的框架下,Nanbeige4.2-3B 和 LFM2.5-2.6B 以 63 分的平均分數位居榜首,其中 LFM2.5-2.6B 在 iPhone 上效率更高(8.0 秒,2.3 GB),而 Nanbeige 則為(21.4 秒,4.0 GB)。
LFM2.5-8B-A1B 和 Ling 3.0 Tiny 等 MoE 設計值得注意,因為它們每個 token 啟動約 1B 參數,使得手機硬體能夠在 6 秒內響應。評估還明確指出,許多「智慧」推理模型表現不佳。

