Nvidia 已將其專用的推論加速器 Groq 3 LPX 投入全面生產。一項獨立基準測試顯示,其在 token 生成方面取得了頂級數據,但專家警告,這項比較方式可能對 Nvidia 有利。
在 Hot Chips 2026 大會上,Nvidia 宣布其 Groq 3 LPX 已進入全面生產階段。Nvidia 將這款晶片稱為「互動式 AI 推論加速器」,它擴展了 Vera Rubin 平台,旨在為代理式 AI 系統提供超快速的 token 生成。Nvidia 表示,這款晶片將於今年稍晚上市。
Nvidia 已將其專為 AI 推論設計的 Groq 3 LPX 加速器投入全面生產,獨立基準測試顯示其在 token 生成方面表現出色。Nvidia 聲稱其速度比 Cerebras 快四倍,然而專家指出,這項比較方式可能對 Nvidia 有利,實際情況更為複雜。
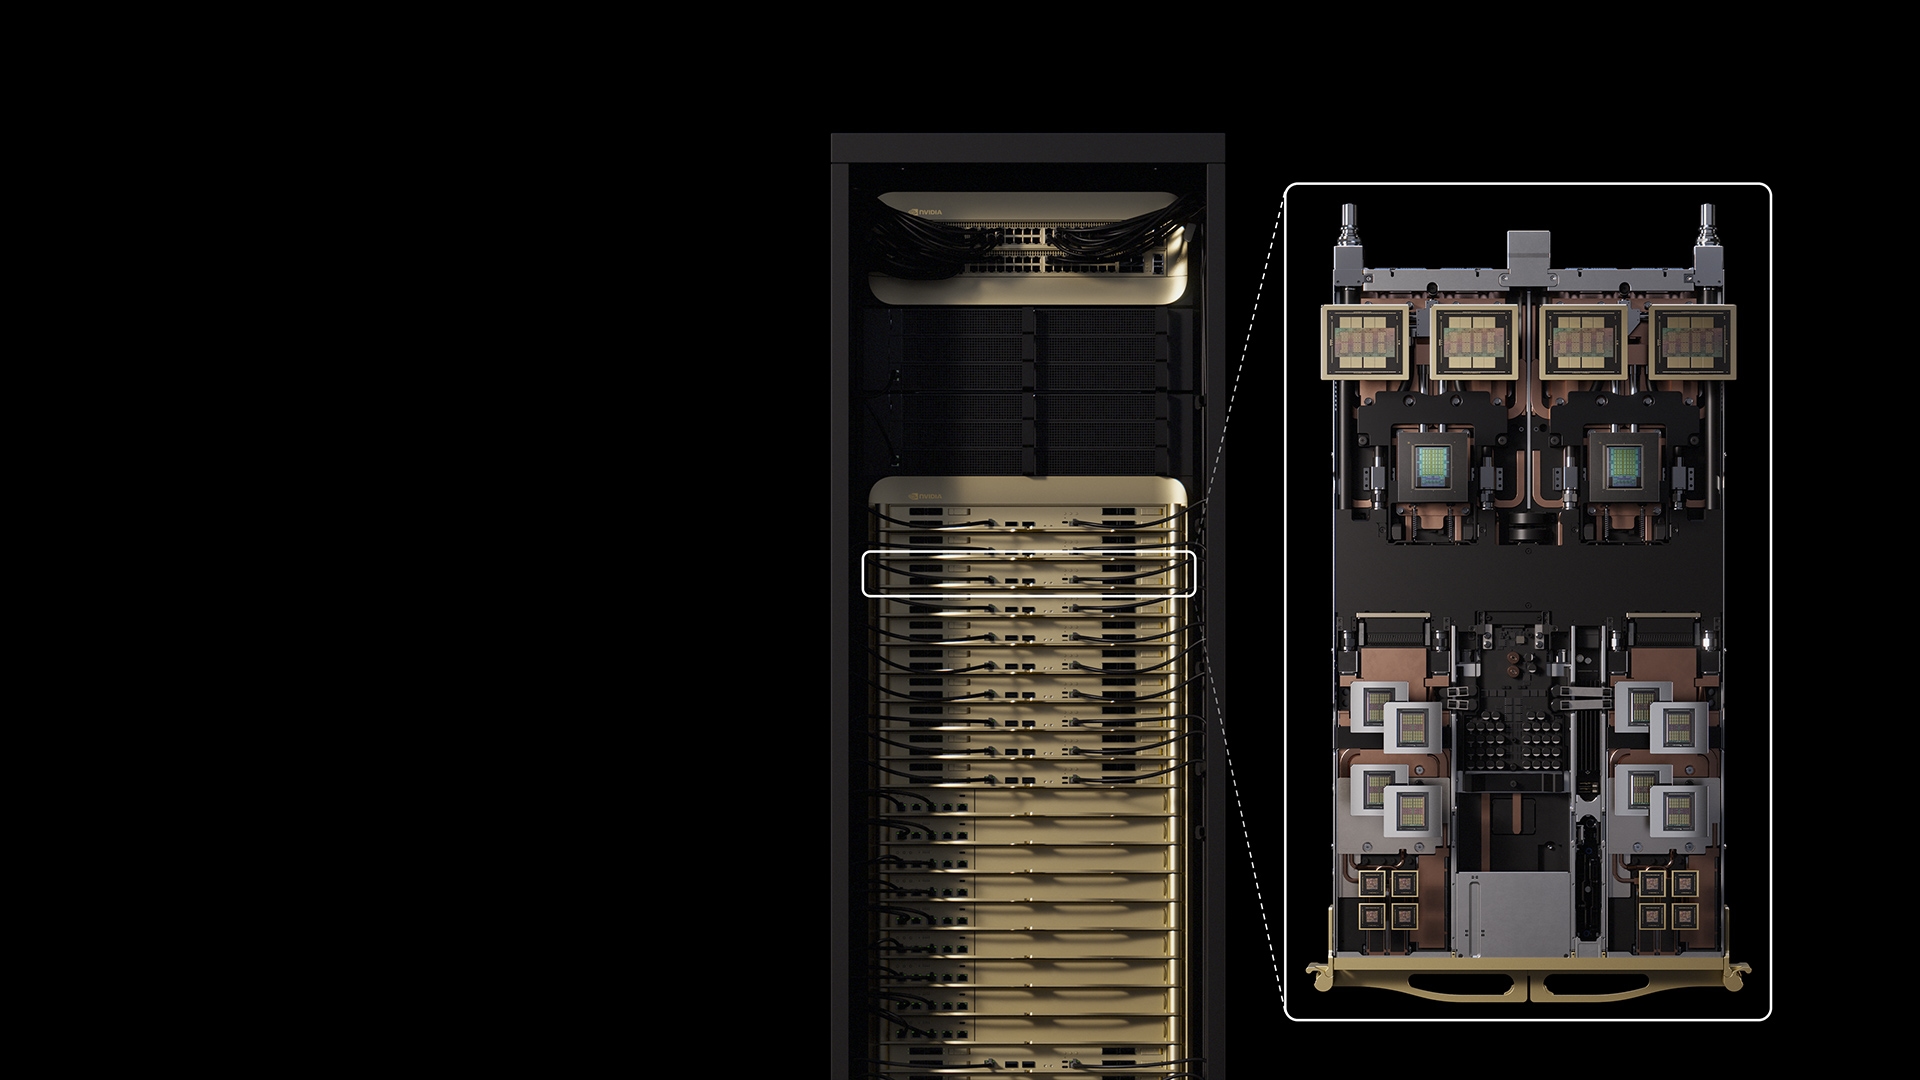
Nvidia 已將其專用的推論加速器 Groq 3 LPX 投入全面生產。一項獨立基準測試顯示,其在 token 生成方面取得了頂級數據,但專家警告,這項比較方式可能對 Nvidia 有利。
在 Hot Chips 2026 大會上,Nvidia 宣布其 Groq 3 LPX 已進入全面生產階段。Nvidia 將這款晶片稱為「互動式 AI 推論加速器」,它擴展了 Vera Rubin 平台,旨在為代理式 AI 系統提供超快速的 token 生成。Nvidia 表示,這款晶片將於今年稍晚上市。
去年 12 月底,Nvidia 以約 200 億美元的價格收購了 Groq 的授權,並延攬了創辦人 Jonathan Ross 和總裁 Sunny Madra。Groq 專門打造針對推論而非 AI 訓練優化的處理器。
對於代理式應用程式而言,速度至關重要,因為代理在數百到數千個推論步驟中會消耗大量的 token。系統生成 token 的速度越快,在相同的時間窗口內就能進行更多的推理步驟和工具呼叫。因此,在使用者可接受的等待時間內,代理可以更頻繁地迭代、檢查檔案、編寫和測試程式碼,並驗證結果。Nvidia 表示,這能將編碼任務從「數小時縮短到數分鐘」。
Artificial Analysis 的一項基準測試旨在展示 Groq 3 LPX 的運行速度:在使用 100,000 token 上下文窗口的開源模型 Gemma 4 31B 上,LPX 機架在 50 個連續請求中達到了每秒 3,400 個 token 的速度。
在 10,000 到 100,000 token 的輸入長度範圍內,性能保持穩定。這是該模型有史以來記錄的最高數字。Nvidia 表示,這使得該加速器比次優選項 Cerebras 晶片(每秒 882 個 token)快四倍。
然而,實際情況下,這項紀錄看起來有所不同。Groq 依賴於一種 SRAM 密集型資料流架構。據 The Register 指出,問題在於每個 LPU 只有 500 MB 的記憶體,比擁有 288 GB 的 Rubin GPU 少了 576 倍。
因此,模型必須透過乙太網路分散到多個加速器上,一個機架最多可容納 256 個 LPU。在這種混合設置中,GPU 處理計算密集型的前置填充(prefill)階段,而 LPU 則處理頻寬密集型的解碼(decode)階段。
The Register 指出,在這種設置下,Gemma 4 31B 是一個最佳案例:一個可以完全容納在一個機架中的密集模型。這種架構如何擴展到更大的專家混合(mixture-of-experts)模型仍是一個懸而未決的問題。例如,DeepSeek V3 將需要 1,342 個加速器,或略多於五個機架。
與 Cerebras 的比較也省略了晶片數量。Cerebras 模型只需要一到兩個加速器,而 Nvidia 則需要至少 64 個。而且,這項比較根本沒有將 Cerebras 最新的 CS-4 世代納入考量。
Nebius 計劃成為第一個透過其 Token Factory 提供這款晶片的雲端服務供應商,而 Groq 本身也是早期使用者之一。
覺得值得一看?分享給朋友。
以上為 AI 自動翻譯導讀。原文版權歸 The Decoder 所有, 建議透過「閱讀原文」前往原始網站,以取得最完整資訊並支持原作者。
43 個來源、每 2 小時更新,太多看不完。電子報每週挑最值得看的幾則,附上 Max 的看法。