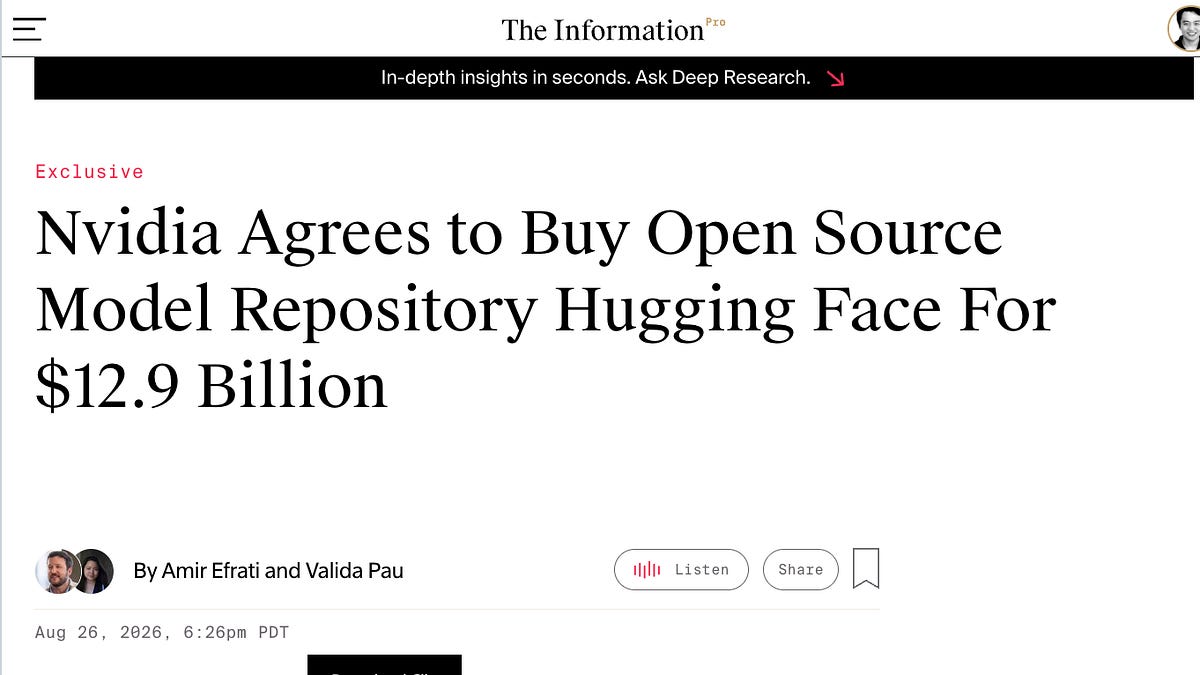
《TheInformation》獨家報導並已證實,NVIDIA 正以 130 億美元收購 HuggingFace。這筆交易約是 HuggingFace 年經常性收入(ARR)1.5 億美元的 80 倍,該公司在 2026 年客戶群翻倍。此收購價幾乎是 NVIDIA 在 2026 年 1 月最初 70 億美元報價的兩倍。
我們能說什麼呢?我們樂見好人獲勝。然而,在 GLM-5.3-Flash(又稱 Ox Alpha)模型令人印象深刻(除了 GDM 上的模糊發文者)以及 Qwen 也在中國晶片上推出令人驚豔的 Flash 模型之際,或許 Hot Chips 大會後關於西方開源 AI 的討論,為這項收購提供了絕佳的背景。
這是 2026 年 8 月 25 日至 26 日的 AI 新聞。我們查閱了 12 個 Reddit 子版塊、544 個 Twitter 帳號,但沒有進一步的 Discord 資訊。AINews 網站提供所有過往刊物的搜尋功能。提醒您,AINews 現已成為 Latent Space 的一個專區,您可以選擇訂閱或取消電子郵件頻率。
頭條新聞:GLM 5.3 Flash 發布與各界反應。
Z.ai 正式發布了 GLM-5.3-Flash 模型,並揭示了先前預覽的「Ox Alpha」模型正是其公開名稱。
Z.ai 宣布 GLM-5.3-Flash 是一個原生多模態模型,擁有 100 萬個 token 的上下文視窗,總參數為 3200 億個,其中 180 億個為活躍參數。該模型以 MIT 授權發布,並可透過模型權重、API、聊天介面、編碼計畫和 AutoClaw 取得。
Z.ai 同時將其定位為 GLM-5.2 極具價格競爭力的繼任者,並在其內部基準測試中聲稱,GLM-5.3-Flash 在所有努力水平上都超越了 GLM-5.2,且在編碼方面與 Claude Opus 4.8 不相上下。
此次發布也解開了長期以來關於 Ox Alpha 的謎團:包括 SemiAnalysis、rasbt、theo 和 Cline 在內的多位發文者明確將 Ox Alpha 與 GLM-5.3-Flash 連結起來。
第三方模型基礎設施支援幾乎立即出現,包括 CoreWeave、Baseten,以及 Cline 在 VS Code、JetBrains 和 CLI 中的免費整合。
發布後不久,Z.ai 工程師 Zixuan Li 表示聊天模板已更新,早期下載者應重新下載模型,這暗示著發布當天的打包或提示詞格式進行了修正。
Artificial Analysis 最初發布的概述中,上下文視窗錯誤地標示為 40 萬個 token,隨後發布更正為 100 萬個 token,與 Z.ai 的原始公告一致。
對於一個開源權重模型的發布,社群反應異常熱烈,從簡短的震驚反應如「天啊」,到更實質性的主張,認為該模型可能是目前性價比最高的智慧選項,例如 Artificial Analysis 和 zainhas 的評論。
此次發布被納入關於中國前沿開源模型的更廣泛敘事中,有文章指出,中國的開源實驗室在線性注意力、稀疏注意力、殘差路徑設計和 Muon 等架構選擇上正趨於一致。
至少有一項模態聲明受到了獨立質疑:skalskip92 認為,儘管該模型被宣稱是「原生視覺」,但在多項視覺/物件偵測任務上表現不佳。
Z.ai 的主要發布推文是事實依據:GLM-5.3-Flash 被描述為:總參數 3200 億 / 活躍參數 180 億;100 萬個 token 上下文;原生多模態;MIT 授權;先前預覽名稱為 Ox Alpha;「完全運行在中國 AI 晶片上」。
發布時的發行/可用性:Hugging Face 上的模型權重;Z.ai API;聊天介面;ZCode 編碼計畫;AutoClaw。
最強的供應商自報性能聲明來自 Z.ai 的編碼討論串:在 Z.ai Code Bench 上,GLM-5.3-Flash「在所有努力水平上都明顯優於 GLM-5.2,並且在編碼方面與 Claude Opus 4.8 表現相當」。由於這是第一方基準測試,雖然有用,但應比獨立評估更謹慎地解讀。
AutoClaw 的後續發布支援文章將該模型定位為適用於視覺語言理解、程式碼生成和長程代理任務,並將其可用性與積分/回扣結合,但這主要是推廣資訊,而非新的技術證據。
推文集中最實質的獨立評估來自 Artificial Analysis。他們的總結是:GLM-5.3-Flash 在 Artificial Analysis 智慧指數上獲得 57 分。
AA 智慧指數得分:57 分;與 GLM-5.3 差距:比 GLM-5.3 的 60 分低 3 分;每任務成本:0.09 美元;API 價格:每 100 萬輸入 token 0.15 美元,每 100 萬輸出 token 0.50 美元;快取輸入:約每 100 萬 token 0.026-0.03 美元,描述為 80% 折扣;模型大小:總參數 3200 億 / 活躍參數 180 億;授權:MIT;上下文:最初列為 40 萬個 token,後更正為 100 萬個 token。
GLM-5.3-Flash 與 GPT-5.6 Terra 和 Muse Spark 1.2 同為 57 分,但每任務成本顯著較低。其每任務成本為 0.09 美元,而 GLM-5.3 最大版本為 0.68 美元。據稱,其每任務成本比 GLM-5.3 最大版本低約 7.5 倍,比 GPT-5.6 Terra 便宜約 5.7 倍,比 Muse Spark 1.2 便宜約 4.4 倍。
Artificial Analysis 指出一個有趣的權衡:GLM-5.3-Flash 在運行智慧指數時使用了 1.49 億個輸出 token,相比之下 GLM-5.3 使用了 1.68 億個。然而,它比 Kimi K3(1.33 億個)和 Qwen3.8 2.4T A95B(1.36 億個)在相似智慧指數得分下使用了更多的 token。
在這 1.49 億個 token 中,有 1.34 億個(約 90%)是推理 token。
這是一個重要的細微之處:該模型的經濟效益看起來很出色,主要原因在於 token 定價極低,而非其特別節省 token。
Artificial Analysis 還報告稱,GLM-5.3-Flash 在代理任務上的表現比其原始知識指標所暗示的更強:GDPval-AA v2 Elo:1770 分,與 GLM-5.3 和 Grok 4.6 在誤差範圍內持平,僅次於 Claude Opus 5 xhigh/max;Terminal-Bench v2.1:84.3%,而 GLM-5.3 為 83.9%;τ³-Banking:47.2%,落後 GLM-5.3 3.1 個百分點;AA-Omniscience 得分:+7;準確度:28%;幻覺率:28%。
與 GLM-5.3 相比:GLM-5.3 準確度 34%,幻覺率 30%。與 GPT-5.6 Terra 相比:Terra 準確度 47%。
這暗示了反應中的一個重複主題:GLM-5.3-Flash 在實際的程式碼/代理工作流程方面可能比在廣泛的真實世界事實知識方面強大得多。
幾項技術性反應試圖逆向工程或總結 GLM-5.2 / GLM-5.x 發生了哪些變化。
推文集中最詳細的公開架構分析來自 rasbt,他表示 GLM-5.3-Flash 從 GLM-5.2 的 7440 億-A400 億骨幹轉變為 3200 億-A180 億,並採用了:Kimi 線性風格的 3:1 混合注意力;34 個 KDA 層(Kimi Delta Attention);11 個 MLA/DSA 層(MLA = Multi-head Latent Attention,DSA = DeepSeek Sparse Attention);DeepSeek V4 風格的 mHC 殘差路徑;四個並行流;以及一個原生視覺編碼器。
同一條推文將其描述為「超級混合」,因為兩個主要的注意力組件本身就已經是「高效」變體,而非簡單的高效/全注意力混合。
thealexker 提供的另一個有用的系統導向總結將此次發布視為一個效率故事,重點指出:與 GLM-5.2 相比,成本約為十分之一;活躍參數從 320 億減少到 180 億;層數從 92 層減少到 45 層;採用混合線性 + 稀疏注意力;每層平均 KV 快取更小;在長上下文中的注意力計算複合效應更低;聲稱視覺智慧受益於編碼/強化學習風格的改進;並表示 GLM-5.3 基礎設施代理協助了核心、瓶頸和服務堆疊優化,共同參與了部分工作。
eliebakouch 的廣泛背景文章雖然帶有觀點,但在技術上值得注意,因為它將 GLM 置於中國開源模型的趨勢中:幾乎所有中國前沿模型現在都使用線性注意力;幾乎所有模型都使用稀疏注意力/索引器壓縮設計;許多模型使用 mHC、注意力殘差、門控殘差等精巧的殘差設計;許多模型使用 Muon。
這篇文章並非 GLM 論文的直接摘要,但它有助於解釋為何這些架構細節立即引起模型工程師的共鳴:GLM-5.3-Flash 似乎是中國前沿開源設計領域中,一個快速收斂於效率優先的另一個例證。
硬體/服務端是此次發布中最受討論的部分之一。
Z.ai 本身表示該模型「完全運行在中國 AI 晶片上」。最強烈的放大效應來自 SemiAnalysis,其重點關注每天有 100 兆個 token 在中國晶片上提供服務的說法。該推文並未提供所有推導過程,但它將這項基礎設施壯舉視為此次揭露中最令人震驚的部分。
各方反應強調了其重要性:theo 表示:「Ox 作為一個『Flash』模型簡直瘋狂。在中國晶片上處理所有流量更是瘋狂。」當天的開源社群情緒文章將 GLM 納入更廣泛的開源慶祝敘事中。
teortaxesTex 也進行了明確的粗略容量估算:如果推理經濟效益與 V4-Flash 相當,那麼每 NPU 每秒 1 萬個 token 是「現實的」。每個晶片每天可處理 8.64 億個 token。每天 100 兆個 token 將意味著約 11.6 萬個晶片,這表明 10 萬個以上晶片的規模是「可行的」,但會消耗總算力的巨大一部分。
這個估計是推測性的,尚未證實,但它顯示了工程師如何解讀這項服務聲明:不僅僅是行銷噱頭,而是一個基礎設施聲明,暗示著非常龐大的國內加速器群和成熟的推理優化。
反應週期中一個值得注意的部分是使用情況貼文出現的速度之快。
Cline 表示,GLM-5.3 Flash 已成為 Cline 歷史上成長最快的模型,在不到一週的時間內帶動了 11% 的總流量,同時也在 Cline 中將其宣傳為免費。這部分是促銷,但也是一個具體的市場需求訊號。
基礎設施供應商迅速採取行動:CoreWeave:「即將在 CoreWeave 無伺服器推理中推出」;Baseten:發布當天即可用,強調通用智慧 + 代理編碼、原生視覺和 100 萬個 token 上下文;Dell 透過 Jeff Boudier:將 GLM 5.3 Flash 和 Qwen 3.8 Flash 定位為可供本地部署的開源模型。
這很重要,因為它強化了 GLM-5.3-Flash 並未被視為一個新奇事物;它立即被整合到實際的推理/開發者堆疊中。
Z.ai 發布了 GLM-5.3-Flash,其總參數為 3200 億 / 活躍參數 180 億,上下文為 100 萬個 token,採用 MIT 授權,為多模態模型,先前預覽名稱為 Ox Alpha。
Z.ai 聲稱該模型運行在中國 AI 晶片上。Artificial Analysis 報告其 AA 智慧指數為 57 分,每任務成本為 0.09 美元,並提供了各種基準測試細節和定價。
Artificial Analysis 後來將其上下文視窗列表從 40 萬個 token 更正為 100 萬個 token。Zixuan Li 表示聊天模板已更新,模型用戶應重新下載。Cline 表示該模型在不到一週的時間內帶動了 11% 的總流量。
Baseten、CoreWeave、AutoClaw 等公司宣布了支援/分發。theo、zephyr_z9 和 nicdunz 表達了強烈的正面驚訝。thealexker 主要將此次發布解讀為一個效率工程的故事。
eliebakouch 將其視為中國前沿開源架構中令人興奮的趨勢匯聚的證據。zainhas 認為它現在是性價比最高的智慧選擇。skalskip92 認為該模型在視覺方面表現不佳,反駁了此次發布的多模態定位。scaling01 指稱 Ox Alpha 是 GLM 模型「顯而易見」,並進一步指控 ZAI 使用了炒作帳號;該說法在推文集中未經證實。


