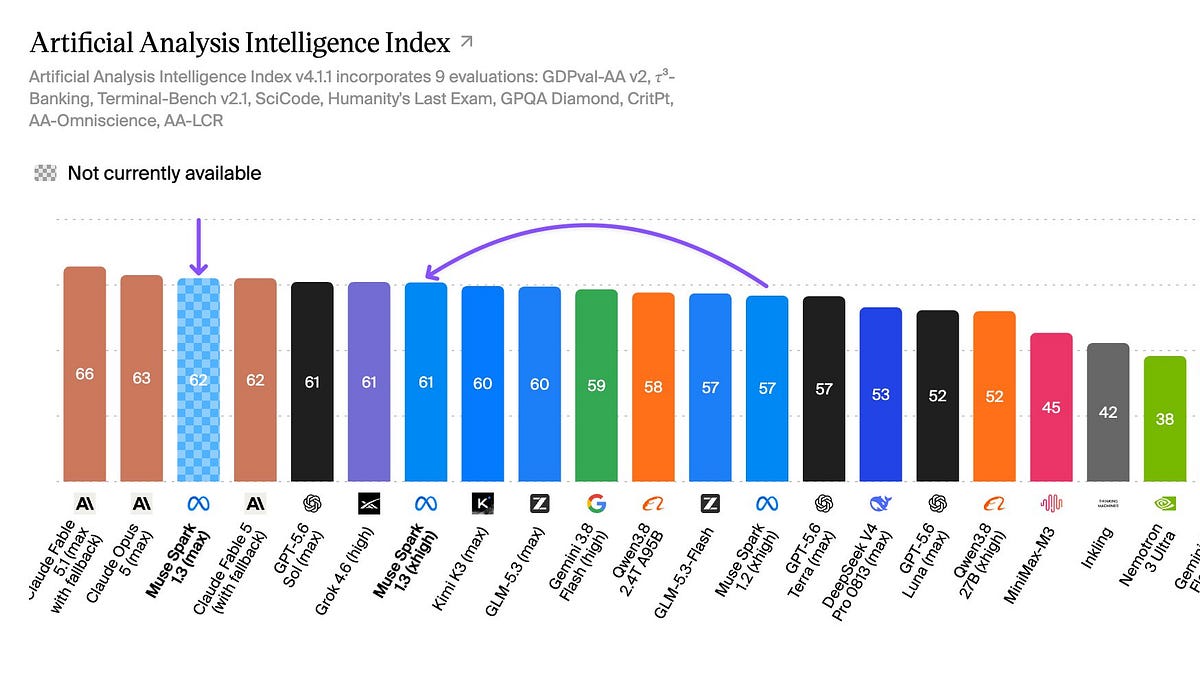
繼昨日 Gemini 3.8 Flash 如期推出後,Meta 的 Muse Spark 1.3 無疑成為今日的頭條新聞。根據 AAII 的報告,Muse Spark 1.3 現已躍居全球第三大模型,其表現已能與 OpenAI 和 Anthropic 的頂尖模型(如 Opus)相媲美,更承諾將開放權重。
Mark Zuckerberg 在社群媒體上宣布,Muse Spark 1.3 今日正式推出,其前沿性能幾乎是超乎想像的便宜。他強調這是 Meta 在編碼和代理工作方面取得的最大進步,並鼓勵用戶在 Muse Code 和其 API 中試用。
Zuckerberg 也預告,Muse Spark 的開放權重版本即將推出。該模型採用了有趣的定價模式,若選擇參與訓練,成本可享九折以上的折扣。
史丹佛大學正將 AI 原生軟體工程正式化為一門學科。Mihail Eric 教授宣布,新版《現代軟體開發者》課程將聚焦於他所稱的「2026 年軟體工程變革」,其中 2025 年秋季課程的 85% 材料將被替換,涵蓋代理技能、上下文工程、MCP 入口、代理就緒程式碼庫設計、代理式程式碼審查、安全、平行背景代理和軟體工廠等主題。
另一門史丹佛課程則專注於從頭建構代理。Diyi Yang 和 Michael Ryan 教授宣布了 CS329Z:AI 代理工程課程,明確圍繞「從零開始」建構代理。這兩門課程共同預示著教學法從單純的「提示詞工程」轉向系統導向的代理工程,更強調框架、評估、記憶、工具、協調和生產限制,而非僅僅模型的使用。
業界討論正聚焦於有狀態的智慧分配,而非簡單的路由。Harry Stebbings 強調 Eno Reyes 的觀點,即要充分利用模型,代理需要理解任務狀態、已發生的事件以及接下來的步驟,才能動態分配智慧。這與 Jerry Liu 的觀點不謀而合,即中立供應商的新創公司可以透過端到端優化框架,並選擇性地使用頂尖和開放權重模型,在特定任務上超越前沿實驗室。
關於模型架構和推論,OpenAI 傳聞中的 Astra 架構被指為「循環式 Transformer」,但 Rasbt 認為這可能沒有標題所暗示的那麼新穎。他解釋說,這種「遞迴深度」或「循環式 Transformer」概念只是一個相對溫和的架構調整,而非突破性創新。
他指出 Nanbeige 4.2-3B 作為開放權重先例,它是一個 22 層的 Transformer 堆疊被重複使用兩次,實際上表現得像一個 44 層模型,但無需加倍參數儲存。其權衡是:記憶體佔用相似,運算量約為兩倍,且 token 效率僅部分保留。
Rasbt 進一步澄清,層次重複使用並不必然「模糊思維鏈」。它只是將更多運算移至潛在激活中,然後才發出 token。如果遞迴深度減少了可見的推理軌跡,那是因為模型可能需要發出更少的中間 token,而不是因為循環式 Transformer 本質上抑制了文本思維鏈。
推論基礎設施持續針對即時多模態工作負載進行更新。Vikhyat 宣布推出 Photon 2.1,為即時多模態推論引擎增加了文字轉語音模型和 NVIDIA B200 支援。此外,Baseten 宣布託管提供 GLM-5.3 Fast,強調更高的 TPS 和透過 Baseten 實現的即時部署定位。
字節跳動 Seed 的 HarnessDev 論文重新定義了代理評估,不僅關注任務完成,更著重於框架本身。Omar Sar 介紹了這篇新論文,該研究要求模型從一個弱但可運行的初始版本開始,建構一個執行框架,然後在第二階段利用下游回饋進行改進。
兩個階段都根據能力和執行 token 成本進行評分,將效率納入目標。在六個創作者大型語言模型、四個領域和 2,207 個保留的下游實例中,生成的框架在程式碼、搜尋和研究方面仍落後於成熟的人工設計系統,但在寫作和機器學習實驗方面則與之匹配或超越。關鍵在於,自我演進的框架有所幫助,但其增益不穩定、依賴於模型,且僅部分可轉移。
相關生態系統信號顯示,exo 框架是理解遞迴式自我改進工作流程的有用切入點,表明人們對代理不僅改進輸出,還改進自身結構的框架越來越感興趣。技能檢索可能在總體上表現良好,但卻可能損害實際觸發它的任務。Dair AI 總結了一篇論文,提出了「檢索觸發實際使用效應」的匹配評估方法,該方法對同一任務進行兩次運行,一次啟用技能,一次不啟用,並且只計算實際觸發檢索的任務。
該論文發現,在 17 個大型語言模型於編碼和數學任務上的測試中,檢索雖然提高了總體分數,但在實際使用檢索的任務子集上卻產生了負面影響。對於維護技能庫或工具目錄的團隊來說,這是一個實用的警示,提醒他們不要過度解讀總體提升。
強化學習後訓練基礎設施正變得更加產品化。SGLang 團隊與 Baseten 和 NVIDIA Dynamo 合作推廣 Miles,這是一個強化學習訓練框架,使用 SGLang 作為推出推論引擎,以實現更快、更可靠的強化學習後訓練。Arav Srinivas 另外將 Miles 描述為開源的「強化學習即服務」,這強化了可重複使用的後訓練堆疊趨勢,而非客製化的內部管線。
Google 推出了專門的網路安全模型 Gemini 3.8 Flash Cyber,並聲稱其基準測試表現強勁。Sundar Pichai 宣布 Gemini 3.8 Flash Cyber 定位為 Google 最強大的網路安全模型,同時保持 Flash 級別的速度和定價。
報告的數據包括 CyberGym 上的 86.2%、CWE-Bench 補丁上的 47.2%,以及在 20 種程式語言的內部漏洞發現基準測試中超過 70% 的成功率。
與此同時,開發者情緒指出 Google 在框架和帳戶風險方面存在問題。Theo 認為 Google 目前在框架、程式碼應用、第三方整合,尤其是與核心 Google 帳戶綁定的激進封鎖方面,開發者體驗不佳。Quinny Pig 進一步強調了這一擔憂,指出影響範圍可能超出 Gmail/Workspace,延伸到與同一身份相關聯的 Google Cloud 帳戶。
Theo 後來對 Gemini 任務中緩慢、大量工具呼叫的編碼行為的抱怨(1, 2, 3)雖然是軼事,但它們突顯了基準測試性能與生產開發者體驗之間的差距。
Meta 推出了 Muse Spark 1.3,專為代理和編碼工作負載設計。Shengjia Zhao 介紹 Muse Spark 1.3 是 Spark 系列中最強大的模型,適用於代理和編碼任務,特別強調更長期的工作和更可靠地遵循複雜指令。
社群反應強調其性價比,包括 Alexandr Wang 稱讚其「一毛錢」的價值,其他用戶則在速度和 token 效率方面將其與競爭對手的「xhigh」產品進行比較。
阿里巴巴的 Wan 3.0 在影片領域的第三方排行榜上表現強勁。Artificial Analysis 報告稱,Wan 3.0 在「帶音訊的影片編輯」中排名第一,在「文字轉帶音訊影片」中排名第二,在「圖片轉帶音訊影片」中排名第五。該版本定位為一體化的生成和編輯模型,可接受文字、圖片、影片、音訊、文件和網頁作為參考,支援原生音訊,並能生成長達 30 秒的 1080p 影片。
公開預覽的定價從 480p 每秒 0.05 美元起,1080p 則為每秒 0.20 美元。
參考密集型多模態使用者體驗也在改進。Imagine 宣布支援每個影片最多 14 個參考,涵蓋圖片、聲音和角色參考,透過提示詞中的 @ 標記實現,這是一個雖小但實用的多資產創意控制介面改進。
開放模型的工作持續擴大。Percy Liang 分享 Marin 535B-A23B 的訓練已完成 13%,運算由 Jen-Hsun 和 Lori Huang 基金會資助,並在 CoreWeave 上運行。這篇文章的重點不在於基準測試,而在於大型開放模型訓練在慈善運算支援下持續可行的趨勢。
實體 AI 和開放機器人平台正逐步推進。Maze Rapid 宣布推出 Palmimo DevKit,這是一個桌面 AI 機器人平台,具有開源軟體和可更換的 AI「大腦」,旨在讓開發者無需深厚的機器人專業知識,只需幾行 Python 程式碼即可控制機器人應用程式。儘管仍處於早期階段,但它作為代理框架擴展到具身系統的一個例子,具有重要意義。
社群討論中,Mark Zuckerberg 的 Muse Spark 1.3 推出貼文截圖顯示,該模型在編碼、代理工作流程和長上下文任務方面有重大改進,並預告 Muse Spark 開放權重「即將推出」。基準測試表將 Muse Spark 1.3 置於 Muse Spark 1.2 之上,並與 GPT 5.6 Sol 和 Opus 5 等模型在代理、長上下文和編碼評估方面競爭。
有用戶指出 Spark 可能對其硬體來說過大,並表示正在等待 Llama 5 或 Glimmer 和 Spark 之間的中間模型。評論者認為這些結果證明多個領先實驗室在技術上正在趨同,有人表示「沒有秘密武器」,前沿差距可能只剩下幾個月。另一位評論者認為 Muse Glimmer 被低估了,並聲稱它在非編碼任務上優於 Qwen 3.8:27B。
評論者還強調了一個異常高的長上下文結果:MRCR 512k–1m 達到 98.1%,有用戶詢問這是否意味著 Muse Spark 有效解決了百萬 token 規模的「上下文衰減」問題。如果準確,該基準測試將是該討論串中最具技術意義的主張,因為在 512k+ 上下文下保持檢索/推理品質仍然是許多開放和閉源模型的主要弱點。
一位用戶報告 Muse Glimmer「相當不錯」,在非編碼任務上主觀優於 Qwen 3 8/27B,這表明 Muse 較小/較早的模型也表現出色。

