AI 工廠以兆瓦甚至吉瓦級的規模建造。每座兆瓦級工廠的成本約為 6,000 萬美元,AI 工廠營運商只有在對投資報酬率有清晰的認識時,才會投入如此規模的資金。有三個關鍵因素決定了 AI 工廠的報酬。
這些因素包括:賺取能力,即工廠若能售出所有可生產的 token,一年內能賺多少;使用壽命,即其 AI 硬體能持續賺取收益多久;以及需求,即市場對這些 token 的需求量有多大。
任何一個環節的弱點都無法完全被其他環節的優勢抵消。如果工廠只能售出其部分產能,那麼再高的賺取能力也意義不大。如果工廠在一年內就停止滿載生產,那麼再高的需求也無濟於事。這三個因素也並非獨立存在。一座能運行更多種類工作負載的工廠,將能找到更多需求,使其年復一年地持續賺取收益。
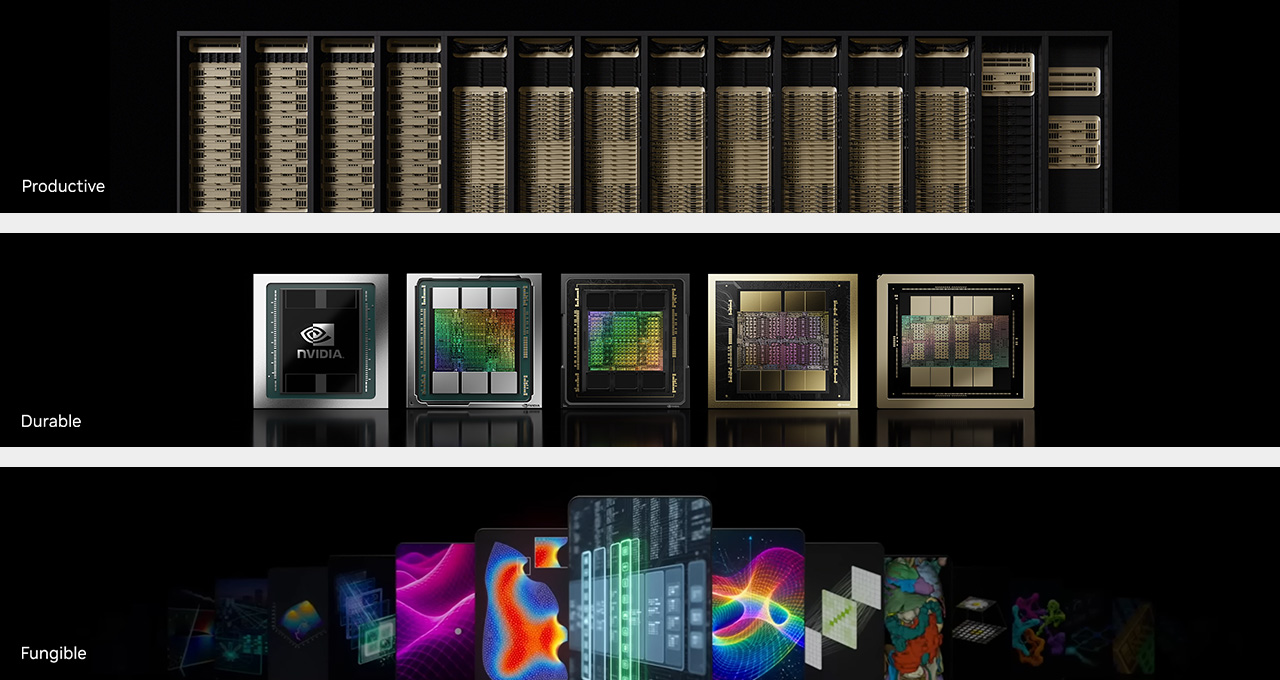
NVIDIA 的 AI 工廠旨在最大化這三個方面。它們具備以下特點:高效生產,提供每兆瓦最高的吞吐量和每個 token 最低的成本,從而最大化其賺取能力。
其次是耐用性,NVIDIA 的 GPU 和系統在出貨多年後仍能持續創造收益,延長了其使用壽命。最後是泛用性,它們能運行所有類型的 AI 工作負載,涵蓋每個階段和每個應用場景,甚至包括許多與 AI 完全無關的工作負載,這加深並拓寬了它們所能服務的需求。
NVIDIA 平台的高效生產、耐用性和泛用性,極大化了 AI 工廠的投資報酬率。透過全堆疊的工程協同設計,最大化了 AI 工廠的吞吐量,而持續的軟體優化則使已安裝的硬體在出貨多年後仍能保持高效。
NVIDIA CUDA-X 函式庫讓工廠能夠運行任何加速工作負載。標準化的架構則讓所有這些功能都可供任何營運商使用,並可從經過驗證的參考設計進行部署。
高效生產:每兆瓦最高 token 數與最低 token 成本。功耗是 AI 工廠的關鍵限制。這使得每兆瓦每秒的 token 數量成為決定賺取能力的關鍵指標。在固定的功耗範圍內產生更多 token 意味著更高的收入。每個 token 成本更低則意味著更高的利潤。
SemiAnalysis AgentX 的數據顯示,NVIDIA Vera Rubin NVL72 系統的每兆瓦吞吐量比 NVIDIA GB300 NVL72 高出 30 倍以上,並且在 DeepSeek V4 Pro 模型上,每百萬 token 的成本降低了高達 45 倍。如此巨大的提升來自於全堆疊的極致協同設計。
這包括從模型和工作負載,到軟體、運算、網路和記憶體,所有這些都經過協同優化。SemiAnalysis AgentX 對 NVIDIA GB300 NVL72 在 GLM 5.3 上的性能進行了分析。
隨之而來有兩個問題。如果每一代產品都讓 token 成本大幅降低,那麼對運算的需求會縮減嗎?答案是不會,它反而會擴大。
更便宜的 token 使更多使用案例變得經濟可行,而這些使用案例所消耗的 token 數量,遠超過效率提升所節省的部分。第二個問題是關於耐用性。如果每一代產品都比上一代好得多,那麼舊世代的產品會怎麼樣呢?
耐用性:已安裝的基礎設施持續賺取收益。並非所有工作負載都需要最新的系統。合適的選擇取決於工作負載的複雜性和類型,這就是為什麼上一代產品在下一代產品推出後仍能持續賺取收益。
NVIDIA A100 GPU 於 2020 年出貨,六年後仍在商業服務中,證明了其持續的經濟價值;CoreWeave 最近將其於 2020 年首次引入的單位的預訂延長至 2029 年。多年來,所有主要營運商都延長了其伺服器的折舊期。
折舊期是對硬體何時停止賺取收益的預估,並且這個預估值不斷向後推移。Sprout 在 2026 年 9 月的分析報告《資料中心 GPU 的生產壽命》追蹤了這個時間表在所有主要營運商之間的變化。
所有主要營運商都延長了伺服器壽命。資料來源:Sprout,《資料中心 GPU 的生產壽命》,2026 年 9 月。數據基於公司披露和 Sprout 編纂的新聞報導。會計壽命是實體壽命的保守估計,例如 Microsoft 的 NVIDIA V100 機隊運行了 8.4 年,而其帳面壽命為六年。
Barkr 根據這些系統的轉售價格,將八個 GPU 的 H100 系統的可用壽命定為五到六年,GB300 NVL72 則為九到十年。Silicon Data 顯示,一個六年歷史的 A100 GPU 仍值其成本的四分之一,而根據五年折舊計畫,它在一年前就應該歸零了。
Ornn Data 發現,市場租用 A100 GPU 的五年合約價格,與一個月合約的價格相差無幾,約為 80%。CUDA 是用於編程 NVIDIA GPU 的軟體平台,它跨世代運行,因此當新架構出現時,營運商已擁有的任何資產都不會被淘汰。
持續的軟體和核心優化不斷提升現有硬體的能力。相同的平台運行機器學習、深度學習、生成式 AI、推理、代理式 AI 和實體 AI。每種新型工作負載都在已安裝的硬體上運行。
這就是泛用性。一個系統能處理的工作種類越多,它能找到工作的時間就越長。
泛用性:每種 AI 類型、每個階段、每個地點。為一種工作建造的工廠,是押注該工作會持續存在。而能運行所有工作的工廠,即使工作內容改變,也能保持有用並持續產生收入。
NVIDIA AI 工廠運行所有類型的 AI 模型,包括開源和專有模型,涵蓋語言、視覺、生物學、物理學和機器人學領域。它們運行每個階段,從資料處理到預訓練、後訓練和推理。它們還在每個地點運行,從超大規模和 AI 雲端到主權計畫、企業資料中心和邊緣。
NVIDIA 平台具有泛用性,可在每個階段和地點運行所有類型的 AI 工作負載。並非所有這些工作都涉及建構和運行 AI 模型。相同的基礎設施也運行資料處理、科學運算、模擬、圖形等。
所有這些工作負載,無論是 AI 還是非 AI,最終都歸結為相同的平行運算。NVIDIA GPU 旨在同時在數千個核心上精確執行這些運算。CUDA 是讓一個晶片能夠模擬光線、摺疊蛋白質並預測下一個 token 的原因。
超過 1,000 個現成的 CUDA-X 函式庫位於其上,涵蓋從深度神經網路、計算光刻和量子電路模擬到向量搜尋和氣候建模的所有內容,並有超過 1,000 萬開發者在其上進行開發。
這就是為什麼 NVIDIA GPU 是通用加速運算,而不是為單一工作負載設計的客製化 ASIC。通用並不意味著泛泛:Tensor Cores 和 Transformer Engine 將 AI 優化硬體整合到可程式化架構中,在一個晶片中實現了專業化和靈活性。一個架構運行所有這些,正是保持高利用率和高回報的原因。
這種多功能性在客戶的生產環境中得到了體現:Lilly 在其擁有 1,016 個 GPU 的內部叢集上建構和運行蛋白質、小分子和基因組學模型,並為其團隊提供聊天機器人和代理式工作流程。
Pinterest 在超大規模雲端上,跨越 14,000 個 GPU(涵蓋 NVIDIA Blackwell、Hopper 和早期架構),進行視覺語言模型的後訓練和部署。Revolut 使用 NVIDIA cuDF 處理數十億筆交易記錄的資料,然後在 AI 雲端上訓練和部署基礎模型。
Runway 在 NVIDIA Hopper 上訓練世界模型,並使用雲端基礎設施在 NVIDIA Blackwell 平台上提供服務。Texas A&M University 在其超級電腦上運行分子模擬和 AI 藥物發現,在 26 個專案和七個機構中,利用率達到 95-98%。
在 AI 之外也是如此。Dassault Systèmes 為 Wichita State 的飛機認證和 Lucid Motors 的車輛設計提供虛擬雙生模擬。Unilever 則透過數位雙生而非實體拍攝來製作產品圖像,將生產成本降低了一半。
這裡列出的例子永遠不會完整,這正是重點所在。NVIDIA AI 工廠的設計旨在實現高效生產、耐用和泛用:產生更多有利可圖的 token、更長的使用壽命和更深廣的需求。這就是它們最大化回報的方式。
欲了解更多關於 NVIDIA AI 工廠的資訊,請收看 NVIDIA 創辦人暨執行長黃仁勳於 10 月 21 日星期三中歐時間上午 11 點在 GTC Berlin 的主題演講。

