自 Anthropic 推出 Haiku 4.5 以來已約一年,期間陸續發布了 Sonnet、Opus 和 Fable 等模型,直到 5.5 版本。Haiku 系列似乎有些被遺忘,尤其是在 OpenAI 推出 Luna 6 以及 Astra 和 Sol 6 之後。然而,Haiku 5.5 的到來是一次受歡迎的更新。
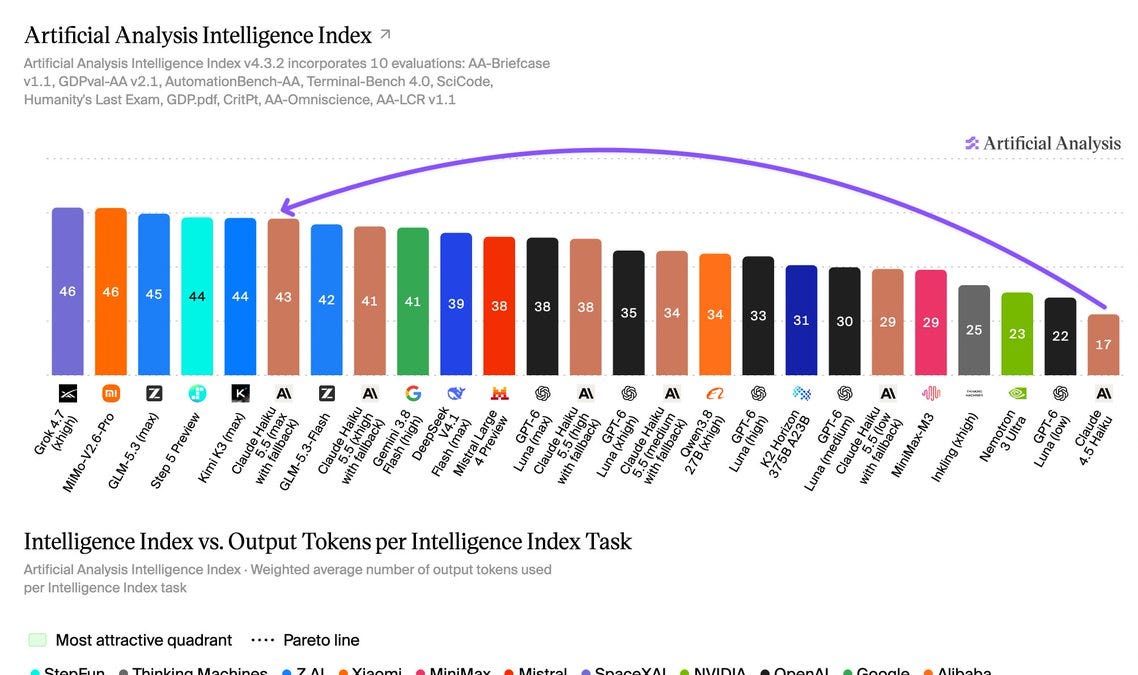
根據 Artificial Analysis 的數據,Anthropic 發布的 Claude Haiku 5.5 在其智慧指數上獲得 43 分,比上次 Haiku 版本發布一年後提升了 26 分。Haiku 5.5 是第一個具備 Anthropic 努力程度設定和自適應思考功能的 Haiku 模型,Anthropic 也同時推出了分級定價。
Anthropic 推出了 Claude Haiku 5.5,這是其 Haiku 系列模型約一年來的首次更新。它的定價與 OpenAI 的 GPT-6 Luna 相同,Anthropic 同日也調降了 Sonnet 5.5 及其訂閱方案的價格。
在正式發布前,社群上已有預兆,例如 @scaling01 發布了「Haiku 5.5 日快樂」的貼文。@kimmonismus 則表示該模型已出現在 Claude Code 更新中,並預測其將採用「Luna 定價」,隨後他在官方發布前確認了定價並在模型上線時再次確認。
@claudeai 和 @AnthropicAI 稱其為「我們發布過最便宜、最快、能力最強的小型模型」,平均運作成本比 Haiku 4.5 降低約 75%。Haiku 5.5 已在 Claude Platform 和 Claude Code 上線,Anthropic 將其定位為與 Opus 5.5 或 Sonnet 5.5 搭配使用的子代理,適用於高用量、成本敏感的工作,例如摘要、壓縮和資料庫查詢。
@mikeyk 形容這種分工為「Opus 負責繁重思考,Haiku 負責高用量工作」。
新的分級定價方案如下:對於 10 萬個 token 以下的提示詞,輸入每百萬 token 費用為 0.10 美元,輸出為 0.50 美元,快取讀取為 0.01 美元。對於超過 10 萬個 token 的提示詞,輸入每百萬 token 費用為 0.50 美元,輸出為 2.50 美元,快取讀取為 0.05 美元。
Sonnet 5.5 的價格也同步調降,快取讀取費用從每百萬 token 0.20 美元減半至 0.10 美元。Anthropic 表示,這使得 Sonnet 5.5 在大多數長時間運行或代理式工作中的成本降低約 20%。訂閱者現在每月可獲得 Claude Platform API 點數,Max 5x 方案為 100 美元,Max 20x 方案為 200 美元,Team 方案最高可達 500 美元(可共用),這些點數適用於所有模型,包括 Haiku 5.5,並可在第三方工具中使用。
Python 和 TypeScript 的 Claude SDK 也同步更新,內建了電腦使用和瀏覽器使用工具集。SDK 現在可以執行動作循環,並將點擊和按鍵操作發送到來自 browser_use、Browserbase、E2B 或 Daytona 的驅動程式,開發者無需再自行編寫該循環。
多個合作夥伴在發布當天即宣布支援 Haiku 5.5。Cursor 聲稱其在較短請求上的成本比 Haiku 4.5 低 10 倍,並發布了 CursorBench 比較結果。GitHub Copilot 在 VS Code 中報告稱,Haiku 5.5 在許多程式編碼任務上與 Claude Sonnet 5 表現相當,但使用了更少的 token 和步驟。
Devin 報告在 FrontierCode 1.1 上達到 58.4%,領先 Sonnet 5,且每項任務成本約為八分之一,並推薦其作為 Opus 5.5 領導下的「副手」。Arena 也將 Haiku 5.5 加入 Agent Arena、Code Arena WebDev、Text、Document 和 Vision,分數待定。OpenDocRouter 也在同日加入支援。
Artificial Analysis 發布了最詳細的第三方數據。在智慧指數方面,Haiku 5.5 在最大努力設定下獲得 43 分,比前一個 Haiku 版本提升了 26 分。這略微領先 GLM-5.3 Flash (42)、Gemini 3.8 Flash (41) 和 GPT-6 Luna (38),並與 2.8 兆參數的開源模型 Kimi K3 (44) 相當,但比最大努力設定下的 Claude Sonnet 5.5 (56) 落後 13 分。
這是第一個具備 Anthropic 努力程度設定和自適應思考功能的 Haiku 模型。然而,token 使用量是主要考量,在最大努力設定下,每個指數任務約使用 162k 輸出 token,大約是 GPT-6 Luna 在最大努力設定下(約 50k)的三倍。
從「xhigh」到「max」的努力程度增加 2 分,但 token 使用量增加約 1.8 倍。即使在相同分數下,Haiku 5.5 仍然更為冗長:Haiku 5.5 在高努力設定下得分 38 分,使用約 55k token,而 Luna 在最大努力設定下得分 38 分,使用約 50k token。
在較低的努力程度設定下,差距會更大。目前的成本數據是暫定的,Artificial Analysis 尚未模擬超過 10 萬 token 的 5 倍價格步驟,任務成本數據將隨後公布。
在 AA-Briefcase(私人代理知識工作評估)中,Haiku 5.5 獲得 1578 Elo 分數,領先 Kimi K3 和 GLM-5.3,與 Muse Spark 1.3 在最大努力設定下相當。在 Terminal-Bench 4.0 中,Haiku 5.5 達到 33%,高於 Haiku 4.5 的 0%,與 GLM-5.3 Flash 持平,並領先 Gemini 3.8 Flash (20%) 和 GPT-6 Luna (13%)。
關於知識與幻覺(AA-Omniscience)的評估顯示,Haiku 5.5 的準確度為 36%,幻覺率為 40%。相比之下,Gemini 3.8 Flash 的準確度為 55%,幻覺率為 55%;GPT-6 Luna 的準確度為 44%,幻覺率為 77%。
Haiku 較低的準確度部分原因在於它更願意承認自己不知道。在 AutomationBench-AA 中,Haiku 5.5 獲得 35%,而 Luna、Gemini 3.8 Flash 和 GLM-5.3 Flash 則為 53-60%。
由於發布前的一個安全錯誤導致模型過度拒絕,Anthropic 正在修復此問題,Artificial Analysis 將重新運行評估,預計分數會上升。
Haiku 5.5 的規格包括 1M token 上下文視窗,遠高於 Haiku 4.5 的 200k。它支援文字和圖像輸入,並輸出文字。快取寫入成本為每百萬 token 0.125 美元(超過 10 萬 token 時為 0.625 美元)。
@ShayneRedford 總結了 Anthropic 報告的顯著提升:OSWorld(電腦使用)從 15% 提升到 72%;TerminalBench 從 0% 提升到 39%(這與 Artificial Analysis 獨立測得的 Terminal-Bench 4.0 的 33% 有所不同);知識工作和推理能力提升 10-50%。
在大多數這些方面,Haiku 5.5 都超越了 Luna,並具備 1M 上下文視窗和約 12k 的最大輸出 token。
@alexalbert__(Anthropic)強調 Haiku 4.5 是在 2025 年 10 月 15 日發布的,因此這次比較的時間跨度不到一年。@TheRundownAI 報導稱,Haiku 5.5 在「各種基準測試中」擊敗了 GPT-6 Luna。
在文件解析方面(獨立於 ParseBench 進行),@LoganMarkewich 表示其整體表現接近 Luna,在表格處理上略勝一籌,但在圖表理解方面較差。@jerryjliu0 則指出,每 1,000 頁的成本約為 1.2 美元,以其價格而言,在表格和閱讀順序方面表現良好,但在圖表、語義格式和邊界框方面較弱。
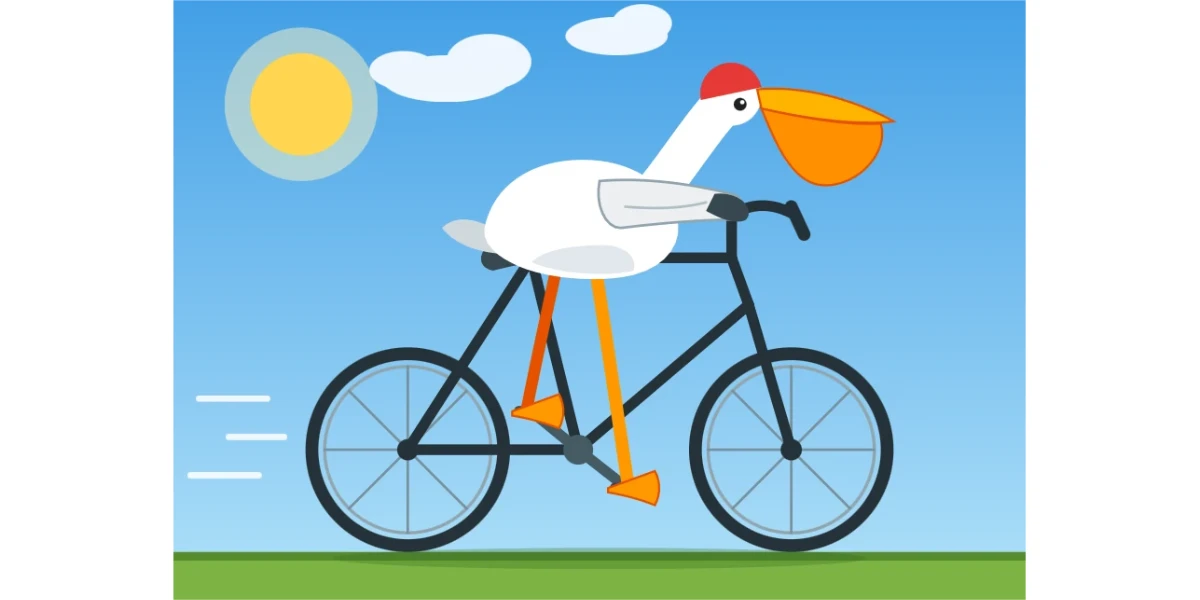
從軼事來看,@simonw 撰寫了定價筆記並進行了他的「pelican-on-a-bicycle」測試,他表示 Haiku 5.5 比成本高 10 倍的 Haiku 4.5「好太多了」。@AI_Screening 則說 Haiku 5.5 在 Three.js 斑馬模擬中「完勝」Luna(單一提示詞,非系統性測試)。
市場反應普遍看好。@kimmonismus 認為 Haiku 5.5「比 GPT-6-Luna 好得多,更接近 Sonnet 5.5… 便宜又聰明」。@theo 喜歡分級定價,認為在 10 萬 token 以下收取五分之一的價格「清楚地表明了模型的用途」。
他也對看到 Anthropic 模型「在成本/智慧圖表上如此偏左」感到驚訝,並在直播中報導了這次發布。@draecomino 評論說:「Haiku 在最大努力設定下的表現就像一個前沿模型」。@kipperrii 認為,小型、便宜的模型現在變得更重要,因為它們可以完成「大量有用的事情」。
@scaling01 稱其「超級便宜」,後來又表示「5.5 模型看起來很不錯」。Anthropic 內部的 @NotTomBrown(「小而強大」)和 @edwinarbus 也發布了慶祝貼文。
這次發布被廣泛解讀為針對 OpenAI 的 GPT-6 Luna:「GPT 6 Luna 完了」(@dejavucoder),「是時候擊敗 Luna 了」(@scaling01)。@kimmonismus 將 Sonnet 快取讀取費用調降解讀為 Anthropic 向 OpenAI 施壓,並在 API 點數方面補充說:「OpenAI:輪到你了」。
@teortaxesTex 認為 Anthropic 現在擁有「所有實驗室中最深厚的產品線」(Haiku/Sonnet/Opus/Fable 加上 Mythos),相對於 OpenAI 的 Luna/Sol/Astra。他仍然認為 Anthropic「不太關心產品」,他將此解讀為 Anthropic 在 2026 年擁有多少餘裕的跡象。
ThursdAI 的 @altryne 質疑中間層級的合理性:「當 Opus 很貴時,Sonnet 才有意義」。該節目計劃報導 Haiku 5.5。
然而,仍有一些注意事項,主要來自數據而非強烈批評。標題上的價格可能誇大了實際節省的費用,因為其大量的 token 使用量(在最大努力設定下約為 Luna 的三倍)部分抵消了每個 token 的折扣。超過 10 萬 token 的提示詞需要支付 5 倍的費用,這對於長上下文代理循環很重要。
這兩個因素可能解釋了 Cursor 聲稱的「短請求便宜 10 倍」與 Anthropic 聲稱的「平均便宜 75%」之間的差異。此外,Haiku 5.5 的事實回憶能力弱於 Gemini 3.8 Flash 和 Luna。目前,過度拒絕的錯誤也降低了自動化分數。
一些基準測試結果尚未公布:Arena 分數仍在等待中,獨立的每任務成本數據也需等待分級定價支援。Haiku 4.5 自 2025 年 10 月以來一直是 Anthropic 的小型模型。此後,OpenAI 的 GPT-6 Luna、Gemini 3.8 Flash、GLM-5.3 Flash 和 DeepSeek V4.1 Flash 都在低成本市場競爭。
Haiku 5.5 精確地匹配了 Luna 的標價,並增加了努力程度控制和 1M 上下文視窗。它被明確定位為多模型代理系統中的廉價工作者,例如 Claude Code 子代理、Devin Fusion、Copilot 子代理,以及壓縮或摘要步驟。
Anthropic 將其與 Sonnet 快取讀取費用調降和訂閱 API 點數結合,這是一項針對代理經濟的協同推動。這項推動正值關於 token 費用更廣泛辯論之際。