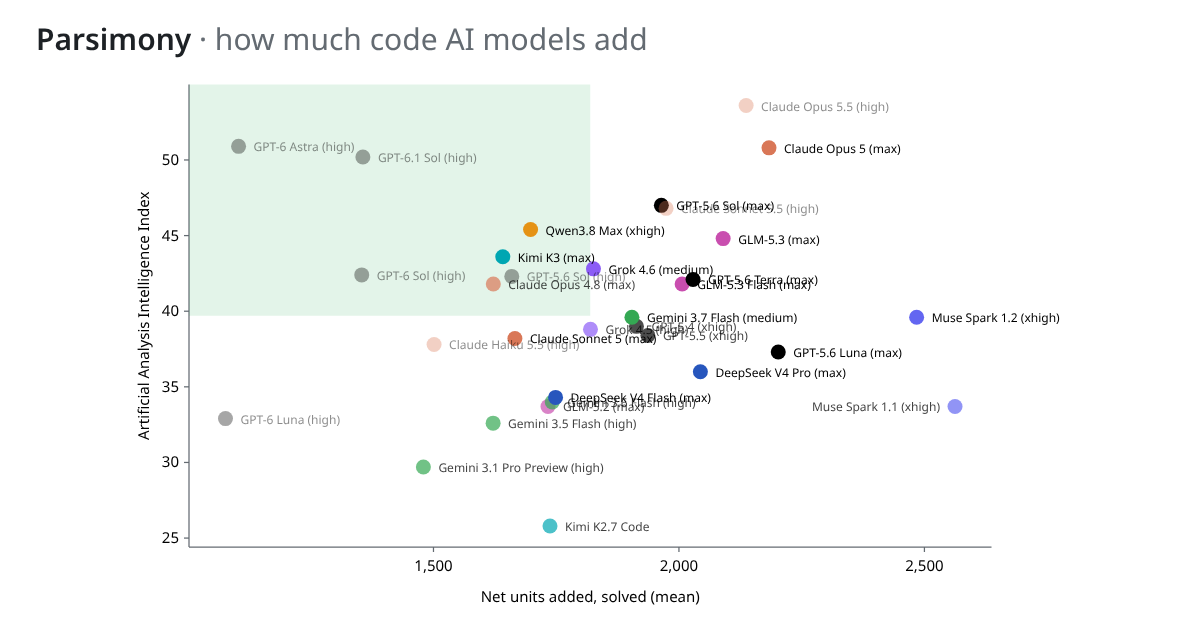
現有的基準測試主要衡量問題解決率和 token 輸出/成本,但卻沒有懲罰過多的程式碼。過多的程式碼會讓程式碼庫在長期維護上變得更加困難。我希望能夠衡量這項指標,因為它對於長期專案來說至關重要。
Parsimony 的方法是利用現有基準測試(如 DeepSWE、SWE-bench Verified 和 SWE-bench Live)已發布的修補程式,並計算「程式碼單元」。這些單元包括語法元素,例如語句、呼叫、名稱和字面值。我沒有使用程式碼行數,因此不會獎勵程式碼的堆疊。已刪除的程式碼會被扣除,因此它衡量的是淨單元數。
由於 GPT-6 和 Claude 5.5 尚未有公開的修補程式,我使用自己的訂閱服務,針對 3 到 10 個任務自行執行了測試(結果顯示為淺色圓圈,未參與排名)。我們歡迎任何回饋或模型貢獻,特別是針對較新模型的公開修補程式匯出。GitHub 連結為:https://github.com/La5u/Parsimony。本專案與任何現有基準測試均無關聯。