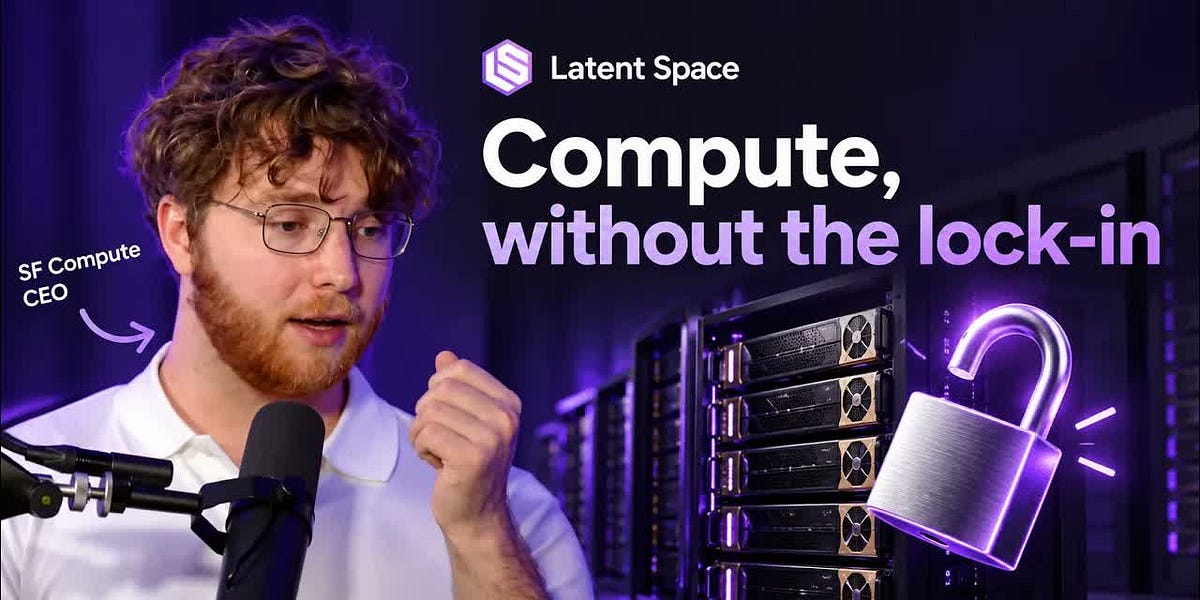
在雲端運算的早期,前來賓 Martin Casado 創造了一項顛覆性技術,讓 Cisco 願意出價 6 億美元收購,而 VMware 更以 13 億美元競標:那就是軟體定義網路(software-defined networking),它透過將控制層與資料層分離,實現了路由網路的虛擬化。
如今,這場革命正降臨到 GPU 領域。過去,建立自己的超級運算叢集需要預付 5,000 萬至 1 億美元,才能從硬體、韌體到核心完成整個堆疊;現在,SF Compute 不僅讓您能夠買賣當前及未來的 GPU 使用時數,還能以程式化方式控制從網路到記憶體的一切。
我們上次與 Evan 談論了算力的商品化。在 AI Engineer New York 活動中,我們深入探討:實際交付 GPU 合約需要什麼?以及在算力市場變得流動之前,必須具備哪些條件?
Evan 以飯店類比來描述 SF Compute 的擴張。客戶想要一個房間,然後要求清潔、客房服務和安全。最終你會發現,交付房間意味著營運整間飯店。SF Compute 最初嘗試轉租一個叢集,但此後公司已經建立了大部分類似雲端的營運能力,以交付其市場上交易的算力。
這項工作就是「實物交割」:買方獲得可用的算力,而不僅僅是針對指數的現金支付。它將叢集的物理限制帶入市場本身。一個工作負載是否可以中斷?它從儲存中恢復的速度有多快?它需要哪一代 GPU、網路和軟體配置?這些細節都會影響合約和價格。
SF Compute 並沒有等待所有 GPU 叢集變得可互換,而是將訂單與不同的限制條件進行匹配。Evan 認為,這使得在技術不斷變化的同時進行交易成為可能,代價是流動性分散到更多的變體上。我們也討論了現貨和遠期定價、批次與即時推論,以及為何指數可能與實際購買算力的成本脫節。
獨立性是 Evan 提出市場營運商論點的核心。他認為,擁有龐大硬體或推論業務的公司,其動機使其難以營運一個中立的交易所。我們也深入探討了那些不那麼光鮮亮麗的工程工作:現場考察、設計叢集、營運背板,以及使基礎設施可程式化。接近尾聲時,他將即時細分 InfiniBand 網路結構的能力作為一個例子。
NVIDIA 顯然是這個領域的巨頭,但他們為何不建立 SF Compute 這樣的平台?我們的看法是,NVIDIA 無法建立它,但從它的存在中受益匪淺。他們無法建立的原因是,他們將無法保持足夠的獨立性,讓大家在其上進行交易。
目前算力市場的成熟度、深度和流動性還不高。我們首先必須上線大量的供應,這需要時間,然後再建立整個平台來實現這一切。現在我們已經讓它運作起來,並將容量轉移到訂單簿上,使其具有流動性。
目前我們總容量的 5% 在訂單簿上,並且持續有更多容量移入,同時我們也引入更多完全在訂單簿上的容量。好處是,雖然實際訂單簿上的交易量很小,但其流動性很高。對於這小部分容量,流動性非常集中。一個標準的衡量標準是,客戶向我們購買容量並花費 100 美元,平均可以從轉售給他人中賺回 25 美元。這是我們追蹤的指標之一,因為我們希望流動性對商業參與者有用。至於合約標準化,目前仍遙遙無期。