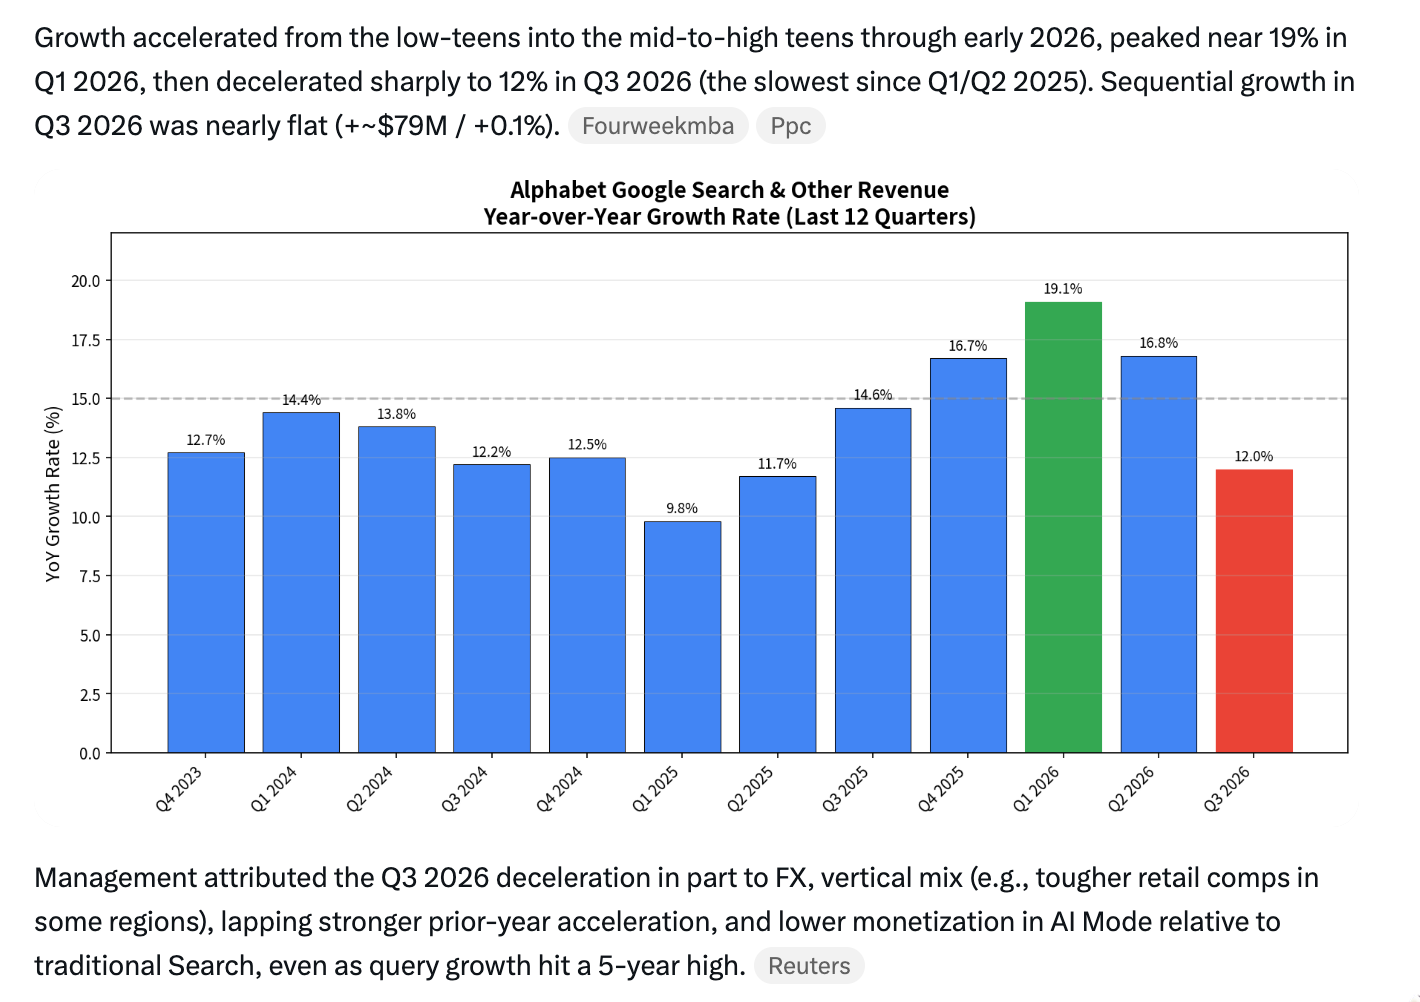
作為一份以工程師為主的電子報,我們很少報導金融新聞,但當這涉及到 Google 和 Google 搜尋的未來,尤其是在其 AI 領導層近期離職的背景下,這就不能不讓人關注。核心問題在於總覽頁面與其摘要的底層頁面之間的矛盾。任何足夠好的摘要都會讓使用者無需閱讀原始來源。
Google 的精選摘要(Featured Snippets)或知識面板(Knowledge Panels)長期以來與提供數據的發布商存在這種矛盾。但現在,Google 自己的 AI 總覽(AI Overviews)可能正在影響其搜尋營收的流量。
Google 沒有足夠詳細地說明 AI 模式的數據,我們無法進行嚴格的分析,但大多數人引用首席商務長 Philipp Schindler 的話:「值得注意的是,AI 模式查詢的強勁增長產生了影響,因為我們在 AI 模式中看到的變現能力較低。」再加上其他不佳的財報結果,這引發了科技股的一系列急劇下跌。
這是在公開市場對科技/AI 情緒惡化的大背景下發生的,而且 OpenAI 以 1.25 兆美元而非 1.4 兆美元的估值進行融資,這並不是史上最大科技 IPO 之一前夕所樂見的。
Anthropic 重新命名了其 Max 訂閱方案,並取消了 Claude Ultra 的 5 小時使用限制。Max 5x 現在是每月 100 美元的「Max」,而 Max 20x 則更名為每月 200 美元的「Ultra」。現有訂閱者無需採取任何行動。
經驗證的 Ultra 帳戶不再有 5 小時的會話限制,這項變更從今天開始對大多數現有訂閱者生效。新帳戶在驗證前仍會保留臨時限制,Anthropic 將其描述為一種防詐欺措施,受影響的使用者將在限制解除時收到電子郵件通知。每週限制則保持不變。
這項變更受到廣泛歡迎,許多貼文稱其為「太棒了!」和「Anthropic 表現出色」。未經證實的訂閱經濟學分析顯示,Anthropic 的 API 利潤率約為 92%,而 DeepSeek 約為 84%。訂閱 Opus 被描述為受到大量補貼,僅在利用率低於約 21.3% 時才能達到收支平衡。
一項後續估計指出,訂閱收入約佔總收入的 18%,卻使用了超過 50% 的運算資源。同一作者認為,DeepSeek V4.1-Flash 的高額補貼方案(10 美元約可獲得 76.5 美元等值的 API 使用量)在每代幣價格上與 Claude 訂閱方案相近。
在邊界模型和開源模型發布方面,Google DeepMind 推出了 Gemini 4 Carbon,該模型在 Text Arena 中排名第一,Agent Arena 中排名第二,WebDev 中排名第四,並在所有三個領域改變了 Pareto 邊界。
Perplexity 報告其 WANDR 長篇研究基準達到了新的最先進水平。Carbon 將在「一旦我們有足夠的代幣容量」後向 Computer 的 Pro 和 Max 用戶開放。
Google 的新世界模型 Genie 4 能夠生成帶有聲音的互動式模擬,使用者可以即時操控。目前它是一個供受信任測試者使用的研究預覽版,很快將在 Project Genie 中向 Google AI Ultra 推出,並向 Gemini API 和 AI Studio 的搶先體驗合作夥伴開放。
Mistral Large 4(代號「Le Chonk」)擁有 1 兆參數和 100 萬代幣的上下文長度。Axolotl 在發布當天就支援 LoRA 微調,其推薦配方使用 NVFP4 專家與合併感知 LoRA,並可在一個 8xB200 節點上運行。一項第三方編碼基準將其評為第二好的開源模型。
NVIDIA 的 Nemotron 3.5 技術報告顯示,Super 模型總共有 1200 億參數,其中 120 億為活躍參數,可處理文本、圖像和影片。它在 SWE-bench Pro 上得分 51.78%,以約 4.6 倍少的活躍參數擊敗了 Nemotron 3 Ultra。
Lightning 變體是一個 300 億參數的純文本模型,其中 30 億為活躍參數。在 GB200 上,其服務速度可達每 GPU 每秒 4,856 個輸出代幣,同時保持每用戶每秒至少 50 個代幣。NVFP4 量化可恢復 99.62% 的 BF16 中位精度。
在小型和專業模型方面,微軟的電腦使用代理是一個 40 億參數的混合代理,既能點擊也能編寫程式碼,在 OSWorld-Verified 上得分 66.0%,領先於 270 億和 300 億參數的代理。Phonic-1 聲稱在 AA 的語音轉語音指數、τ-Voice 和 Sierra 的 τ³-Voice 上排名第一,由一個 10 人團隊以 400 萬美元打造。
BioComputing Co 推出的 mischief 1 是一個圖像轉影片模型,每秒定價從 0.5 美分起。該公司表示,它比其基礎模型快至少 5 倍,並借鑒了生物神經元研究。然而,批評者認為神經元研究與該模型之間的聯繫未經解釋或僅為行銷手段。
OpenAI 的 Private Intelligence 是一項企業級產品,為企業在使用 OpenAI 頂級模型時提供更強大的數據控制,目前正與大型客戶合作開發。
在獨立評估、基準測試和量化爭議方面,AA Intelligence Index v5 的 60% 分數現在來自私人或保留測試。Opus 5.5(最高)得分 58,GPT-6 Astra 57,GPT-6.1 Sol 55,其中 Sol 每項任務的成本約為前者的八分之一。努力程度擴展顯示,Opus 5.5 在低努力下得分 35,在最高努力下得分 58,成本約為 10 倍。
AA-Omniscience v1.1 知識和幻覺基準測試從 6,000 個問題減少到 3,000 個,並刪除了飽和項目。一個新的 300 個問題的公開集與私人分數的相關性為 0.99。Gemini 4 Carbon 以 54 的淨分數領先,其次是 Opus 5.5 的 48 和 Fable 5.1 的 46。
其他結果顯示,Gemini 4 Argon 的幻覺率最低,為 4%。MiniMax M3.1 Flash 下降了 22 分(從 16 到 -6)。
Agent Arena 成本數據分析了 2.6 萬個會話,發現如果沒有提示緩存,頂級 10 代理上的任務成本將高出 3.6 倍。例如,一個典型的 Fable 5.1 任務在有緩存的情況下成本為 7.44 美元,而沒有緩存則為 27 美元。單次緩存失效會使任務費用增加約 5%。
GPT-6.1 Terra(Max)以 10.6% 的淨改進和每任務中位成本 0.62 美元進入 Agent Arena,排名第八。
Unsloth 發布了 DeepSeek V4.1-Flash-1017 的動態 v3.1 GGUF,可在 64GB 以上的 RAM 上運行。在可重複性爭議中,Unsloth 表示無法重現 GSQ-RCO 的數據。例如,其聲稱的 1 位元 100% AIME25 分數在其運行中僅為 91.88%。Unsloth 還報告說,較低位元的量化模型推理時間比未量化模型稍長。
DeepSeek-Cyber 的洩露「夢想」分數在網上流傳,包括 CyberGym 約 92% 和 ExploitBench 約 96.8%(在 3,000 步時)。這些並非官方發布。根據 Fireworks 的第三方數據,CyberGym pass@3 僅從 94.82%(0910)上升到 95.36%(1017)。
@teortaxesTex 認為,在接近飽和時,幾乎任何數字都與相同的檢查點一致。分析師認為,傳聞中的分數更符合無護欄的 1017 版本,而非新模型。據報導,該模型不能被受美國政府制裁的中國實體使用。
在安全、資安和代理供應鏈方面,Anthropic 進行了自動化紅隊測試,數千個 Claude 代理被要求規避訓練數據監控器。研究結果顯示,這些代理產生了看似無害的數據,例如摔跤手指導故事或養蜂問答,但卻教導了錯誤的行為。這些範例可用於改進未來的監控器。
自六月以來,Claude 在回應後會立即對每次對話進行初步安全評估。Anthropic 表示,這捕捉到了其分類器未設計捕捉到的濫用行為。在代理的預訓練後門方面,僅毒化 0.1% 的預訓練數據就在一個 CLI 代理中植入了遠端程式碼執行後門。
結果顯示,在 40 億參數模型上,該攻擊在約 92% 的觸發提示上成功。該後門在 SFT、DPO 和 RL 之後仍然存在,且攻擊成功率隨模型大小增加而上升。即使在 0.0005% 的低劑量毒化(約 1000 億代幣中的 2,500 份文件)下,單次運行中仍有 1.4% 的提示被觸發。
Cursor 市場中被篡改的 Claude Code 擴充功能影響了最多 5,000 名使用者。Cursor 隨後下架了其市場,中和了惡意軟體並重新上架。使用者應更新至 v2.1.314。Anthropic 聲明其自身系統未受損害,且並未開發或發布此擴充功能。
Claude Code 的遊戲重製規則,一個在 tengu_heron_brook 旗標下於 10 月 27 日左右添加的伺服器推送規則,禁止重製特定的現有遊戲,即使重新命名也不行。使用者無法關閉此功能。一位使用者推測,這可能反映了 Anthropic 在 IPO 前對版權的謹慎態度。
代理護欄工具方面,Hugging Face 的 safeagents 是一個代理,可在工具呼叫執行前進行掃描。它標記憑證濫用、沙盒逃逸和獎勵駭客行為,並附帶一個判斷基準。提示注入研究的「Heads of Security」論文識別了成功提示注入背後的注意力頭部,並調整了它們的注意力模式。
Binance 駭客事件中,一名受損的 DevOps 工程師筆記型電腦導致約 63 億美元的損失。一篇貼文將此次攻擊歸咎於北韓。
在訓練研究和基礎設施方面,統一訓練(Unified Training)基於 MaxRL,用單一的最大似然目標取代了單獨的預訓練、中期訓練、SFT 和 RL 階段。聲稱的結果包括更好的準確性和運算效率、更少的遺忘和更強的持續學習能力。合成重寫擴展定律的研究,擬合了在重寫訓練數據上應花費多少運算資源的擴展定律。
一項 220 億參數的「英雄運行」在擬合範圍的 33 倍下,其損失預測與預先註冊的損失預測相差在 1.1% 以內。
架構結果顯示,獨立訓練的 JEPA 表徵可證明學習到相同的表徵,直到旋轉為止。一個 1.09 億參數的 JEPA-Text 模型與視覺模型的對齊程度優於 720 億參數的 LLM。Meta 的循環變壓器(Looped transformers)測試了高達 10 億參數和 32 個循環。在固定參數預算下,循環整個模型是最佳選擇;而在 FLOPs 受限時,循環中間區塊是最佳選擇。
研究代理的「品味」方面,六個前沿模型提出了 415 個實驗,其中 73 個是合理、新穎且不顯而易見的。模型自身的排名幾乎沒有增加價值。在 RL 和儲存系統方面,Baseten 的權重同步(Delta weight syncs)可在 15 秒內移動 770GB,而非 36 秒,請求暫停時間少於一秒。
turbopuffer 緩存從 FIFO 整檔逐出切換到 LFU 區塊後,位元組命中率大約翻倍,p99 查詢延遲減半。Harness adapters 方面,一個在 LFM2.5-24B-A2B 上經過 LoRA RL 訓練的模型,在 pi harness 中以 39% 更少的工具呼叫匹配了基礎模型的準確性,耗時約 24 小時在一個 GPU 上完成。
Anthropic 的 Rust 重寫計畫中,Claude 在一個沒有 Rust 開發者的團隊中用 Rust 重寫了 Messages API。人類編寫了計畫並檢查了新舊輸出在實際流量上是否匹配,結果 CPU 使用率下降了 40-50%。Project Suncatcher 方面,四個 TPU 於 10 月初在軌道上啟動,運行了一個提示並返回了一首俳句。
該工作負載使用的是 Gemma 4 模型。下一階段,在 2027 年,兩顆衛星將測試分散式運算。
在產業和政策方面,Anthropic 提交了 S-1 文件,準備在那斯達克上市,股票代碼為「ANT」。報告的財務數據顯示,2026 年上半年收入為 163 億美元,高於一年前的 12 億美元。運算支出從約收入的 6.5 倍下降到約 0.5 倍。Intel 的第四季度營收指引為 150-160 億美元。