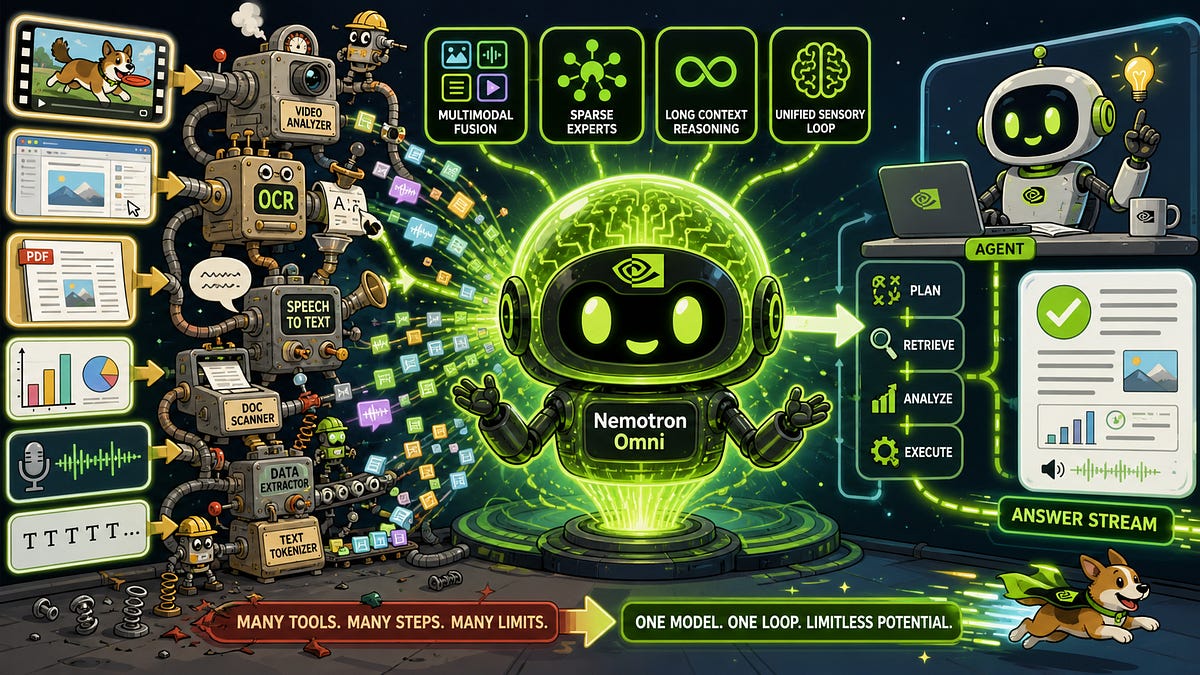
輝達全新 Nemotron 3 Nano Omni 的有趣之處,並非它「具備多模態能力」。我們已經有許多模型能為圖像加上說明、轉錄語音、解析 PDF、回答關於影片的問題,以及在圖形使用者介面(GUI)中操作。Nemotron Omni 的獨特之處在於,它旨在讓這些多樣化的模型感覺像是一個單一的整體。
現今的多模態代理(agent)堆疊,通常像是一台魯布·戈德堡機械:音訊傳送給自動語音辨識(ASR)模型,螢幕截圖傳送給視覺語言模型(VLM),PDF 被渲染成圖像或透過光學字元辨識(OCR)轉換成文字,影片則被取樣成影格,然後由一個語言模型嘗試將這些輸出拼接起來。
模型之間的每個邊界都是一個有損壓縮步驟。語音模型可能聽到「說了什麼」,卻不知道「說話時螢幕上顯示了什麼」。視覺模型可能看到圖表,卻聽不到旁白。規劃器(planner)收到的是一堆摘要,而非連貫的感官串流。Nemotron 3 Nano Omni 是 NVIDIA 嘗試將代理的「眼睛和耳朵」整合到一個單一、高效的感知與推理模型中:輸入視訊、音訊、圖像和文字;輸出文字。
NVIDIA 於 2026 年 4 月 28 日宣布此模型,將其定位為一個開放的全模態推理模型,適用於電腦使用、文件智慧和長影音理解等代理工作流程。


