想像一位專業運動員。頂尖選手之所以脫穎而出,關鍵在於比賽之間的訓練:持續精進、適應新對手,並根據上一場比賽暴露的問題磨練技能。
代理式 AI 的運作方式與此類似。模型不再只是被要求提供答案,而是被賦予一個目標,並必須隨著環境變化、邊緣案例出現和工具更新而持續調整。與回應提示詞的生成式模型不同,代理式模型必須規劃、使用不同的工具,並在運行中遇到問題時進行恢復。
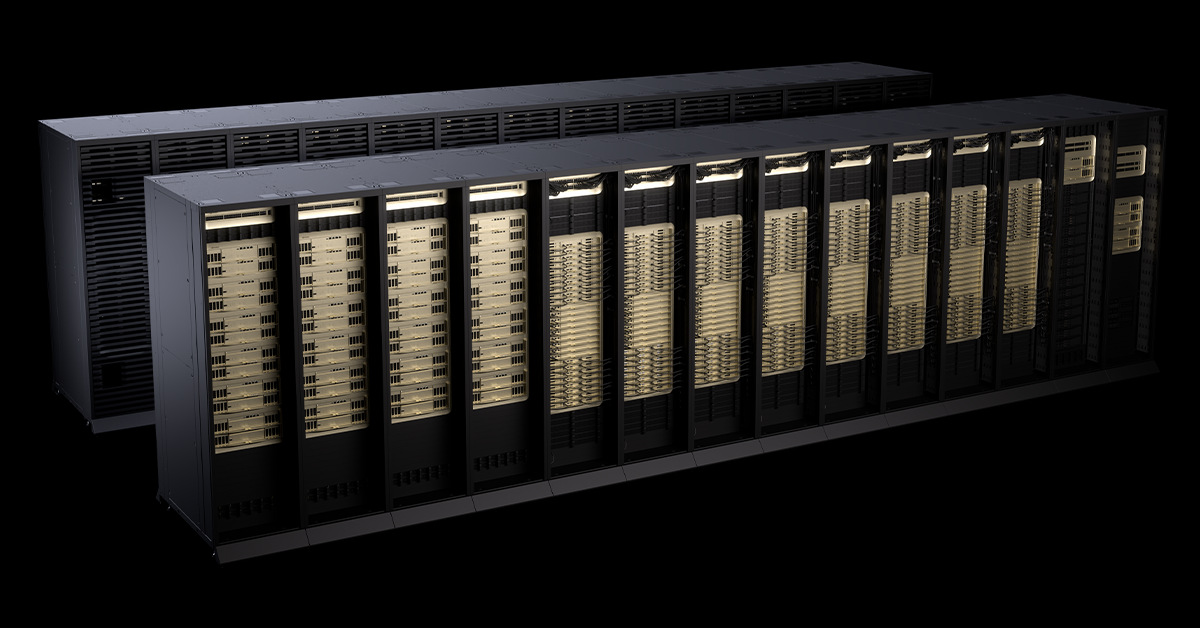
NVIDIA 推出 Vera Rubin 平台,旨在為代理式 AI 的後訓練工作負載最大化「每美元智慧」這一關鍵指標。代理式 AI 需要持續的後訓練來適應快速變化的環境,而 Vera Rubin 平台透過優化運算效率,使這項密集型工作在經濟上更可行。該平台與 Blackwell 等技術結合,能幫助企業高效開發並部署更智能的代理式模型。
想像一位專業運動員。頂尖選手之所以脫穎而出,關鍵在於比賽之間的訓練:持續精進、適應新對手,並根據上一場比賽暴露的問題磨練技能。
代理式 AI 的運作方式與此類似。模型不再只是被要求提供答案,而是被賦予一個目標,並必須隨著環境變化、邊緣案例出現和工具更新而持續調整。與回應提示詞的生成式模型不同,代理式模型必須規劃、使用不同的工具,並在運行中遇到問題時進行恢復。
這就是為什麼「後訓練」(在原始資料上初步訓練後精進模型的階段)不再是一次性的完成步驟。它必須是持續不斷的,因為代理式模型運作的環境變化快速。代理使用的工具可能每週都在變,生產中會出現測試集未曾預料到的邊緣案例。每次部署都有其獨特的程式碼庫、政策和環境。
後訓練會從生產環境中循環回饋,因為新的問題不斷浮現。運算需求增加並非因為單次運行變大,而是因為運行從未停止。代理式 AI 引入了一種新的運算模式用於後訓練,使其成為代理時代的核心工作負載,以及「每美元智慧」(intelligence per dollar)的主要驅動力。
後訓練的目標是透過最大化連續學習週期中每次前向與後向傳播的產出,來最大化「每美元智慧」。前向傳播(推論)以「每代幣成本」(cost per token)衡量。這意味著每代幣成本的任何改進,都會直接轉化為每美元智慧的提升。
後訓練是建立智慧的關鍵。在預訓練階段,模型學習預測下一個代幣,這賦予它流暢性而非智慧。後訓練則是模型學習編寫程式碼、規劃多步驟任務、使用搜尋工具,並在出錯時進行恢復的階段。推論是之後的步驟:模型實際執行任務,其成本以每代幣成本計價。
由於沒有標準答案可供記憶,只有獎勵機制,模型透過強化學習(RL)技術進行學習。當被賦予一項任務時,它會嘗試執行(前向傳播),這與它實際工作時的過程相同。嘗試的結果會被評分,然後根據學習到的經驗更新模型的權重(後向傳播)。經過數百萬次的嘗試,模型的智慧逐漸增長。
每一步都耗費大量運算資源,而大規模運行這個循環是一個協調問題:數千個環境並行產生運行結果,獎勵被驗證,更新後的權重流回訓練,同時加速器得到充分利用。NVIDIA NeMo 開放函式庫,例如用於訓練環境的 NeMo Gym 和用於分散式後訓練的 NeMo RL,將後訓練從客製化的研究程式碼轉變為可重複使用的基礎設施。
為何「每美元智慧」擴展了「每代幣成本」的概念?如果說推論是營收引擎,那麼後訓練就是乘數:模型能力越強,每個服務的代幣價值就越高。
每代幣成本是推論工廠的關鍵指標:提供一百萬個代幣的總成本。而每美元智慧則更上一層,回答了不同的問題:建立一個值得服務的模型,並在環境變化時保持其價值,需要花費多少成本?
這兩者是相互嵌套而非競爭關係。降低每代幣成本的 AI 基礎設施,也能降低模型中每個智慧點的建構成本。而模型中建構的每個智慧點,又會提升推論工廠所服務的每個代幣的價值。
換句話說,每代幣成本衡量的是營運產出;每美元智慧則衡量模型智慧投資是否獲得回報。
最大化每美元智慧:Nemotron 3 Ultra 的後訓練。NVIDIA Nemotron 3 Ultra 是一個開放權重、擁有 5500 億參數的專家混合(MoE)模型,它提供了可驗證的基準測試,以及在 NeMo RL 上運行的完整後訓練配方。
該模型在標準的真實世界程式碼基準測試 SWE-bench 上獲得 71.7% 的分數,這意味著它能為開源專案中大約七成的真實軟體錯誤提供可運行的修復方案,且每個修復都經過專案自身測試的驗證。
根據前一代 Nemotron 3 Super 大約 120 萬次運行(每次約 10,000 個代幣)的經驗,估計 Nemotron 3 Ultra 模型將產生 200 億個運行代幣。不同平台間的每美元智慧與此假設無關;絕對值會隨代幣數量而擴展。
NVIDIA Blackwell 平台降低了每次運行的成本,使代理時代所需的頻繁後訓練在經濟上可行。這種智慧將在每個服務的代幣中獲得回報。
NVIDIA Vera Rubin 平台進一步擴展了這一軌跡,它能以 Blackwell 世代四分之一的 GPU 數量訓練最大的模型。該平台從頭到尾都是為了最大化代理式後訓練負載的每美元智慧而共同設計:每次運行產生更多結果、更多環境參與,以及永不停止的後訓練循環。
Prime Intellect 的實驗室持續在 NVIDIA Blackwell 平台上對前沿開源模型進行後訓練,並使用 NVIDIA Dynamo 進行推論協調。透過 Vera Rubin,Prime Intellect 計劃擴展強化學習環境、在每次運行中產生更多結果,並加速訓練到推論的迭代循環,以最大化企業的每美元智慧。
Prime Intellect 已優化其沙盒基礎設施,以整合 NVIDIA Vera CPU,實現低延遲、高能效的強化學習。開源工具和模型,如 NVIDIA Nemotron 和 NVIDIA NeMo Gym,也整合到其軟體堆疊中。在比較實際的 RL 沙盒工作負載與替代的 x86 架構時,Prime Intellect 發現 Vera 每顆 CPU 平均可提供 30% 更高的吞吐量。
Perplexity 的 RL 後訓練堆疊在數百個 NVIDIA GPU 上非同步運行,其基於 RDMA 的權重傳輸引擎能在不到兩秒內同步訓練與推論運算節點之間數兆參數的模型。經過後訓練的 Qwen3 235B 模型隨後在 NVIDIA GB200 NVL72 系統上提供服務。
Together AI 提供後訓練即服務,包括監督式微調(SFT)、強化學習(RL)和直接偏好優化(DPO)。這項服務透過功能豐富的應用程式介面(API)和軟體開發套件(SDK)在其 AI Native Cloud 平台上提供,支援全面的後訓練。它目前已在 NVIDIA 平台和優化核心函式庫上運行,並期待接下來能利用 Vera Rubin 平台。
深入了解 NVIDIA Vera Rubin 平台,它能幫助 AI 工廠在各種工作負載中最大化每美元智慧。並探索 NVIDIA 用於訓練前沿模型的全端平台。
覺得值得一看?分享給朋友。
以上為 AI 自動翻譯導讀。原文版權歸 NVIDIA Blog 所有, 建議透過「閱讀原文」前往原始網站,以取得最完整資訊並支持原作者。
43 個來源、每 2 小時更新,太多看不完。電子報每週挑最值得看的幾則,附上 Max 的看法。


