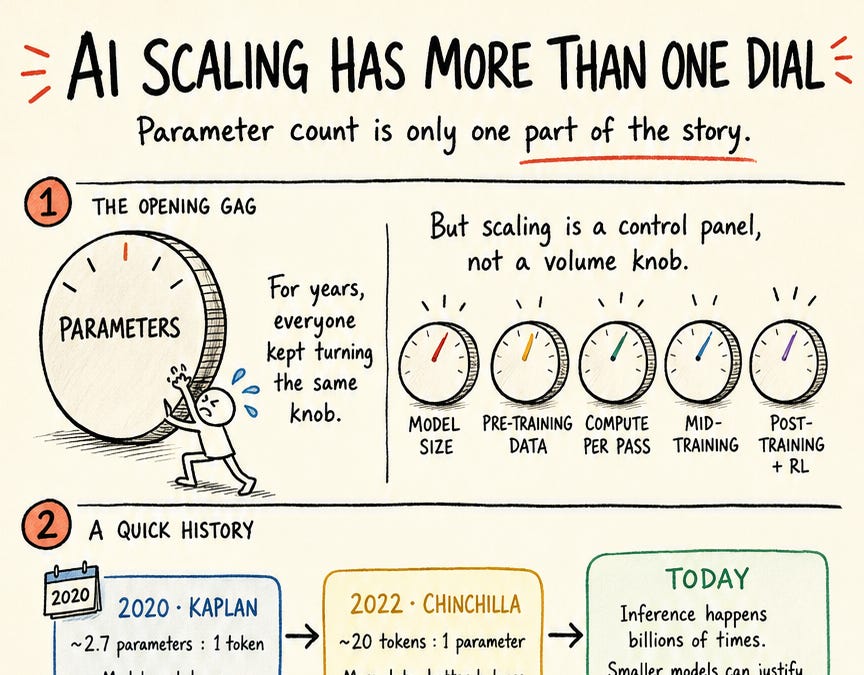
我們之前曾興奮地報導 GLM 5.2,以及唐傑教授關於年底前將出現開源 Fable 級模型的預測。目前距離年底還有 134 天,已有兩款 2-3 兆參數模型(Qwen 3.8 Max 和 Kimi K3)問世,而 Fable 預計為 3-7 兆參數,且在 AA 指數上僅高出 2 分。
唐傑教授在 X 上再次表示,我們衡量模型大小的簡稱已不再足夠。他指出:「參數數量只有與其他三個因素結合時才有意義,你擁有的資料量、你打算投入多少運算資源,以及誰將在什麼條件下運行該模型。」
縮放法則不再僅限於參數。現在每次模型發布,最後總會問到:「有多少參數?」然而,這個問題本身已無法獨立回答。
參數數量只有與資料量、運算資源以及模型運行條件這三個因素結合時,才具有真正的意義。
我們在過去的 Latent Space 報導中曾探討過 Chinchilla(及後 Chinchilla)縮放法則,因此在此省略歷史回顧。然而,釐清為何 Chinchilla 的假設在「推論拐點」世界中不再適用,仍是重要的(例如,每參數的 token 數量並非固定,而是介於 200-900 之間,且依任務而異)。
簡而言之:記憶化傾向於更多參數,而推理則偏好更多的後訓練資料和有效的深度。GLM-5.3 的巨大進步完全來自於在長期環境中的強化學習(RL)。
現在的環境涵蓋了更廣泛的生產工作流程,任務設計模擬了工程師和研究人員實際工作的執行方式。其中一些任務甚至需要經驗豐富的工程師花費數天才能完成。
例如,在機器學習基礎設施任務中,模型可能被賦予與工程師相同的操作環境,可存取運算叢集、儲存系統、內部文件、程式碼庫和實驗結果。它必須診斷訓練堆疊中的瓶頸、實施優化、運行實驗,並在保持正確性的同時,實現可衡量的端到端加速。
在這種層級的環境中進行訓練,促使模型能夠端到端地承擔大量工作,而不是依賴使用者分解問題並監督每個步驟。
對於那些關注遞迴自我改進故事的人來說,他們的整個環境、評估和驗證過程都是完全合成的。隨著代理能力提升,後訓練擴展的許多難點從模型本身轉移到了環境設計上。
一個有用的任務環境必須是可執行、可驗證且接近真實專業工作的,而且我們需要大量的這類環境,而非少數手工建構的。為了擴展這個過程,他們建立了端到端合成環境的管道,對於部分任務,也合成強化學習的獎勵訊號。
研究代理從實際工作中收集任務模式,將其轉化為具有多步驟依賴和隱藏狀態的可運行長期環境;然後,一個評估代理會嘗試每個任務,以驗證其是否確實可解。驗證器在沒有參考解決方案的情況下合成,而求解器軌跡則用於發現並消除獎勵捷徑。
通過預言機、無操作和未解決狀態檢查的驗證器,能夠產生足夠可靠的二元獎勵,可以直接用於訓練。
為了終結對參數數量的執著,唐傑教授提出了五個縮放控制點,其中包括使用新的 XA-YB 符號表示的 MoE 稀疏性。他指出,進階技能(例如,發現軟體漏洞)並非檢索或記憶問題。
這些技能需要模型能夠維持長因果鏈(超過 20 個推論步驟)而不中斷。一旦達到一定的知識儲存閾值,這種能力就不再單純取決於總參數數量。
這是 2026 年 8 月 18 日至 19 日的 AI 新聞。我們檢查了 12 個 Reddit 子版塊、544 個 Twitter 帳號,但沒有進一步的 Discord 資訊。
AINews 網站允許您搜尋所有過往的報導。提醒您,AINews 現已成為 Latent Space 的一個專區,您可以選擇訂閱或取消電子郵件頻率。
開源模型、壓縮與基準測試動態
Ornith-1.5 作為一個重要的全新開源模型系列登場:@ornith_ 在 MIT 授權下發布了 Ornith-1.5,提供 9B 密集型、35B MoE 和 397B MoE 等多種變體,並支援 FP8、GGUF、MLX 和 NVFP4 等量化格式。
其主要亮點是端到端的自我改進能力:模型能夠提出任務、生成框架,並產生強化學習的運行結果以創造新的訓練經驗。在代理和程式碼相關工作負載的評估中,其表現強勁,包括 Terminal-Bench 2.1 達到 86.1 分、SWE-Bench Verified 達到 86 分等。vLLM 和 Ollama 迅速將其整合到服務堆疊中。
模型壓縮技術持續進步,同時仍能保持實用性:@UnslothAI 和 @danielhanchen 發布了使用 Dynamic V3 技術的新版 Qwen3.8-27B GGUF 模型,聲稱在相同大小下準確度提高了約 10%。
他們還推出了 1-bit 量化版本,在 8GB 記憶體下運行時仍能保留約 77% 的 BF16 準確度。他們新的 Divergence-300 指標,透過 Terminal Bench、DeepSWE 和相關任務中未曾見過的範例,擴展了在更長生成序列中的前 1% 貪婪準確度。
代理和法律評估排行榜持續洗牌:@arena 發布了 Agent Arena 的 Pareto 視圖,顯示 Claude Opus 5 (High) 在品質上領先。然而,Kimi K3、GLM 5.2、Grok 4.5 和 GPT-5.6 Luna 等成本較低的模型,則定義了大部分的價值前沿。
另外,@ValsAI 報告指出 Grok 4.6 在 Legal Research Bench 上排名第 3/49,得分 48.1%,支援 50 萬上下文、工具/圖像/檔案,且價格相對較低。對於開源模型,@ValsAI 也強調 GLM 5.3 在 Terminal Bench 上排名第 2、Legal Bench 排名第 3,以及 Skills Bench 排名第 6。
代理框架成為新的競爭層
DeepSeek Harness 的簡約設計是刻意為之,而非不完整:@ZhihuFrontier 擴大報導並由 @TheTuringPost 總結的一篇詳細文章指出,DeepSeek Harness (DSH) 是一個基於名為 Cordis 的插件架構,刻意設計的輕薄外殼。其關鍵設計選擇是將所有功能都視為插件,包括代理循環本身。
據報導,早期測試用戶在一週內發布了 100 多個插件並提交了 400 多個問題;範例從五子棋模型測試平台到透過連接模型與即時查詢執行來關閉 SQL 回饋循環的資料庫代理。最強烈的啟示在於其架構:DSH 更像是一個開放的代理運行時,而非「產品化助理」,它針對使用者可擴展的工具、可替換的控制循環和業務規則注入進行了優化。
TrueFoundry 開源 TrueForge 並明確提出框架成本論點:@truefoundry、@omarsar0 和 @kimmonismus 都報導了 TrueForge 的發布。這是一個 MIT 授權、可自行託管、供應商中立的生產代理框架。
該堆疊包含工具編排、上下文管理、子代理、程式碼沙盒、人工審批和追蹤功能,並支援本地和託管部署模式。其技術主張引起了廣泛共鳴:在 14 項企業基準測試中,TrueForge 在 Opus 4.8 上與 Claude Managed Agents 表現相當,同時使用的 token 減少約 30%;若路由至 GLM-5.2,則在保持準確性的前提下,成本可降低約 75%。
更廣泛的行業主題,也由 @bradenjhancock 和 @dbreunig 透過 @rseroter 呼應,是會話/環境/記憶體/工具層正成為差異化和節省成本的主要來源。
託管框架也獲得了更精準的可觀察性和控制功能:@ClaudeDevs 為自行託管的沙盒增加了記憶體支援、針對網路工具的網域允許/封鎖控制,以及重新設計的多代理會話檢視器,包含迷你地圖、分組對話記錄和每個執行緒/會話的成本顯示。
與此同時,OpenAI 則持續推動相反的方向:為團隊提供框架原語,讓他們將其嵌入到自己的產品中。@OpenAIDevs 強調開源的 Codex 框架是內部工具、營運儀表板和自訂應用程式的運行時,而 @cursor_ai 則推出了圍繞持久目標和長期會話的雲端代理使用者體驗改進。
後訓練、中訓練與強化學習系統工作
更多證據顯示,縮放的重點正從參數轉向訓練配方的品質:@kimmonismus 揭示了 zAI/GLM 創辦人的一項重要主張:進步仍在持續縮放,但過多的討論卻只關注參數數量,而非資料品質、推論運算和後訓練。
所引用的例子是 GLM-5.3,據報導它與 GLM-5.2 採用相同的核心基礎模型/架構,但透過大約一個月的額外強化學習,性能得到了顯著提升。
微軟的 Agent Lightning 指出透過框架進行強化學習是一種實用的方法:@omarsar0 強調了 Agent Lightning v1.0,它透過端點代理將任意框架連接到強化學習。
該系統處理了重新分詞、樣本合併、優勢計算、正規化以及排程器/後端協調等問題。據報導,僅用約 6,000 個訓練範例和適度的運算資源,它就能將 Qwen3.5-9B 在 SWE-Bench Verified 上的表現從 41.8% 提升至 56.4%。
中訓練(mid-training)正被更明確地視為一個優化表面:@cwolferesearch 闡述了當前從業者對 CPT/中訓練的看法:優化資料混合、訓練時長、階段順序、序列長度,甚至後訓練能力,而不僅僅是「繼續用更好的資料進行預訓練」。
這篇文章之所以有用,正是因為它將這些視為相互作用的控制點,而非獨立的技巧。
強化學習基礎設施在研究的底層持續改進:@SergioPaniego 重新提及了一項研究,顯示 TRL 中的在線策略蒸餾透過生成緩衝區、批次教師呼叫和二元對數機率編碼,速度提升了 40 倍。
@mikasenghaas 則宣布 prl 中實現了自適應並行性,能夠在強化學習運行過程中動態調整進行中的運行次數。
基準測試、檢索與生產中重要的基礎設施細節
Qdrant 的可過濾 HNSW 與 ACORN 的比較,是檢索系統的一項實質性更新:@qdrant_engine 認為,過濾後的 ANN 應該在索引中處理,而不僅僅是在查詢時。
他們的可過濾 HNSW 在共享索引酬載值的點之間添加邊緣,保持過濾後的子圖連接。在針對 100 萬個向量進行 1% 過濾的基準測試中,他們報告在 1.0 毫秒內達到 99.8% 的召回率,而 ACORN 在 4.7 毫秒內為 67.7%。他們也指出,ACORN 對於廣泛值和 AND 過濾器仍然有幫助,特別是在已經針對過濾器優化的圖形之上。
Sentence Transformers v6.0 反映了從單向量到多向量檢索的實際轉變:@tomaarsen 清晰地總結了兩者的區別。
密集檢索將每個文本壓縮成一個向量,而多向量檢索則保留 token 級別的向量,並在聚合最佳匹配之前,將查詢 token 與文件 token 進行評分。這很重要,因為對於對品質敏感的搜尋系統而言,後期互動檢索正日益成為預設的權衡選擇。
生產環境中代理的延遲往往與模型本身關係不大:@dair_ai 總結了一篇論文,該論文對十個代理應用程式進行了檢測,發現其中一半的延遲主要由非大型語言模型(LLM)組件造成。
沙盒記憶體峰值達到每個會話 28GB,子系統之間的延遲差異高達 32 倍,並且步驟之間存在長時間的閒置狀態保留。這些優化措施雖然不令人意外,但卻很重要:任務感知服務可將延遲降低 29-40%,狀態卸載可減少記憶體 4.6 倍,而工具結果快取則可消除 35.2% 的冗餘搜尋呼叫。
Linear 和 turbopuffer 顯示向量基礎設施正滲透到非搜尋熱門路徑:@turbopuffer 表示,Linear 已將其增量同步讀取路徑從 Postgres 轉移到 turbopuffer。
透過使用屬性索引進行權限過濾,這項轉變將最大同步時間減少了約 8 秒。
Google、OpenAI、Anthropic 與產品化競賽
Gemini 3.7 Flash 在評估和產品整合方面表現強勁:_philschmid 和 @NewsFromGoogle 強調 Gemini 3.7 Flash 在 Artificial Analysis 的 AA-AnalystAgent 上排名第一。
它在 80 項涉及大量試算表/文件處理的量化任務中,達到 60.0% 的 pass^5、70.5% 的 pass@1、77.5% 的 pass@5,平均每任務耗時 1.32 秒,成本為 0.54 美元。Google 也將其更深入地整合到產品介面中,例如 Gemini 聊天和 Spark,以及基於搜尋的互動式模擬。

