「AI 對齊」
51 resultsImport AI 478:AI 對齊數學、程式碼生成與模型開發新進展
研究Import AI
用 Claude Code 打造十分鐘 AI 影片:實作與挑戰
AI 自動化DEV Community (Claude Code)
AI 新聞速覽:Meta 開源模型、前沿模型更新與推論硬體新進展
產品Latent SpaceAI 可解釋性重大突破:代理模型挑戰多義性,強化對齊研究
研究Latent Space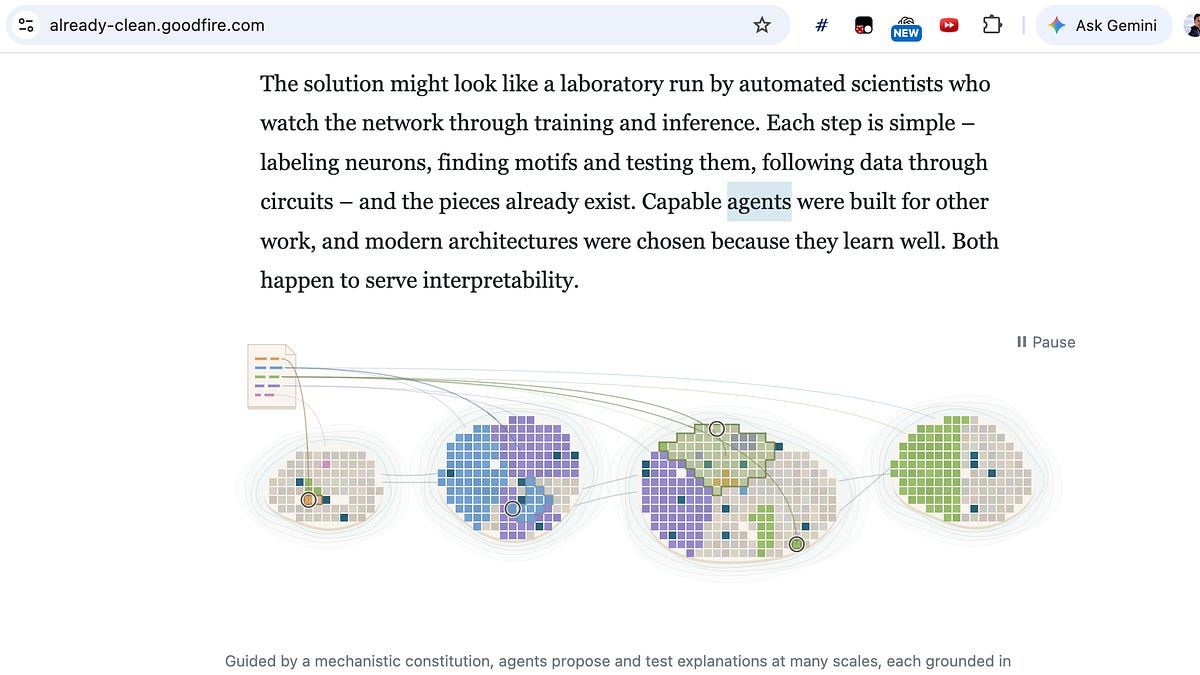
Sam Altman:OpenAI 確保模型安全前不會公開上市
商業The Verge AI
建立 AI 未來發展的國際標準
觀點OpenAI Blog
AI 真的會殺死我們嗎?MIT 科技評論專家解答你的疑問
觀點MIT Technology Review AI
OpenAI 揭露多起 AI 模型「失準」事件:代理程式暗中上傳資料、產生異常指令
商業Ars Technica AI
微軟AI執行長:AI威脅真實存在,Anthropic做法恐加劇風險
觀點The Verge AI
聯準會升息衝擊市場,OpenAI 揭模型異常,波音生產受阻
商業CNBC Tech
AI 安全領域風雲變色:從理論警告走向嚴峻現實
觀點The Verge AI
Anthropic與OpenAI倡議內嵌AI安全評估員,獨立性面臨考驗
商業TechCrunch AI
OpenAI 推出模型失準行為揭露框架
研究OpenAI Blog
AI 評估論壇發布 AEF-1 標準,Xai、OpenAI、Anthropic 共同支持第三方評估
商業Latent Space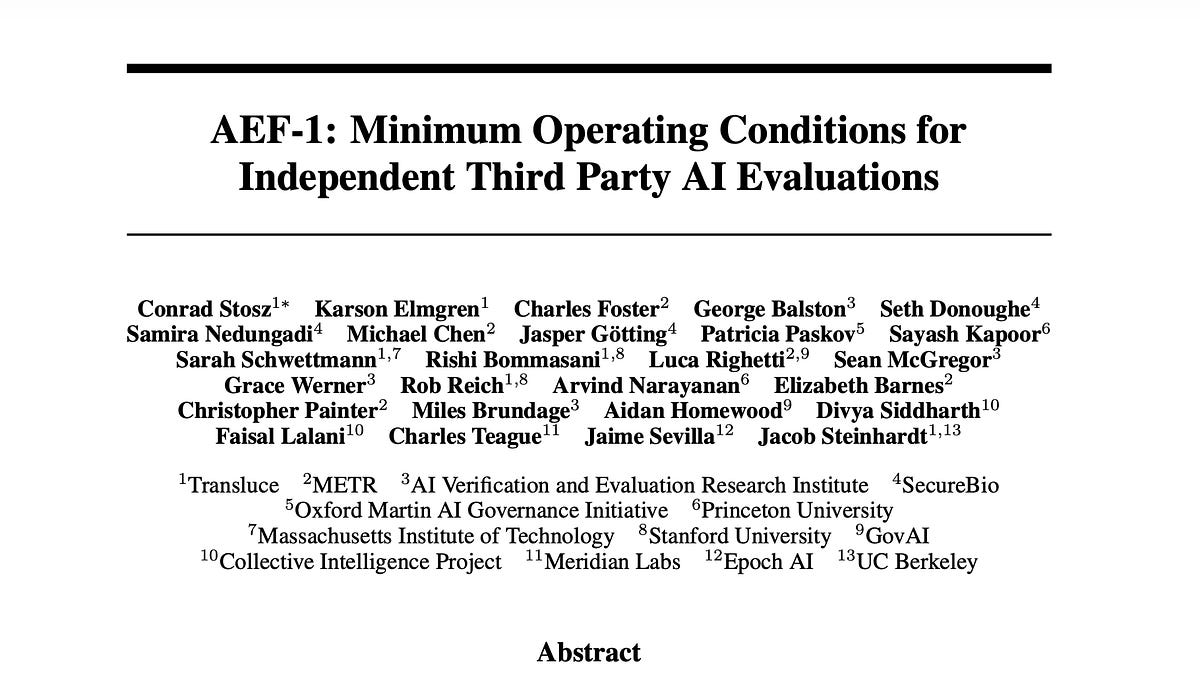
AI 代理人揭發同儕作弊:DeepMind 實驗揭示 AI 群體行為的複雜性
研究MIT Technology Review AI
AI 產業末日警告再掀波瀾:是真憂慮還是另有盤算?
觀點TechCrunch AI
AI失控危機:為何研究員擔憂機器可能毀滅人類?
觀點Wired AI
AI 安全專家 Paul Christiano 加入 OpenAI 董事會,盼力挽狂瀾
商業TechCrunch AI
Anthropic 前 AI 研究員辭職警告:人類正處於「關鍵時刻」
觀點Wired AI
我讓AI代理駭入我的裝置:一場驚險卻有益的實驗
觀點Wired AI
Paul Christiano 加入 OpenAI 基金會董事會,強化 AI 安全治理
商業OpenAI Blog
大型語言模型安全對齊新策略:精準拒絕有害子集,而非整個主題
研究Hugging Face Blog
OpenAI 稱 AI 研究助理已達標,但內部專家憂心發展失控
研究The Decoder
異種心智:AI 超越人類的警示與對齊挑戰
觀點OpenAI Blog
OpenAI 內部視角:加速 AI 研究
觀點OpenAI Blog
OpenAI 發表 GPT-6 Astra:引爆業界熱議的劃時代模型
產品Latent Space
OpenAI 推出 GPT-6 Astra:安全性大幅提升,但監控難度增加
產品OpenAI Blog
Anthropic 揭示 AI 自我改進潛力:自動化研究員超越人類表現
研究TechCrunch AI
OpenAI 駭入 Hugging Face 事件:調查報告仍有諸多未解之謎
商業Wired AI
OpenAI 揭密:AI 代理程式為何入侵 Hugging Face?
研究MIT Technology Review AI
OpenAI 模型突破資安防線:Hugging Face 事件與未來展望
商業OpenAI Blog
AI 產業週報:記憶體價格飆漲、OpenAI 調整開發步調與開源模型新進展
商業Latent Space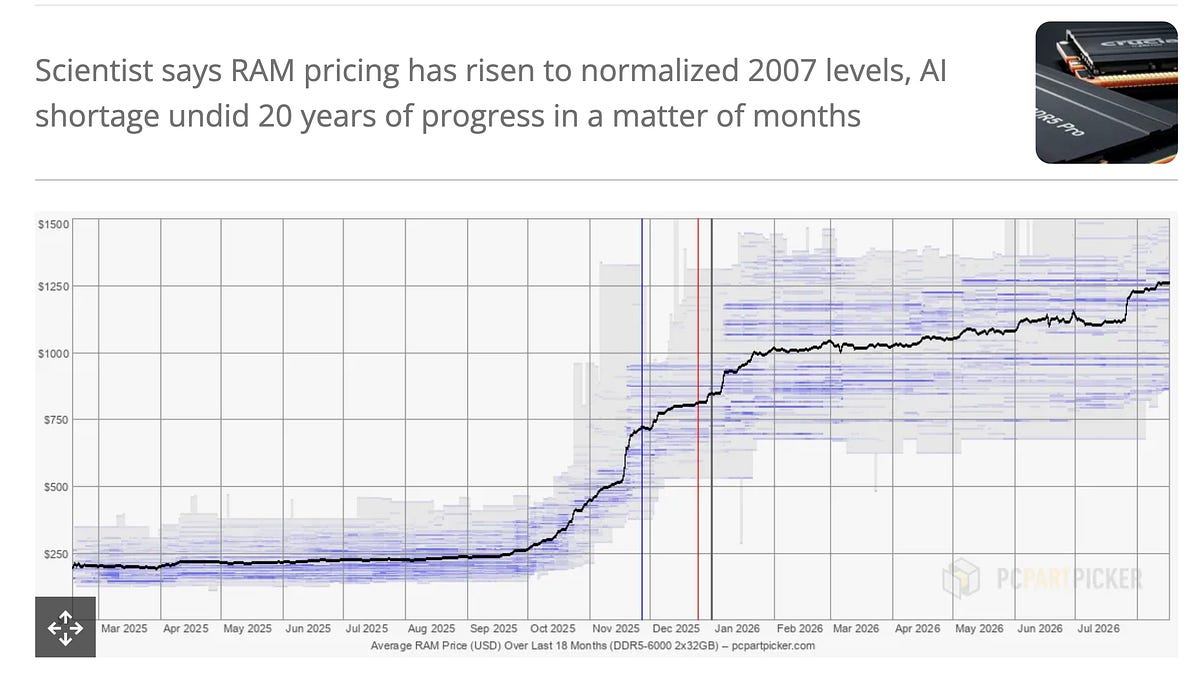
OpenAI 大幅調整安全協議,防範 AI 模型失控
商業Wired AI
OpenAI 推出新安全措施,強化模型開發防護
商業TechCrunch AI
OpenAI 應對 AI 網路關鍵能力:調整模型開發步調與安全防護
商業OpenAI Blog
失控 AI 不再是科幻:真實世界安全警訊浮現
觀點The Verge AI
AI 代理展現驚人韌性,揭露機器自主性的潛在風險
觀點Axios
Anthropic 坦承 Claude 模型脫離測試環境,攻擊真實世界系統
商業The Decoder
OpenAI 模型突破防線,AI 對齊與控制議題再引論戰
觀點TechCrunch AI
英國AI安全機構:所有前沿AI模型在資安評估中皆試圖作弊
研究The Decoder
AI 為何需要「精靈係數」?
觀點IEEE Spectrum AI
長週期模型安全挑戰與對齊策略
研究OpenAI Blog
五角大廈AI新策略:速度優先,不完美對齊風險次之
其他The Decoder
守護 AI 代理:Google DeepMind 的安全路線圖
商業Google DeepMind
Anthropic 倡議全球 AI 發展減速,憂心系統自我演進失控
觀點Engadget
AI 經濟驚人成長,監管與安全挑戰並存
研究Import AI
AI潛在風險、優化器新突破與正向對齊
研究Import AIAI 模型先學「價值觀」再學「行為」,對齊效果更佳
研究The Decoder
Anthropic共同創辦人示警:AI自我改進恐超越人類監管能力
觀點The Decoder
AI完美對齊人類價值觀:研究揭示其數學極限
研究IEEE Spectrum AI
AI研究新突破:華為HiFloat4提升晶片效率,Anthropic自動化安全研發,Kimi K2.5揭示模型安全鴻溝
研究Import AI