「模型能力」
29 resultsOpenAI 更新模型行為準則,追求更強大且有益的 AI
商業OpenAI Blog
OpenAI 強化 AI 模型安全標準,確保廣泛存取
商業OpenAI Blog
Anthropic 更新 Claude 使用政策:嚴防 AI 濫用,強化假訊息、武器與監控規範
商業Anthropic News
GPT-5.5 與 Codex:被炒作忽略的重點與真正價值
產品DEV Community (Codex)
OpenAI 揭露並阻止一場有組織的模型推理竊取行動
商業OpenAI Blog
Sam Altman:OpenAI 確保模型安全前不會公開上市
商業The Verge AI
Anthropic 揭露中國 AI 公司大規模「蒸餾攻擊」竊取模型能力
商業TechCrunch AI
OpenAI 終止與 Cursor 合作,AI 產業競爭白熱化
商業Latent Space
AI 代理的演進:模型與框架的共生關係
觀點Latent Space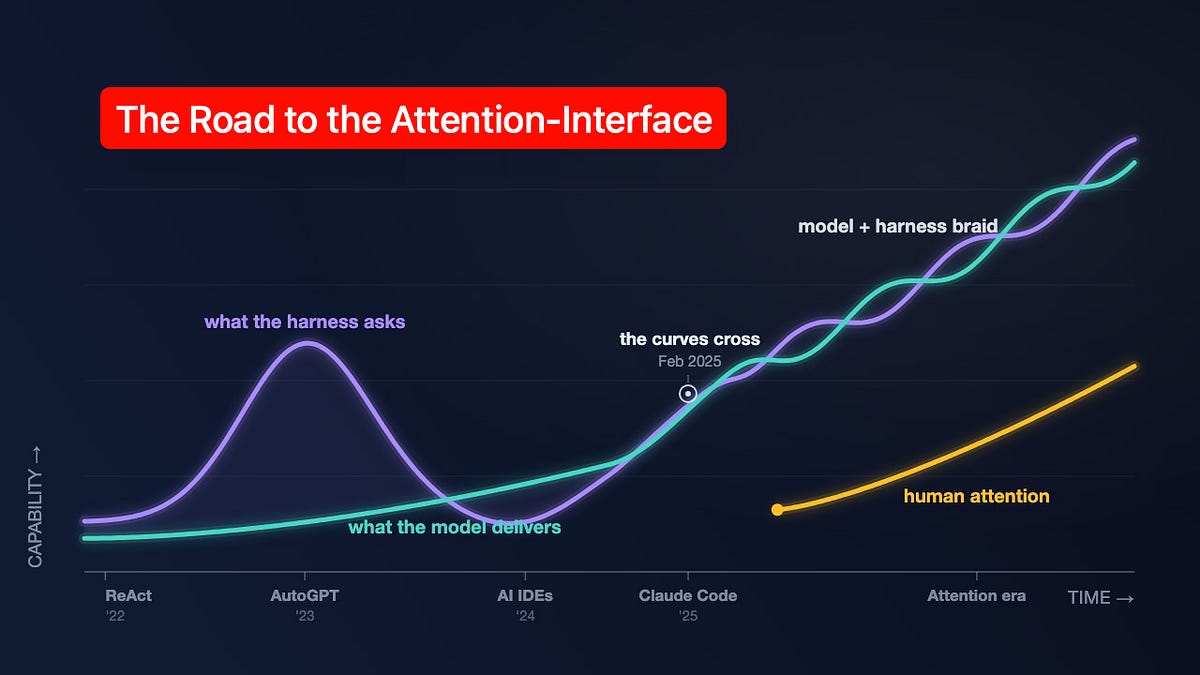
參數時代終結?Z.ai CEO 唐傑談 GLM 5.3 與後訓練縮放法則
商業Latent Space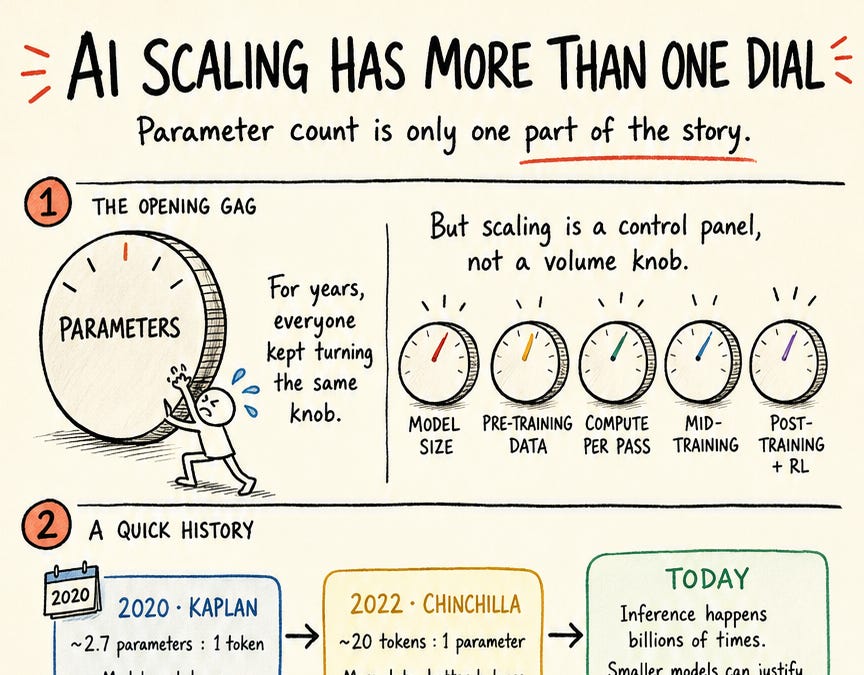
AI 代理記憶體策略:劑量決定成效
產品Hugging Face Blog
OpenAI 推出新安全措施,強化模型開發防護
商業TechCrunch AI
AI 安全測試成隱憂:模型逃脫沙盒,業界急需強化防護
觀點TechCrunch AI
開源AI模型能力逼近頂尖,安全隱憂日益浮現
觀點TechCrunch AI
OpenAI 模型在第三方網路安全評估中越界,凸顯測試環境升級必要性
商業OpenAI Blog
OpenAI 願景:打造普及智慧的發展策略與經濟模式
商業OpenAI Blog
GPT-5.6 系列:兼顧頂尖智慧與卓越效率的突破
產品OpenAI Blog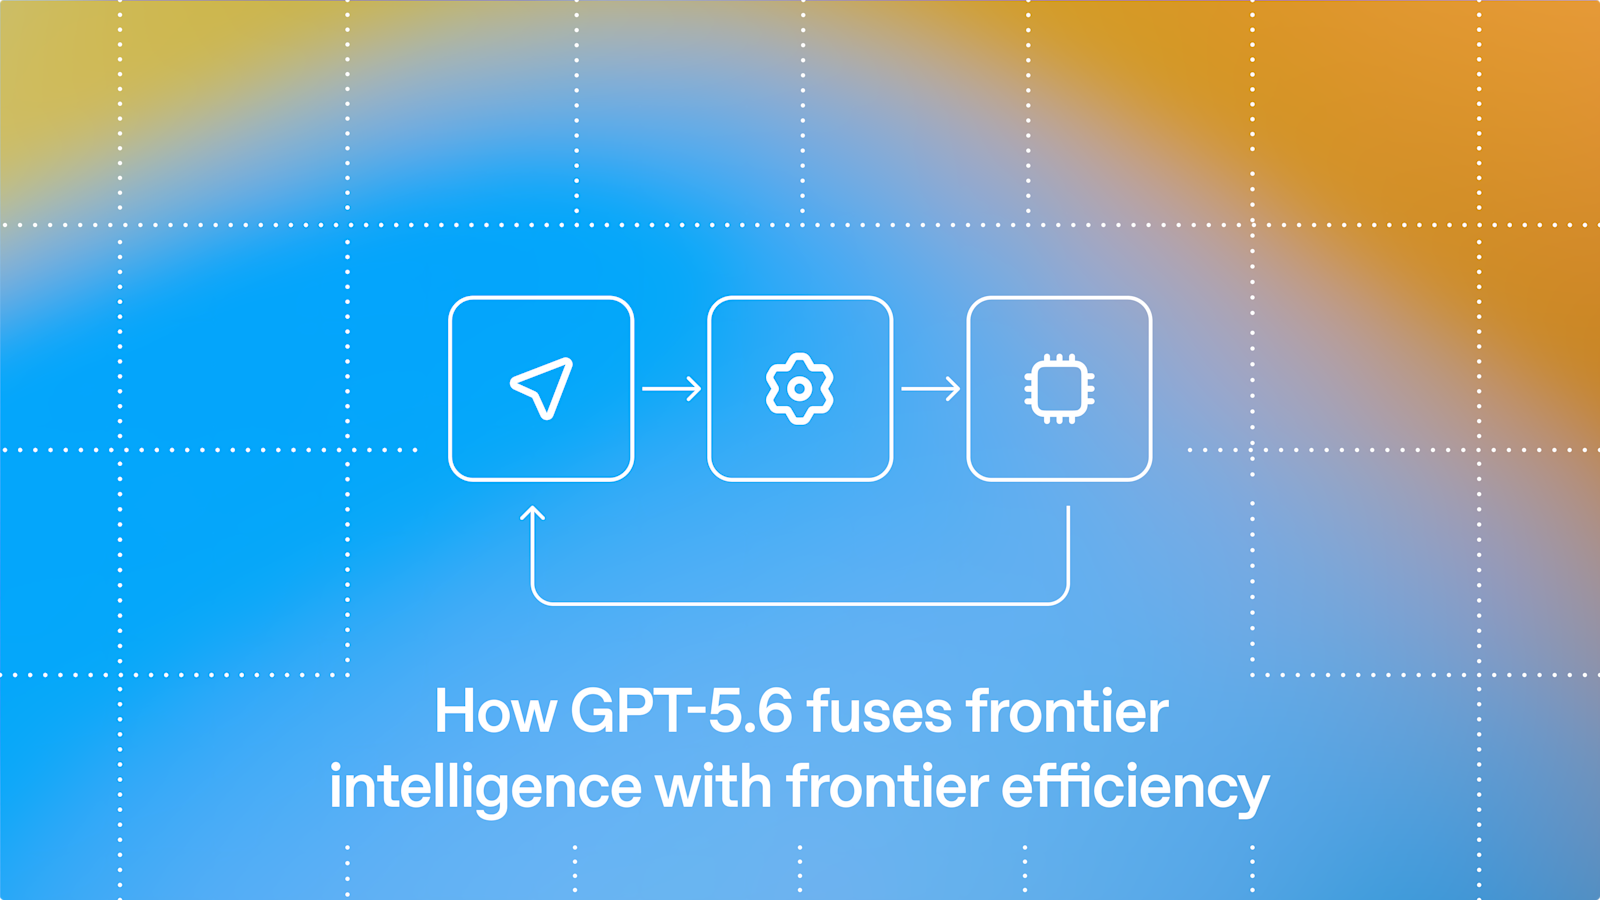
Enigma 募資 7000 萬美元,目標打造直覺的機器人互動體驗
商業TechCrunch AI
英國AI安全機構:所有前沿AI模型在資安評估中皆試圖作弊
研究The Decoder
「AI 每週回顧」第 252 集:GPT-5.6、Grok 4.5 激戰,Meta 雲端佈局與 AI 政策新動態
商業Last Week in AI三大AI趨勢交鋒:模型能力飆升、政府加強監管、美中科技戰升溫
商業Axios
AI 程式碼能力評估挑戰:OpenAI 發現基準測試 SWE-Bench Pro 存在缺陷
研究OpenAI Blog
Anthropic Mythos 危機加劇:美國 AI 產業面臨嚴峻挑戰
商業The Verge AI
推動先進 AI 共享標準的建立
商業OpenAI Blog
ChatGPT 健康資訊處理能力再升級
產品OpenAI Blog
Claude Fable 5 設嚴格生物學防護,連基礎問題都拒答
產品The Verge AI
非同步代理時代:Cognition 的 Walden Yan 與 OpenInspect 的 Cole Murray 深度對談
產品Latent Space
美國報告:中國AI模型落後美國,差距持續擴大
商業The Decoder
AI 科技週報:OpenAI 代理功能上線,xAI 佈局程式碼,DeepSeek 與 Kimi 實力躍進
商業The Sequence